Alibaba Cloud Model Studio の検索拡張生成 (RAG) 機能で、知識の取得が不完全であったり、コンテンツが不正確であったりする場合は、本トピックの提案と例を参照して RAG パフォーマンスを改善してください。
RAG ワークフロー
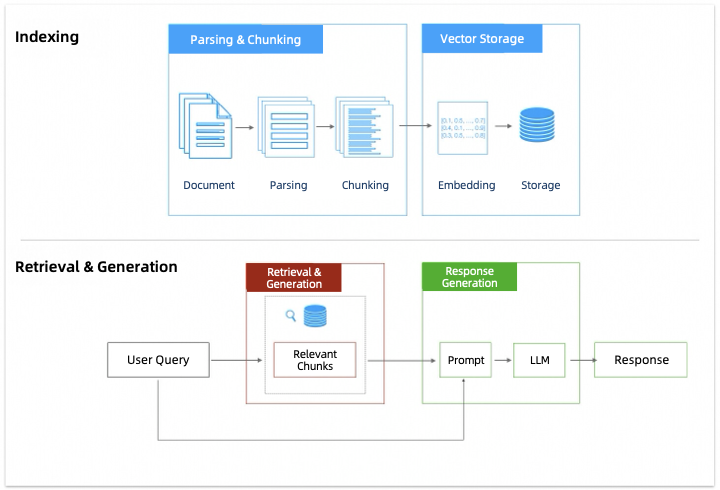
RAG(検索拡張生成)は、情報検索とテキスト生成を組み合わせた技術です。これにより、モデルが回答生成時に外部ナレッジベースからの関連情報を活用できるようになります。
そのワークフローには、解析とチャンク分割、ベクトルストレージ、取得とリコール、回答生成など、いくつかの重要なステージが含まれます。
RAG パフォーマンスの最適化
準備
まず、Model Studio ナレッジベース にインポートするドキュメントが、次の要件を満たしていることを確認してください。
- 関連知識を含む: ナレッジベースに関連情報が不足している場合、モデルが関連質問に回答できない可能性があります。これを解決するには、ナレッジベースを更新して必要な知識を追加してください。
-
Markdown フォーマットの使用(推奨): PDF ファイルは複雑なレイアウトを持つことが多く、解析結果が不良になる可能性があります。PDF を Markdown、DOC、DOCX などのテキスト形式に事前に変換してください。たとえば、DashScopeParse を使用して PDF を Markdown に変換し、その後モデルを使用してフォーマットを整理します。「Alibaba Cloud 大規模モデル ACP コース」の RAG の章をご参照ください。
ドキュメント内のイラストはどのように扱うべきですか?
ナレッジベースは、現在ドキュメント内の動画または音声コンテンツを解析できません。
- 明確な表現、合理的な構造、特殊なスタイルの不使用: ドキュメントのレイアウト も RAG パフォーマンスに大きな影響を与えます。詳細については、「RAG の効果を高めるためのドキュメントフォーマット方法」をご参照ください。
- プロンプト言語との一致: ユーザーのプロンプトが主に英語などの特定の言語で記述されている場合、ドキュメントコンテンツも同じ言語で記述されていることを確認してください。必要に応じて(例:ドキュメント内の専門用語)、2 つ以上の言語を使用できます。
-
エンティティの曖昧性解消: ドキュメント内で同一エンティティの異なる表現を統一します。たとえば、「ML」と「Machine Learning」を「Machine Learning」に標準化できます。
ドキュメントをモデルに入力し、用語を標準化するよう依頼できます。ドキュメントが長い場合は、複数の部分に分割して順次入力してください。
解析とチャンク分割
本セクションでは、RAG チャンク分割ステージを最適化するための Model Studio の設定項目のみを説明します。まず、ナレッジベースはインポートされたドキュメントを解析およびチャンク分割します。チャンク分割の主な目的は、後続のベクトル化プロセス中のノイズを減らしつつ、セマンティック整合性を維持することです。したがって、ナレッジベース作成時に選択するドキュメントチャンク分割戦略は、RAG パフォーマンスに大きな影響を与えます。チャンク分割方法が不適切だと、次の問題が発生する可能性があります。
短いチャンク | 長いチャンク | セマンティック切り捨て |
|---|---|---|
 |  |  |
短いチャンクはセマンティック情報が不足し、取得が失敗する可能性があります。 | 長いチャンクは無関係なトピックを含み、リコールプロセスでノイズや無関係な情報が返される可能性があります。 | 強制的なセマンティック切り捨てにより、リコール時にコンテンツが欠落する可能性があります。 |
- ナレッジベース作成時に、ドキュメントチャンク分割方法として インテリジェントチャンク分割 を選択します。
- ドキュメントをナレッジベースに正常にインポートした後、テキストチャンクのコンテンツを手動で確認・修正します。
インテリジェントチャンク分割
ナレッジベースに最適なテキストチャンク長を選択するのは難しい場合があります。これは、次の複数の要因に依存するためです。
- ドキュメントタイプ: 専門文献の場合、長いチャンクの方がより多くのコンテキストを保持できることが多いです。ソーシャルメディア投稿の場合、短いチャンクの方がセマンティクスをより正確に捉えられます。
- プロンプトの複雑さ: 一般に、ユーザーのプロンプトが複雑で具体的な場合は、長いチャンクが必要になることがあります。そうでない場合は、短いチャンクの方が適している場合があります。

- まず、組み込みの文区切り文字を使用してドキュメントを段落に分割します。
- 分割された段落に基づき、固定長ではなくセマンティック関連性(セマンティックチャンク分割)に基づいてチャンク境界を適応的に選択します。
チャンクコンテンツの修正
もちろん、実際のチャンク分割プロセス中にも、予期しない分割やその他の問題が発生する可能性があります(例:テキスト中の スペース がチャンク分割後に %20 として解析される場合など)。

この操作はナレッジベース内のテキストチャンクのみを変更し、データ管理(一時ストレージ)内の元のドキュメントまたはデータテーブルは変更しません。したがって、ドキュメントを再度インポートする場合は、手動での確認と修正を再度行う必要があります。
取得とリコール
本セクションでは、取得とリコールステージを最適化するための Model Studio の設定項目のみを説明します。取得とリコールステージの主な課題は、回答を含むナレッジベースから最も関連性の高いテキストチャンクを見つけることです。
| 問題タイプ | 改善戦略 |
|---|---|
| マルチターン対話シナリオで、ユーザーのプロンプトが不完全または曖昧です。 | マルチターン対話の書き換え を有効化します。ナレッジベースがユーザーのプロンプトをより完全な形に自動的に書き換えし、知識マッチングを改善します。 |
| ナレッジベースに複数のカテゴリのドキュメントが含まれています。カテゴリ A に焦点を当てた検索でも、カテゴリ B など他のカテゴリのテキストチャンクがリコール結果に含まれます。 | ドキュメントにタグを追加します。取得時に、ナレッジベースが検索前にタグで関連ドキュメントをフィルタリングします。ドキュメント検索のナレッジベースでのみ、ドキュメントへのタグ追加がサポートされています。 |
| ナレッジベースに類似の構造を持つ複数のドキュメントが含まれており(例:すべてに「特徴概要」セクションが含まれている)、ドキュメント A の「特徴概要」セクションを検索したいが、リコール結果に他の類似ドキュメントの情報が含まれます。 | メタデータ抽出 を使用します。ナレッジベースがベクトル取得前にメタデータを使用して構造化検索を実行し、ターゲットドキュメントを正確に見つけて関連情報を抽出します。ドキュメント検索のナレッジベースでのみ、ドキュメントメタデータがサポートされています。 |
| リコール結果が不完全で、すべての関連テキストチャンクが含まれていません。 | 類似度しきい値 を下げ、取得チャンク数 を増やして、以前見逃されていた情報を取得します。 |
| リコール結果に大量の無関係なテキストチャンクが含まれています。 | 類似度しきい値を上げて、ユーザーのプロンプトとの類似度が低い情報を除外します。 |
マルチターン対話の書き換え
マルチターン対話で、ユーザーが「Model Studio Phone X1」といった短いプロンプトで質問することがあります。これにより、取得時に必要なコンテキストが不足し、RAG システムが正確に動作しない可能性があります。その理由は次のとおりです。
- スマートフォン製品は、複数の世代が同時に販売されていることがよくあります。
- 同一世代の製品でも、メーカーは通常 128 GB や 256 GB など、さまざまなストレージオプションを提供しています。 ...

タグによるフィルタリング
本セクションは、ドキュメント検索のナレッジベースにのみ適用されます。音楽アプリを使用する際、アーティストで曲をフィルタリングして、そのアーティストのすべての曲を素早く見つけることができます。 同様に、非構造化ドキュメントにタグを追加すると、追加の構造化情報が導入されます。ナレッジベースから取得する際、アプリケーションはまずタグでドキュメントをフィルタリングでき、取得の精度と効率が向上します。 Model Studio では、タグを設定する方法が次の 2 つあります。
- ドキュメントアップロード時にタグを設定: コンソールでの手順については、「データのインポート」をご参照ください
-
Data Management ページでタグを編集: アップロード済みのドキュメントについて、ドキュメントの右側にある ラベル をクリックしてタグを編集できます

-
Model Studio アプリケーションを API で呼び出す 際、
tagsリクエストパラメーターでタグを指定できます。 -
コンソールでアプリケーションを編集する際にタグを設定します。ただし、この方法は エージェントアプリケーション にのみ適用されます。
この設定は、このエージェントアプリケーションに対する以降のすべてのユーザー質問と回答に適用されます。

メタデータ抽出
本セクションは、ドキュメント検索のナレッジベースにのみ適用されます。テキストチャンクにメタデータを埋め込むことで、各チャンクのコンテキストが効果的に強化されます。特定のシナリオでは、この方法によりドキュメント検索のナレッジベースにおける RAG パフォーマンスが大幅に向上することがあります。 次のシナリオを考えてみましょう。 ナレッジベースには多数のスマートフォン製品マニュアルが含まれています。ドキュメント名は端末モデル(例:Model Studio X1、Model Studio Zephyr Z9)であり、すべてのドキュメントに「特徴概要」の章が含まれています。 このナレッジベースでメタデータが有効になっていない場合、ユーザーは取得のために次のようなプロンプトを入力する可能性があります。
取得テストの結果はランキングのみを保証しますが、絶対的な類似度スコアは参考値です。絶対値の差が小さい場合(5% 以内)、リコール確率は同等とみなせます。


- プロンプトからメタデータ {"key": "name", "value": "Model Studio Phone X1"} を抽出します。
- 抽出されたメタデータに基づき、「Model Studio Phone X1」メタデータを含むすべてのテキストチャンクを見つけます。
- 次に、ベクトル(セマンティック)検索を実行して、最も関連性の高いテキストチャンクを見つけます。

類似度しきい値
ナレッジベースがユーザーのプロンプトに関連するテキストチャンクを見つけた後、まずそれらを カスタムパラメーター設定(ナレッジベース作成時に設定)で設定された Rank モデルに送信して並べ替えます。次に、類似度しきい値を使用して並べ替えられたテキストチャンクをフィルタリングします。しきい値を超える類似度スコアを持つテキストチャンクのみがモデルに提供されます。


取得テストの推奨手順 | |
|  |
取得チャンク数
取得チャンク数は、マルチチャネルリコール戦略における K 値です。類似度しきい値フィルタリング後、テキストチャンク数が K を超える場合、システムは類似度スコアが最も高い K 個のテキストチャンクをモデルに提供します。このため、K 値が不適切だと、RAG が正しいテキストチャンクを見逃し、モデルが完全な回答を生成できなくなる可能性があります。
たとえば、ユーザーが次のプロンプトで情報を取得します。
多くの実験により、「リスト...」、「要約...」、「X と Y を比較...」などのシナリオでは、上位 10 件または上位 5 件だけを提供するよりも、より多くの高品質なテキストチャンク(例:K=20)をモデルに提供する方が効果的であることが示されています。これによりノイズが混入する可能性がありますが、テキストチャンクの品質が高ければ、高性能なモデルは通常その影響を処理できます。Model Studio でアプリケーションを編集する際に、取得されたチャンクの数 を調整できます。

回答生成
本セクションでは、回答生成ステージを最適化するための Model Studio がサポートする設定項目のみを説明します。この時点で、モデルはユーザーのプロンプトとナレッジベースから取得されたコンテンツに基づいて最終的な回答を生成できます。ただし、返された結果が期待通りでない可能性があります。
問題タイプ | 改善戦略 |
|---|---|
モデルが知識とユーザーのプロンプトの関係を理解できず、つなぎ合わせたような回答になります。 | 適切なモデルを選択することで、知識とユーザーのプロンプトとの関係を効果的に理解できます。 |
返された結果が命令に従っていなかったり、包括的でなかったりします。 | |
返された結果の正確性が不十分で、モデル自身の一般的な知識が含まれており、ナレッジベースに完全に根ざしていません。 | 拒否を有効化するして、回答をナレッジベースから取得された知識のみに制限します。 |
類似のプロンプトに対して、結果を一貫性のあるものにするか、多様なものにするかを制御したい場合があります。 |
モデル選択
さまざまな大規模モデルは、命令の遵守、言語サポート、長文処理、知識理解などの分野で異なる能力を持っています。これにより、次の状況が発生する可能性があります。
モデル A は取得された知識とプロンプトの関係を効果的に理解できず、生成された応答がユーザーのプロンプトに正確に対応できませんでした。モデル B(パラメーター数が多い、または専門的な能力が強い)に切り替えることで、この問題を解決できる可能性があります。
Model Studio でアプリケーションを編集する際に、実際のニーズに基づいて Select Model できます。

Qwen-Max や Qwen-Plus など)を選択してください。これらの商用大規模モデルは、オープンソース版と比較して最新の機能と改善が提供されています。
- シンプルな情報クエリや要約の場合は、パラメーター数が少ない大規模モデル(
Qwen-Turboなど)で十分です。 - RAG に複雑な論理的推論を実行させたい場合は、パラメーター数が多く推論能力が強い大規模モデル(
Qwen-Maxなど)を選択してください。 - クエリで多数のドキュメントスニペットを参照する必要がある場合は、コンテキスト長が長い大規模モデル(
Qwen-Plusなど)を選択してください。 - 法律分野などの専門分野向けに RAG アプリケーションを構築する場合は、その特定の分野向けにトレーニングされたモデル(
Qwen-Legalなど)を使用してください。
プロンプトテンプレートの最適化
取得された知識の使用方法をガイドするプロンプトを設計することで、モデルの動作に影響を与え、RAG パフォーマンスを向上させることができます。
以下に、一般的な最適化方法を 3 つ紹介します。
方法 1: 出力コンテンツの制約
プロンプトテンプレートにコンテキスト情報、命令、期待される出力フォーマットを提供してモデルに指示できます。たとえば、次の出力命令を追加できます。
| プロンプトテンプレート | 結果 |
|---|---|
 | |
 |
${documents} 変数とプロンプトを明確に分離してください。
さらに、最良の結果を確保するには、${documents} 変数がプロンプトテンプレート内に1 回のみ出現することを確認してください。参考として、左側の正しい例をご覧ください。
拒否
Model Studio アプリケーションの結果をナレッジベースから取得された知識のみに基づき、モデル自身の一般的な知識の影響を除外したい場合は、アプリケーション編集時に回答範囲を ナレッジベースのみ に設定できます。
ナレッジベースで関連知識が見つからないケースについては、固定された自動返答を設定することもできます。
回答範囲: ナレッジベース + LLM 知識 | 回答範囲: ナレッジベースのみ |
 |  |
Model Studio アプリケーションの結果は、ナレッジベースから取得された知識とモデル自身の一般的な知識を組み合わせたものになります。 | Model Studio アプリケーションの結果は、ナレッジベースから取得された知識のみに基づいたものになります。 |

申し訳ありませんが、関連するスマートフォンモデルは見つかりませんでした。
成功したクエリ | 失敗したクエリ |
|---|---|
 |  |
モデルパラメーター
類似のプロンプトに対してモデルが一貫性のある応答を提供するか、多様な応答を提供するかを制御したい場合は、アプリケーション編集時に パラメータ設定 を変更してモデルパラメーターを調整できます。

- 多様なテキストは、創造的なライティング(小説や広告コピーなど)、ブレインストーミング、チャットアプリケーションのシナリオに適しています。
- 決定論的なテキストは、明確な回答を必要とするシナリオ(問題分析、多肢選択問題、事実確認など)や、正確な表現が求められるシナリオ(技術文書、法的文書、ニュース記事、学術論文など)に適しています。
よくある質問
RAG の効果を高めるためのドキュメントフォーマット方法
RAG の効果を高めるためのドキュメントフォーマット方法
ドキュメントコンテンツレイアウトの推奨事項
- 明確な見出しレベルを使用します。各見出しの下のコンテンツが明確で自己完結的であるようにします。
- ウォーターマークを避けてください。
- リストの中間項目の下にリストレベルをネストしないでください。
- 可能であればテーブルや画像を避けます。複雑なテーブルは解析品質に悪影響を及ぼす可能性があります。


- 各見出しの下のコンテンツが明確で比較的独立しています。
- ウォーターマークがありません。
- 見出しの下にリストが表示されますが、ネストリストは含まれていません。
- テーブルや画像がありません。