

ナレッジベースは、非公開データや最新情報で大規模言語モデル (LLM) を補強する機能です。検索拡張生成 (RAG) を利用することで、LLM は応答を生成する前に、まずナレッジベースから関連コンテンツを取得し、回答の精度を高めます。
専用ナレッジベースがないアプリケーション 専用のナレッジベースがない場合、LLM はドメイン固有の質問に正確に回答できません。 例えば、ユーザーがチャットインターフェイスで「予算 3,000 元以内で、Alibaba Cloud Model Studio から最高のカメラ付きスマートフォンを選んでください」と送信した場合、AI アシスタントは関連するナレッジベースがないため、正確な製品推奨を提供できません。 | 専用ナレッジベースがあるアプリケーション 専用のナレッジベースがあれば、LLM はドメイン固有の質問に正確に回答できます。  |
サポートされるモデル
以下のモデルはナレッジベースと共に使用できます。ナレッジベースを使用するための Qwen の設定
- Qwen-Max/Plus/Turbo
- QwenVL-Max/Plus
- Qwen オープンソースバージョン (例:Qwen2.5)
利用可能なモデルの最新リストについては、アプリケーション作成時に [アプリケーション管理] ページをご参照ください。
クイックスタート
このクイックスタートでは、「Alibaba Cloud Model Studio スマートフォン」を例に、ドメイン固有の質問に答えるためのノーコード LLM Q&A アプリケーションの構築方法を示します。
1. ナレッジベースの構築
- [ナレッジベース] ページに移動し、ナレッジベースの作成 をクリックします。 ナレッジベース名 と ナレッジベース説明 を入力し、他の設定はデフォルト値のままにして、次へ をクリックします。
- [デフォルトカテゴリ] を選択して Alibaba Cloud Model Studio Phone Series Product Introduction.docx ファイルをアップロードし、次へ、インポート完了 の順にクリックします。
2. ビジネスアプリケーションとの統合
ナレッジベースを作成した後、同じワークスペース内の Alibaba Cloud Model Studio アプリケーションまたは外部アプリケーションと関連付けて、取得リクエストを処理できます。
- エージェントアプリケーション
- ワークフローアプリケーション
- 外部アプリケーション
- [アプリセンター] ページに移動し、エージェントアプリケーションを見つけ、そのカードの 設定 をクリックし、アプリケーションのモデルを選択します。
-
[ドキュメントナレッジベース] の横にある [+] アイコンをクリックして、先ほど作成したナレッジベースを追加します。類似度のしきい値と重みはデフォルト値のままでかまいません。
(オプション) 類似度のしきい値:取得結果のフィルタリング
ナレッジベースはセマンティック検索を使用して、キーワードが一致しなくても、非公開データやファイル内の概念的に関連するテキストを検索します。例えば、ユーザーが次のクエリを送信したとします:写真撮影に最適な Alibaba Cloud のスマートフォンはどれですか?実際の回答 (例:「Qwen Vivid 7...」) には、クエリのキーワードは含まれていません。以下の表では、キーワード類似度は Jaccard 係数 を用いて計算され、セマンティック類似度は
text-embedding-v4モデルによって計算された コサイン類似度
類似度のしきい値: この値より高いセマンティック類似度スコアを持つテキストのみが取得されます。このしきい値を高く設定しすぎると、関連するテキストが除外される可能性があります。取得されたテキスト
キーワード類似度
セマンティック類似度
Qwen Vivid 7:スマート写真撮影の新しい体験
0
0.43
Alibaba Cloud Model Studio Ace Ultra:ゲーマーのための選択
0.17
0.32
Alibaba Cloud Model Studio Flex Fold+:折りたたみ画面の新時代
0.25
0.24
(オプション) 重み:複数のナレッジベースからの取得順序への影響
エージェントアプリケーションが複数のナレッジベースに関連付けられている場合、情報源の重要度に基づいてそれぞれに重みを割り当てることができます。複数ソースからの取得中に、異なるナレッジベースのチャンクが同じ類似度スコアを持つ場合、システムはより高い重みを持つナレッジベースのチャンクを優先します。- 主な制限: 重みは同じタイプのナレッジベース間でのみ有効です。例えば、ドキュメント検索ナレッジベースの重みは、データクエリナレッジベースの取得順序には影響しません。逆も同様です。
- 仕組み: システムはまず、各ナレッジベースのコンテンツとユーザークエリとの関連性を計算し、最も関連性の高いチャンクを特定します。次に、各チャンクの類似度スコアに、対応するナレッジベースの重みを掛け合わせます。これらの重み付けされたスコアに基づいて再ランキングした後、結果は LLM にコンテキストとして提供され、重み付けされたスコアが高いチャンクが最終的な回答で優先されるようにします。
-
右側の入力ボックスに質問を入力します。LLM はナレッジベースを使用して回答を生成します。
例:「3,000 元以内で最高のカメラを持つ Alibaba Cloud Model Studio スマートフォンを選ぶのを手伝ってください。」
バッチ生成戦略: エージェントアプリケーションにナレッジベースから大量のコンテンツ (クイズの質問や要約など) を生成させる必要がある場合、1 回の LLM 応答の出力長が限られているため、1 回のリクエストでは要求された数より少ない項目しか返されないことがあります。リクエストを約 30 項目ずつの複数のバッチに分割し、複数ターンにわたって完了させてください。例えば、最初に「ナレッジベースに基づいて質問 1-30 を生成」と送信し、そのバッチが完了したら「続けて質問 31-60 を生成」と送信します。測定された参考値:100 問のリクエスト 1 回では約 24 問しか返されませんでしたが、30 問ずつの 3 バッチでは各バッチで 30 問すべてが返され、合計 90 問になりました。実際に生成される項目数は、選択したモデルやコンテンツの長さによって異なるため、ご自身のテスト結果を最終的な参考としてください。
3. RAG パフォーマンスの最適化 (オプション)
Q&A プロセスから不完全または不正確な結果を受け取った場合は、「RAG パフォーマンスの最適化」をご参照ください。
操作手順
[ナレッジベース] ページでは、現在のワークスペース内のすべてのナレッジベースを表示および管理できます。
ナレッジベース ID: 各ナレッジベースの ID は、API 呼び出しに使用されます。
- ナレッジベースの作成
- ナレッジベースの更新
- ナレッジベースの編集
- ナレッジベースの削除
- 構成の変更
- ヒットテスト
- ナレッジベースページで、ナレッジベースの作成 をクリックします。
-
基本情報
ユースケースに応じて ナレッジベースの種類 を選択します。1 つのナレッジベースでサポートされるタイプは 1 種類のみです。[ドキュメント検索] タイプを選択した場合は、[ユースケース] として 基本的なドキュメント Q&A、リッチテキスト応答 のいずれかを選択する必要もあります。
- 基本的なドキュメント Q&A: プレーンテキストドキュメントのセマンティック検索に最適です。
- リッチテキスト返信: テキストと画像の両方を含む応答が必要なユースケースに最適です。
ナレッジベースのタイプは、ナレッジベース作成後に変更することはできません。
-
ドキュメント検索
-
ユースケース:
- 社内ドキュメントや製品マニュアルなど、非構造化データからの情報取得に最適です。非構造化データとは、事前定義されたデータモデルやスキーマで整理されておらず、テキスト、テーブル、画像を含むことができる情報です。
- ご利用のファイルにアプリケーションが応答に含めたい画像が含まれている場合は、[ドキュメント検索] を選択します。
-
データソース: ローカルファイルをアップロードするか、Object Storage Service (OSS) からインポートできます。
ドキュメント検索の作成
-
データの選択: ナレッジベースのデータソース (ファイルまたはコンテンツ) を指定します。システムはソースコンテンツをナレッジベースにインポートして取得します。[ローカルアップロード] または [クラウドインポート] (既存のカテゴリまたはファイルを選択) を使用できます。
-
ローカルアップロード: ご利用のコンピューターから直接ファイルをアップロードします。下の折りたたみパネルを展開して、[解析メソッド] の選択方法を確認してください。
解析メソッド
ニーズに応じて解析ストラテジーを設定してください。どのオプションを選択すればよいかわからない場合は、デフォルト設定を使用することをお勧めします。- ドキュメント解析: ファイル内の図やチャートを解析しません。これは最速の解析メソッドです。10~20 ページのプレーンテキストドキュメントは、通常、数秒から 1 分以内で解析されます。
- インテリジェントドキュメント解析: ファイル内の図からテキストを認識して抽出し、テキスト要約を生成します。これらの要約は、他の非画像コンテンツとともにチャンク化され、取得のためにベクトル化されます。このメソッドは比較的高速です。図を含む 10〜20 ページのドキュメントは、通常 1〜5 分で解析されます。
- LLM 解析: Qwen-VL モデルを使用するアプリケーションが、ファイル内のイラストやチャートの内容に関する質問に回答できるようにします。このコンテンツの認識と理解を有効にするには、大モデルドキュメント解析 を選択します。このメソッドは深い理解のために LLM を呼び出すため、チャートを含む 10 ~ 20 ページのドキュメントの解析には通常 2 ~ 10 分かかります。
- Qwen-VL 解析: 画像ファイル専用に設計されています。Qwen-VL モデルを指定し、プロンプトを提供して、画像レイアウトと要素の認識と抽出をガイドできます。単一の画像は、通常、数秒から 1 分以内に解析されます。
- クラウドインポート: Object Storage Service (OSS) から既存のファイルをインポートします。
-
ローカルアップロード: ご利用のコンピューターから直接ファイルをアップロードします。下の折りたたみパネルを展開して、[解析メソッド] の選択方法を確認してください。
-
インデックス設定: インポートされたデータの処理方法と保存方法を定義し、取得パフォーマンスに直接影響します。
以下の設定のうち、AnalyticDB for PostgreSQL (ADB-PG) を使用したベクトルストレージのみが料金を発生させる可能性があります。他のすべての設定は無料です。
- メタデータ抽出
- Excel ヘッダーの組み立て
- チャンク化メソッド
- 複数ターン会話の書き換え
- 埋め込みモデル
- 再ランキングモデル
- 類似度のしきい値
- 最大再現数
- ベクトルストレージ
メタデータは、非構造化データの追加属性で構成され、キーと値のペアとしてチャンクに統合されます。- 目的: メタデータはチャンクに重要なコンテキストを提供し、ナレッジベースの取得精度を大幅に向上させることができます。例えば、ファイル名が製品名である何千もの製品概要ファイルを含むナレッジベースを考えます。ユーザーが「製品 A の機能概要」を検索したとき、すべてのファイルの本文に「機能概要」が含まれているが、「製品 A」に言及しているものがない場合、ナレッジベースは多くの無関係なチャンクを取得する可能性があります。しかし、製品名をすべてのチャンクにメタデータとして追加すると、ナレッジベースは「製品 A」に関連し、かつ「機能概要」を含むチャンクを正確にフィルタリングできます。これにより、取得精度が向上し、LLM の入力トークン消費量が削減されます。
- 使用法: API を使用してアプリケーションを呼び出す際、
metadata_filterリクエストパラメーターでmetadataを指定できます。アプリケーションがナレッジベースから情報を取得する際、まず指定されたmetadataに基づいて関連ファイルをフィルタリングします。 - 注意: ナレッジベース作成後にメタデータ抽出を設定することはできません。
メタデータ設定
メタデータ抽出を有効にし、設定 をクリックして、ナレッジベース内のすべてのファイルに均一またはパーソナライズされたメタデータをアタッチします。チャンク化の際に、各ファイルのメタデータはそれぞれのチャンクに統合されます。新しいメタデータテンプレート
値の抽出メソッド-
定数: ナレッジベース内のすべてのファイルに固定の属性をアタッチします。
前述の例で示したように、ナレッジベース内のすべてのファイルの著者が同じ場合、
authorという名前のフィールドに定数を設定できます。 -
変数: ナレッジベース内の各ファイルに可変の属性をアタッチします。現在サポートされている属性は
file_nameとcat_nameです。file_nameを選択すると、Alibaba Cloud Model Studio はファイルの名前をそのメタデータにアタッチします (前述の例を参照)。cat_nameを選択すると、Alibaba Cloud Model Studio はファイルを含むカテゴリの名前をファイルのメタデータにアタッチします。 -
LLM: システムはファイルの内容を設定された [エンティティの説明] ルールと照合し、関連情報を抽出してメタデータ属性としてアタッチします。
前述の例のメタデータテンプレートで示したように、各ファイルに現れるすべての年をファイル属性として抽出するには、
[エンティティの説明] 入力ボックスにdateという名前の LLM フィールドを設定できます。エンティティの説明は次のように設定されます:日付情報、年のみを抽出と入力し、[OK] をクリックします。 -
正規表現: システムは、ナレッジベース内の各ファイルのテキストコンテンツを指定された正規表現と照合します。式に一致するコンテンツが抽出され、ファイルのメタデータに属性として追加されます。
上記の例のメタ情報テンプレートで示したように、各ファイルに現れるすべてのリファレンス (リファレンスが「《」で始まり「》」で終わる任意のテキストであると仮定) を抽出する必要がある場合、
正規表現の値をreferenceという名前の正規表現フィールドを設定できます。正規表現は次のように設定されます:《.*?》に設定します。 -
キーワード検索:システムは各ファイルを検索してプリセットされたキーワードを探し、一致したキーワードをファイルのメタデータに属性として追加します。
例えば、前述の例のメタデータテンプレートでは、プリセットされたキーワードは次のとおりです:
ファイルには「融資」「産業」「グリーン」「資本」のキーワードしか含まれていないため、システムはこれら 4 つのキーワードのみをファイルの
keywords属性の値として抽出します。
視覚理解の作成
[視覚理解 (リッチテキストドキュメント)] ユースケースを選択すると、ナレッジベースは従来のチャンク化メソッドの代わりに、マルチモーダル埋め込みモデルを使用してドキュメントを視覚的に理解し、元のレイアウト情報を保持します。ファイル形式の制限
[データの選択] タブのファイルアップロードエリアで、[フォーマット要件の表示] にカーソルを合わせると、要件が表示されます。インデックス設定の違い
視覚理解ユースケースのインデックス設定は、基本的なドキュメント Q&A のものとは異なります:- 埋め込みモデル: qwen3-vl-embedding モデルが自動的に選択され、作成後に変更することはできません。
- 複数ターン会話の書き換え: 有効または無効にできます。
- 類似度のしきい値: デフォルトは 0.20 です。
- 最終的な最大再現数: デフォルトは 5 です。
- チャンク化メソッド: 視覚理解では、インテリジェントチャンク化やカスタムチャンク化などの従来のチャンク化メソッドは使用しません。代わりに、視覚インデックスに基づいてドキュメントページ全体を理解します。
編集制限
- 埋め込みモデル (qwen3-vl-embedding) とベクトルストレージタイプ (組み込み) は、作成後に変更することはできません。
- ナレッジベースのエディションは、1 日に 1 回しか変更できません。
-
データの選択: ナレッジベースのデータソース (ファイルまたはコンテンツ) を指定します。システムはソースコンテンツをナレッジベースにインポートして取得します。[ローカルアップロード] または [クラウドインポート] (既存のカテゴリまたはファイルを選択) を使用できます。
-
ユースケース:
-
データクエリ
-
ユースケース:
- FAQ、製品データ、または人事情報のクエリ用アシスタントなど、構造化データ (事前定義されたテーブルスキーマに従って整理されたデータ) に基づく Q&A システムの構築に最適です。
-
データが完全な FAQ の質問と回答のペアで構成されている場合は、[データクエリ] を選択します。例えば、Excel ファイルに
質問と回答の 2 つの列が含まれている場合、データクエリナレッジベースは質問列を取得に使用し、回答列を LLM の応答のコンテキストとして使用できます。この列固有の処理は、ドキュメント検索ナレッジベースタイプでは利用できません。
- 複数の Excel ファイルをインポートできますが、それらのテーブルスキーマは同一である必要があります。
-
データソースの統合: ローカルの XLS または XLSX ファイルをアップロードできます。
データクエリの作成
-
データの選択: ナレッジベースのデータソース (ファイルまたはコンテンツ) を指定します。システムはソースコンテンツをナレッジベースにインポートして取得します。[ローカルアップロード] または [クラウドインポート] を使用できます。
データソースはナレッジベース作成後に変更することはできません。1 つのナレッジベースは 1 つのデータソースのみをサポートします。
- ローカルアップロード: ご利用のコンピューターから XLS または XLSX 形式のデータテーブルをアップロードします。最初の行はテーブルヘッダーである必要があります。
- クラウドインポート (データテーブルの選択): Alibaba Cloud Model Studio から既存のデータテーブルを選択します。
-
インデックス設定: インポートされたデータの処理方法と保存方法を定義し、取得パフォーマンスに直接影響します。
以下の設定のうち、AnalyticDB for PostgreSQL (ADB-PG) を使用したベクトルストレージのみが料金を発生させる可能性があります。他のすべての設定は無料です。
- 取得と返信の設定
- 複数ターン会話の書き換え
- 埋め込みモデル
- 再ランキングモデル
- 類似度のしきい値
- 最大再現数
- ベクトルストレージ
- 検索すること:有効にすると、ナレッジベースはこの列を対象に取得を実行します。
- モデルを使用して生成: 有効にした場合、この列からの取得結果は、応答生成のコンテキストとして LLM に提供されます。 たとえば、「名前」、「性別」、「役職」、「年齢」の列に対して 検索すること を有効にし、「名前」と「役職」の列に対してのみ モデルを使用して生成 を有効にした場合、ナレッジベースは 4 つすべての列から取得します。 ただし、取得されたデータの「名前」と「役職」の列のコンテンツのみが、その応答のコンテキストとして LLM に提供されます。 「年齢」列がモデルの応答で有効になっていないため、このナレッジベースに関連付けられた LLM は、「張三の年齢は?」という質問には回答できません。
-
データの選択: ナレッジベースのデータソース (ファイルまたはコンテンツ) を指定します。システムはソースコンテンツをナレッジベースにインポートして取得します。[ローカルアップロード] または [クラウドインポート] を使用できます。
-
ユースケース:
-
画像 Q&A
-
ユースケース:
- 製品発見アシスタントや視覚 Q&A アシスタントなど、画像による検索や画像とテキストによる検索をサポートするマルチモーダル取得アプリケーションの構築に最適です。
-
データソースの統合: ローカルの XLS または XLSX ファイルをアップロードできます。
XLS および XLSX ファイルには、画像インデックスを構築するために公開アクセス可能な画像 URL が含まれている必要があります。詳細については、以下の作成手順をご参照ください。
画像 Q&A の作成
-
データの選択: 取得のためにナレッジベースにインポートするデータソース (ファイルまたはコンテンツ) を指定します。[ローカルアップロード] または [クラウドインポート] (データコネクタから既存のデータテーブルを選択) を使用できます。
データソースは作成後に変更できず、1 つのナレッジベースは 1 つのデータソースのみをサポートします。
-
ローカルアップロード: ご利用のコンピューターから直接 XLS または XLSX 形式のデータテーブルをアップロードします。
- フィールド要件: データテーブルには、画像インデックスを生成するために
image_urlタイプのフィールドが少なくとも 1 つ含まれている必要があります。 - 構築プロセス: ナレッジベースは
image_urlフィールドの画像 URL にアクセスし、視覚的特徴を抽出してベクトルに変換し、保存します。 - 取得プロセス: ナレッジベースは、ユーザーがアップロードした画像から生成されたベクトルを、保存されている画像ベクトルと比較し、最も関連性の高いレコードを返します。
- フィールド要件: データテーブルには、画像インデックスを生成するために
- クラウドインポート (データテーブルの選択): Alibaba Cloud Model Studio のアプリケーションデータから既存のデータテーブルを選択します。
-
ローカルアップロード: ご利用のコンピューターから直接 XLS または XLSX 形式のデータテーブルをアップロードします。
-
インデックス設定: インポートされたデータの処理方法と保存方法を定義し、取得パフォーマンスに直接影響します。
以下の設定のうち、AnalyticDB for PostgreSQL (ADB-PG) を使用したベクトルストレージのみが料金を発生させる可能性があります。他のすべての設定は無料です。
- 取得と返信の設定
- 複数ターン会話の書き換え
- 埋め込みモデル
- 再ランキングモデル
- 類似度のしきい値
- 最大再現数
- ベクトルストレージ
- 検索すること: 有効にした場合、ナレッジベースはこの列で取得を行います。
- モデルを使用して生成: 有効にすると、この列からの取得結果が、応答生成のコンテキストとして LLM に提供されます。 たとえば、"Name"、"Gender"、"Position"、"Age" の列に対して 検索すること を有効にし、"Name" と "Position" の列に対してのみ モデルを使用して生成 を有効にした場合、ナレッジベースは 4 つすべての列から取得します。 ただし、取得されたデータのうち "Name" と "Position" の列のコンテンツのみが、その応答のコンテキストとして LLM に提供されます。 「年齢」列はモデル応答に対して有効になっていないため、このナレッジベースに関連付けられた LLM は「田中太郎の年齢は?」という質問に答えることができません。
-
データの選択: 取得のためにナレッジベースにインポートするデータソース (ファイルまたはコンテンツ) を指定します。[ローカルアップロード] または [クラウドインポート] (データコネクタから既存のデータテーブルを選択) を使用できます。
-
ユースケース:
 アイコンをクリックしてデータを XLSX 形式でダウンロードします。
 アイコンをクリックし、プロンプトを確認してデータテーブルの最新のコンテンツをナレッジベースと同期します。
 アイコンをクリックし、次に 編集 をクリックします。注:ナレッジベースの構成は、1 暦日あたり 1 回のみ変更できます。その後の試行はサイレントに拒否されます。
 アイコン: 画像 Q&A ナレッジベースの場合、システムはまず入力画像をベクトルに変換し、関連セグメントを取得します。次に、これらのセグメントを質問と共に LLM に送信して回答を生成します。ドキュメント検索、データクエリナレッジベースの場合、システムはアップロードされた画像を取得に使用しません。ただし、「視覚理解」用に設定されたドキュメント検索ナレッジベースは、画像を取得に使用し、テキストのみ、画像のみ、および画像+テキストのクエリモードをサポートします。この組み合わせクエリにより、取得の関連性が向上します。

クォータと制限
- ナレッジベースでサポートされているデータソース、容量、およびその他の制限については、「ナレッジベースのクォータと制限」をご参照ください。
-
ナレッジベースを Model Studio アプリケーションに関連付ける場合、以下の制限が適用されます:
- ドキュメント検索:最大 5
- データクエリ:最大 5
- 画像 Q&A:最大 1
課金
ナレッジベース機能の利用は無料ですが、それを利用する Alibaba Cloud Model Studio アプリケーションを呼び出す際に料金が発生する場合があります。
| 手順 | 課金 | |
|---|---|---|
| ナレッジベースの構築 | 無料です。 | |
| ビジネスアプリケーションとの連携 | Alibaba Cloud Model Studio アプリケーションを呼び出す際、ナレッジベースから取得されたテキストチャンクは LLM の入力トークン数を増加させ、モデル推論料金が増加します。詳細については、「課金項目と料金」をご参照ください。注:取得のために Retrieve API のみを使用し、Alibaba Cloud Model Studio アプリケーションを使用して応答を生成しない場合は、料金は発生しません。 | |
| 管理と O&M | 無料です。 | |
API リファレンス
- すべてのナレッジベース API とそのパラメーターの一覧については、API ディレクトリ (ナレッジベース) をご参照ください。
- 詳細な使用方法とコード例については、ナレッジベース API ガイド をご参照ください。
よくある質問
ナレッジベースの構築
Q:ナレッジベースにインポートした後、アプリケーションデータからファイルやデータテーブルを削除できますか?
Q:ナレッジベースにインポートした後、アプリケーションデータからファイルやデータテーブルを削除できますか?
- ドキュメント検索ナレッジベースの場合:はい。ナレッジベース内のファイルは、アプリケーションデータのソースから独立しています。ソースファイルを削除しても、インポートされたデータには影響しません。
- データクエリおよびイメージ Q&A ナレッジベースの場合:いいえ。ソースデータを削除すると、データ同期やナレッジベースの表示などの機能が中断されます。
Q:ナレッジベースの API 呼び出しで BailianIndexServiceNotOpen エラーコードが返された場合はどうすればよいですか?
Q:ナレッジベースの API 呼び出しで BailianIndexServiceNotOpen エラーコードが返された場合はどうすればよいですか?
BailianIndexServiceNotOpen エラーコードは、Model Studio のナレッジベースサービスが有効化されていないことを意味します。Model Studio コンソールにログインし、[データ] > [ナレッジベース] ページに移動し、[今すぐ有効にする] をクリックしてサービスを有効化してください。その後、API 呼び出しを再試行してください。画像とマルチモーダルコンテンツの取り扱い
Q:ファイルにイラストが含まれており、Model Studio アプリケーションの応答にそれらを含めたいのですが、どうすればよいですか?
Q:ファイルにイラストが含まれており、Model Studio アプリケーションの応答にそれらを含めたいのですが、どうすればよいですか?
- ドキュメント検索
- イメージ Q&A
方法 1 (エージェントアプリケーションのみ)
方法 1 (エージェントアプリケーションのみ)
-
ナレッジベースを作成する際、[ナレッジベースタイプ] を [ドキュメント検索] に設定し、図と文を交えた回答 を 図と文を交えた回答 に設定します。
[イラスト付き] を選択すると、ナレッジベースはファイル内のイラストからまとめを抽出します。その後、大規模言語モデルは、まとめとユーザーの質問との関連性に基づいて画像を挿入するかどうかを決定します。
-
エージェントアプリケーションを作成または編集する際、[Qwen-Plus] または [Qwen-Plus-Latest] モデルを選択します (テストではこれらのモデルが最高のパフォーマンスを提供することが示されています)。[ドキュメントナレッジベース] の右側にある [+] ボタンをクリックし、前のステップで作成したナレッジベースを追加します。
再現長はドキュメントの長さよりも短くする必要があります。それより長い場合、システムはドキュメント全体を返し、[イラスト付き] のロジックをバイパスします。
注:「イラスト付き」機能と「回答ソースの表示」機能は同時に有効にすることはできません。
-
実際の Q&A 結果:
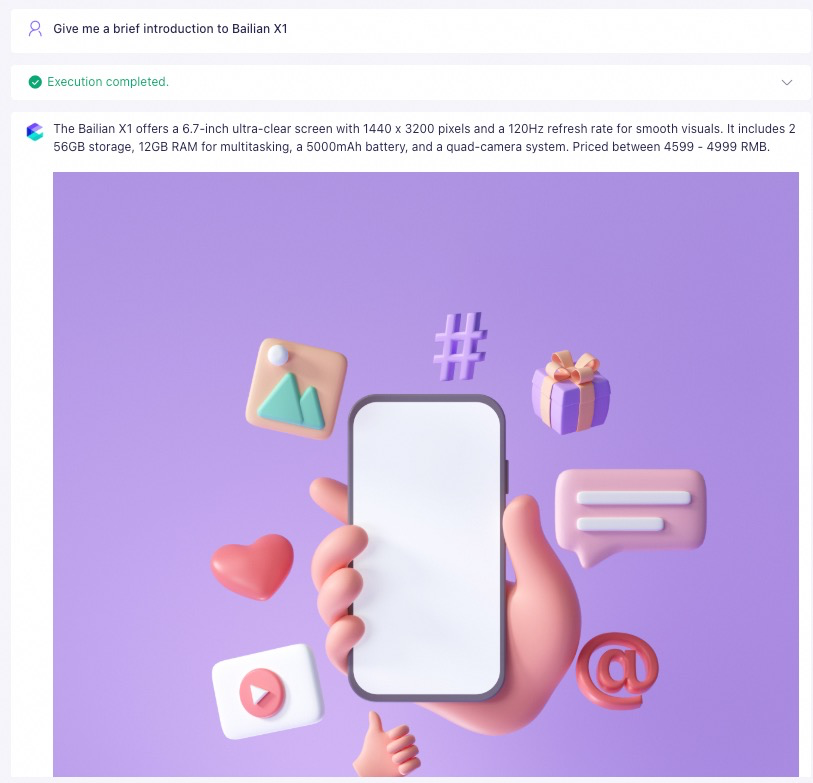
方法 2 (エージェントおよびワークフローアプリケーション)
方法 2 (エージェントおよびワークフローアプリケーション)
- 画像をパブリックにアクセス可能な場所にアップロードし、その完全な URL を取得します。Object Storage Service (OSS) の使用を推奨します。手順については、「OSS に画像をアップロードしてそのファイル URL を使用する」をご参照ください。
-
完全な URL をファイルに挿入します。相対パスはサポートされていません。ドキュメントに画像ファイルを直接埋め込まないでください (コピー&ペーストやメニューからのローカル画像の挿入など)。画像は、パブリックにアクセス可能な URL を使用して参照する必要があります。
画像が表示されない場合は、チャンク内の URL が完全であることを確認してください。解析エラーを引き起こす可能性のある余分なスペースや特殊文字を削除してください。チャンクを直接編集してこれらの修正を行うことができます。
ファイル内で画像を正しく参照する例 プロンプトテンプレートのサンプル 実際の Q&A 結果 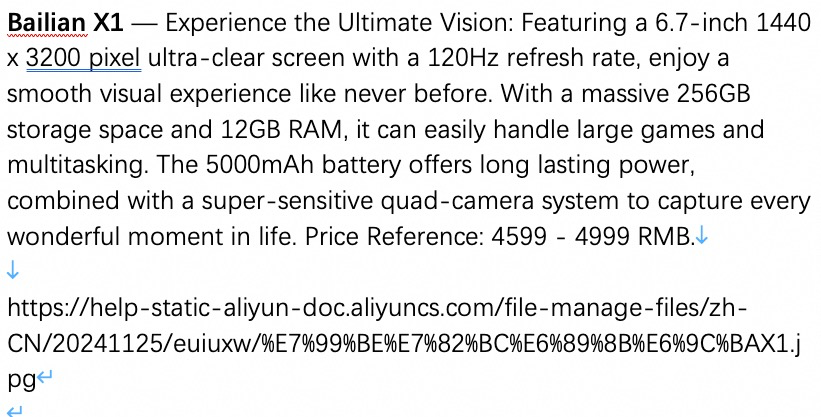
ファイル内で画像を誤って参照する例 プロンプトテンプレートのサンプル 実際の Q&A 結果 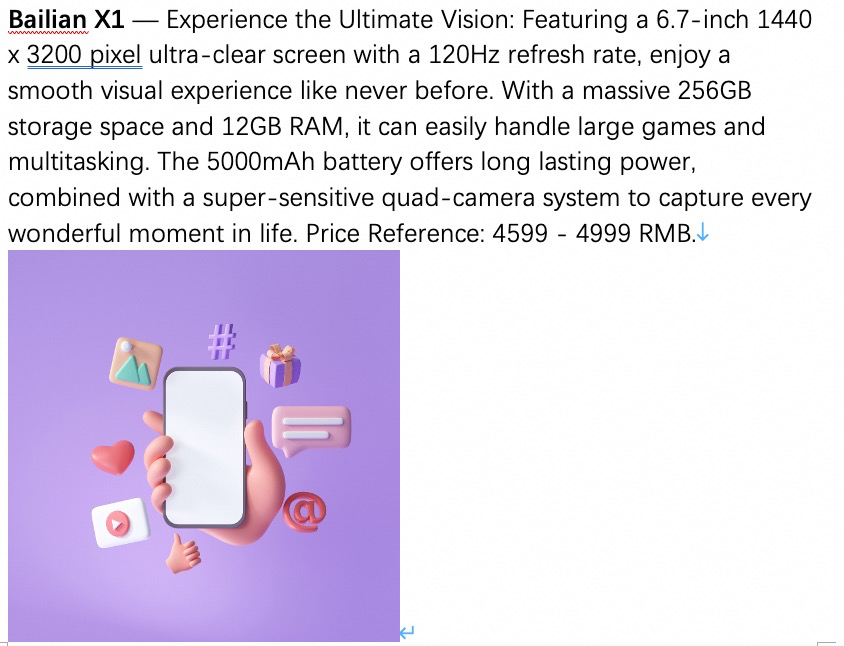
チャットテストインターフェイスでプロンプトを入力した後、AI の応答は画像なしのプレーンテキストコンテンツのみを返します。説明:画像をファイルに直接埋め込むと、Model Studio アプリケーションはその応答で画像を表示しません。
権限とセキュリティ
Q:ナレッジベースを管理する際に「このモジュールに対する権限がありません」というエラーが表示された場合はどうすればよいですか?
Q:ナレッジベースを管理する際に「このモジュールに対する権限がありません」というエラーが表示された場合はどうすればよいですか?
Q:ナレッジベースは非公開ですか?他の組織やユーザーはアクセスできますか?
Q:ナレッジベースは非公開ですか?他の組織やユーザーはアクセスできますか?
Q:Alibaba Cloud は、私のアカウントのナレッジベースを他のユーザーの質問に回答するために使用しますか?
Q:Alibaba Cloud は、私のアカウントのナレッジベースを他のユーザーの質問に回答するために使用しますか?
移行とエクスポート
Q:ナレッジベースをローカルマシンにエクスポートするにはどうすればよいですか?
Q:ナレッジベースをローカルマシンにエクスポートするにはどうすればよいですか?