ナレッジベース API

Alibaba Cloud Model Studio のナレッジベースは、既存の業務システムとの統合、運用の自動化、複雑な取得ニーズへの対応を可能にするオープン API を提供します。

前提条件

  1. API を使用してナレッジベースを管理するには、RAM ユーザーが API 権限 (AliyunBailianDataFullAccess ポリシー) を取得し、ワークスペースに参加する必要があります。Alibaba Cloud アカウントの場合は不要です。
    RAM ユーザーは、参加しているワークスペース内のナレッジベースのみを管理できます。Alibaba Cloud アカウントは、すべてのワークスペース内のナレッジベースを管理できます。
  2. ナレッジベース API を呼び出すには、最新バージョンの Alibaba Cloud Model Studio SDK をインストールします。インストール手順については、Alibaba Cloud SDK Development Reference をご参照ください。
    SDK が要件を満たさない場合は、署名メカニズムを使用して HTTP リクエスト経由でナレッジベース API を呼び出すことができます。接続の詳細については、API 概要をご参照ください。
  3. AccessKey ID と AccessKey Secret および ワークスペース ID を取得します。サンプルコードを実行するために、これらをシステム環境変数として設定します。以下は Linux でこれらの変数を設定する方法の例です:
    IDE または他の開発プラグインを使用する場合、開発環境で ALIBABA_CLOUD_ACCESS_KEY_ID、ALIBABA_CLOUD_ACCESS_KEY_SECRET、および WORKSPACE_ID 変数を設定してください。
export ALIBABA_CLOUD_ACCESS_KEY_ID='Your AccessKey ID'
export ALIBABA_CLOUD_ACCESS_KEY_SECRET='Your AccessKey Secret'
export WORKSPACE_ID='Your Alibaba Cloud Model Studio workspace ID'
  1. ナレッジベースを作成するために、サンプルのナレッジドキュメント Alibaba Cloud Model Studio スマートフォンシリーズ紹介.docx を準備します。
  • ナレッジベースの作成
  • ナレッジベースからの取得
  • ナレッジベースの更新
  • ナレッジベースの管理
  • この例を呼び出す前に、前提条件を完了し、RAM ユーザーに AliyunBailianDataFullAccess ポリシーがあることを確認してください。
  • IDE または他の開発プラグインを使用する場合は、開発環境で ALIBABA_CLOUD_ACCESS_KEY_ID、ALIBABA_CLOUD_ACCESS_KEY_SECRET、および WORKSPACE_ID 環境変数を設定してください。
Python
# このサンプルコードは参照用です。本番環境では使用しないでください。
import hashlib
import os
import time

import requests
from alibabacloud_bailian20231229 import models as bailian_20231229_models
from alibabacloud_bailian20231229.client import Client as bailian20231229Client
from alibabacloud_tea_openapi import models as open_api_models
from alibabacloud_tea_util import models as util_models

def check_environment_variables():
    """必要な環境変数が設定されていることを確認します。"""
    required_vars = {
        'ALIBABA_CLOUD_ACCESS_KEY_ID': 'Alibaba Cloud AccessKey ID',
        'ALIBABA_CLOUD_ACCESS_KEY_SECRET': 'Alibaba Cloud AccessKey Secret',
        'WORKSPACE_ID': 'Alibaba Cloud Model Studio workspace ID'
    }
    missing_vars = []
    for var, description in required_vars.items():
        if not os.environ.get(var):
            missing_vars.append(var)
            print(f"エラー: {var} 環境変数を設定してください ({description})。")

    return len(missing_vars) == 0

def calculate_md5(file_path: str) -> str:
    """
    ファイルの MD5 ハッシュを計算します。

    Args:
        file_path (str): ファイルのローカルパス。

    Returns:
        str: ファイルの MD5 ハッシュ。
    """
    md5_hash = hashlib.md5()

    # ファイルをバイナリモードで読み込みます。
    with open(file_path, "rb") as f:
        # 大きなファイルを処理する際にメモリを節約するために、ファイルをチャンクで読み込みます。
        for chunk in iter(lambda: f.read(4096), b""):
            md5_hash.update(chunk)

    return md5_hash.hexdigest()

def get_file_size(file_path: str) -> int:
    """
    ファイルのサイズをバイト単位で返します。
    Args:
        file_path (str): ファイルのローカルパス。
    Returns:
        int: ファイルサイズ (バイト単位)。
    """
    return os.path.getsize(file_path)

# クライアントを初期化します。
def create_client() -> bailian20231229Client:
    """
    クライアントを作成して設定します。

    Returns:
        bailian20231229Client: 設定済みのクライアント。
    """
    config = open_api_models.Config(
        access_key_id=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_ID'),
        access_key_secret=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_SECRET')
    )
    # このエンドポイントはアジアパシフィック SE 1 (シンガポール) リージョン用です。別のリージョンを使用する場合は変更してください。
    config.endpoint = 'bailian.ap-southeast-1.aliyuncs.com'
    return bailian20231229Client(config)

# ファイルアップロードリースをリクエストします。
def apply_lease(client, category_id, file_name, file_md5, file_size, workspace_id):
    """
    Model Studio サービスからファイルアップロードリースをリクエストします。

    Args:
        client (bailian20231229Client): クライアント。
        category_id (str): カテゴリ ID。
        file_name (str): ファイル名。
        file_md5 (str): ファイルの MD5 ハッシュ。
        file_size (int): ファイルサイズ (バイト単位)。
        workspace_id (str): ワークスペース ID。

    Returns:
        Model Studio サービスからのレスポンス。
    """
    headers = {}
    request = bailian_20231229_models.ApplyFileUploadLeaseRequest(
        file_name=file_name,
        md_5=file_md5,
        size_in_bytes=file_size,
    )
    runtime = util_models.RuntimeOptions()
    return client.apply_file_upload_lease_with_options(category_id, workspace_id, request, headers, runtime)

# ファイルを一時ストレージにアップロードします。
def upload_file(pre_signed_url, headers, file_path):
    """
    アップロードリースから取得した署名付き URL にファイルをアップロードします。
    Args:
        pre_signed_url (str): アップロードリースからの URL。
        headers (dict): アップロード用のリクエストヘッダー。
        file_path (str): ファイルのローカルパス。
    """
    with open(file_path, 'rb') as f:
        file_content = f.read()
    upload_headers = {
        "X-bailian-extra": headers["X-bailian-extra"],
        "Content-Type": headers["Content-Type"]
    }
    response = requests.put(pre_signed_url, data=file_content, headers=upload_headers)
    response.raise_for_status()

# ファイルをカテゴリに追加します。
def add_file(client: bailian20231229Client, lease_id: str, parser: str, category_id: str, workspace_id: str):
    """
    Model Studio サービスの指定されたカテゴリにファイルを追加します。

    Args:
        client (bailian20231229Client): クライアント。
        lease_id (str): リース ID。
        parser (str): ファイルのパーサー。
        category_id (str): カテゴリ ID。
        workspace_id (str): ワークスペース ID。

    Returns:
        Model Studio サービスからのレスポンス。
    """
    headers = {}
    request = bailian_20231229_models.AddFileRequest(
        lease_id=lease_id,
        parser=parser,
        category_id=category_id,
    )
    runtime = util_models.RuntimeOptions()
    return client.add_file_with_options(workspace_id, request, headers, runtime)

# ファイルの解析ステータスをクエリします。
def describe_file(client, workspace_id, file_id):
    """
    ファイルに関する基本情報を取得します。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        file_id (str): ファイル ID。

    Returns:
        Model Studio サービスからのレスポンス。
    """
    headers = {}
    runtime = util_models.RuntimeOptions()
    return client.describe_file_with_options(workspace_id, file_id, headers, runtime)

# ナレッジベース (インデックス) を初期化します。
def create_index(client, workspace_id, file_id, name, structure_type, source_type, sink_type):
    """
    Model Studio サービスでナレッジベースを作成します (インデックスを初期化します)。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        file_id (str): ファイル ID。
        name (str): ナレッジベースの名前。
        structure_type (str): ナレッジベースのデータの型。
        source_type (str): データソースのタイプ。例えば、このスクリプトでは 'DATA_CENTER_FILE' を使用します。
        sink_type (str): ナレッジベースのベクターストレージタイプ。

    Returns:
        Model Studio サービスからのレスポンス。
    """
    headers = {}
    request = bailian_20231229_models.CreateIndexRequest(
        structure_type=structure_type,
        name=name,
        source_type=source_type,
        sink_type=sink_type,
        document_ids=[file_id]
    )
    runtime = util_models.RuntimeOptions()
    return client.create_index_with_options(workspace_id, request, headers, runtime)

# インデックス作成タスクを送信します。
def submit_index(client, workspace_id, index_id):
    """
    Model Studio サービスにインデックス作成タスクを送信します。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        index_id (str): ナレッジベース ID。

    Returns:
        Model Studio サービスからのレスポンス。
    """
    headers = {}
    submit_index_job_request = bailian_20231229_models.SubmitIndexJobRequest(
        index_id=index_id
    )
    runtime = util_models.RuntimeOptions()
    return client.submit_index_job_with_options(workspace_id, submit_index_job_request, headers, runtime)

# インデックス作成タスクのステータスを取得します。
def get_index_job_status(client, workspace_id, job_id, index_id):
    """
    インデックス作成タスクのステータスをクエリします。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        index_id (str): ナレッジベース ID。
        job_id (str): インデックス作成タスクの ID。

    Returns:
        Model Studio サービスからのレスポンス。
    """
    headers = {}
    get_index_job_status_request = bailian_20231229_models.GetIndexJobStatusRequest(
        index_id=index_id,
        job_id=job_id
    )
    runtime = util_models.RuntimeOptions()
    return client.get_index_job_status_with_options(workspace_id, get_index_job_status_request, headers, runtime)

def create_knowledge_base(
        file_path: str,
        workspace_id: str,
        name: str
):
    """
    Model Studio でナレッジベースを作成します。
    Args:
        file_path (str): ファイルのローカルパス。
        workspace_id (str): ワークスペース ID。
        name (str): ナレッジベースの名前。
    Returns:
        str or None: 成功した場合はナレッジベース ID、失敗した場合は None。
    """
    # デフォルト値を設定します。
    category_id = 'default'
    parser = 'DASHSCOPE_DOCMIND'
    source_type = 'DATA_CENTER_FILE'
    structure_type = 'unstructured'
    sink_type = 'DEFAULT'
    try:
        # ステップ 1: クライアントを初期化します...
        print("ステップ 1: クライアントを初期化しています...")
        client = create_client()
        # ステップ 2: ファイル情報を準備します...
        print("ステップ 2: ファイル情報を準備しています...")
        file_name = os.path.basename(file_path)
        file_md5 = calculate_md5(file_path)
        file_size = get_file_size(file_path)
        # ステップ 3: Model Studio からアップロードリースをリクエストします...
        print("ステップ 3: Model Studio からアップロードリースをリクエストしています...")
        lease_response = apply_lease(client, category_id, file_name, file_md5, file_size, workspace_id)
        lease_id = lease_response.body.data.file_upload_lease_id
        upload_url = lease_response.body.data.param.url
        upload_headers = lease_response.body.data.param.headers
        # ステップ 4: ファイルを Model Studio にアップロードします...
        print("ステップ 4: ファイルを Model Studio にアップロードしています...")
        upload_file(upload_url, upload_headers, file_path)
        # ステップ 5: ファイルを Model Studio に追加します...
        print("ステップ 5: ファイルを Model Studio に追加しています...")
        add_response = add_file(client, lease_id, parser, category_id, workspace_id)
        file_id = add_response.body.data.file_id
        # ステップ 6: Model Studio でファイルステータスを確認します...
        print("ステップ 6: Model Studio でファイルステータスを確認しています...")
        while True:
            describe_response = describe_file(client, workspace_id, file_id)
            status = describe_response.body.data.status
            print(f"現在のファイルステータス: {status}")
            if status == 'INIT':
                print("ファイルは解析待ちです。お待ちください...")
            elif status == 'PARSING':
                print("ファイルは解析中です。お待ちください...")
            elif status == 'PARSE_SUCCESS':
                print("ファイルは正常に解析されました!")
                break
            else:
                print(f"不明なファイルステータス: {status}。テクニカルサポートにお問い合わせください。")
                return None
            time.sleep(5)
        # ステップ 7: Model Studio でナレッジベースを初期化します...
        print("ステップ 7: Model Studio でナレッジベースを初期化しています...")
        index_response = create_index(client, workspace_id, file_id, name, structure_type, source_type, sink_type)
        index_id = index_response.body.data.id
        # ステップ 8: インデックス作成タスクを Model Studio に送信します...
        print("ステップ 8: インデックス作成タスクを Model Studio に送信しています...")
        submit_response = submit_index(client, workspace_id, index_id)
        job_id = submit_response.body.data.id
        # ステップ 9: Model Studio からインデックス作成タスクのステータスを取得します...
        print("ステップ 9: Model Studio からインデックス作成タスクのステータスを取得しています...")
        while True:
            get_index_job_status_response = get_index_job_status(client, workspace_id, job_id, index_id)
            status = get_index_job_status_response.body.data.status
            print(f"現在のインデックス作成タスクのステータス: {status}")
            if status == 'COMPLETED':
                break
            time.sleep(5)
        print("Model Studio ナレッジベースが正常に作成されました!")
        return index_id
    except Exception as e:
        print(f"エラーが発生しました: {e}")
        return None

def main():
    if not check_environment_variables():
        print("環境変数チェックに失敗しました。")
        return
    file_path = input("アップロードするファイルのローカルパスを入力してください (例: /path/to/file.docx): ")
    kb_name = input("ナレッジベースの名前を入力してください: ")
    workspace_id = os.environ.get('WORKSPACE_ID')
    create_knowledge_base(file_path, workspace_id, kb_name)

if __name__ == '__main__':
    main()

ナレッジベースの作成

指定されたワークスペースにドキュメント検索ナレッジベースを作成します。

1. クライアントの初期化

ファイルをアップロードしてナレッジベースを作成するには、まずクライアントを初期化します。AccessKey と AccessKey Secret を使用して ID を検証し、endpoint を設定します。
  • パブリックエンドポイント
    ご利用のクライアントはインターネットにアクセスできる必要があります。
    • パブリッククラウド: bailian.ap-southeast-1.aliyuncs.com
  • VPC エンドポイント
    ご利用のクライアントが Alibaba Cloud シンガポールリージョン (ap-southeast-1) のパブリッククラウドにデプロイされており、VPC 内にある場合は、以下の VPC エンドポイントを使用できます。リージョン間のアクセスはサポートされていません。
    • パブリッククラウド: bailian-vpc.ap-southeast-1.aliyuncs.com
クライアントを作成すると、後続の API 呼び出しに使用する Client オブジェクトが返されます。
Python
def create_client() -> bailian20231229Client:
    """
    クライアントを作成して設定します。

    Returns:
        bailian20231229Client: 設定済みのクライアント。
    """
    config = open_api_models.Config(
        access_key_id=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_ID'),
        access_key_secret=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_SECRET')
    )
    # 以下のエンドポイントは、パブリッククラウドのパブリックエンドポイントの例です。必要に応じてエンドポイントを変更できます。
    config.endpoint = 'bailian.ap-southeast-1.aliyuncs.com'
    return bailian20231229Client(config)

2. ナレッジベースファイルのアップロード

2.1. ファイルアップロードリースのリクエスト

ナレッジベースを作成する前に、そのソースファイルを同じワークスペースにアップロードします。これを行うには、ApplyFileUploadLease 操作を呼び出してファイルアップロードリースをリクエストします。リースはファイルをアップロードするための一時的な権限付与であり、数分間有効です。
  • workspace_id: 「ワークスペース ID の取得方法」をご参照ください。
  • category_id: この例では、default を渡します。 Model Studio は、アップロードされたファイルを管理するためにカテゴリを使用します。 デフォルトのカテゴリは、システムによって自動的に作成されます。 また、AddCategory API を呼び出して新しいカテゴリを作成し、対応する category_id を取得することもできます。
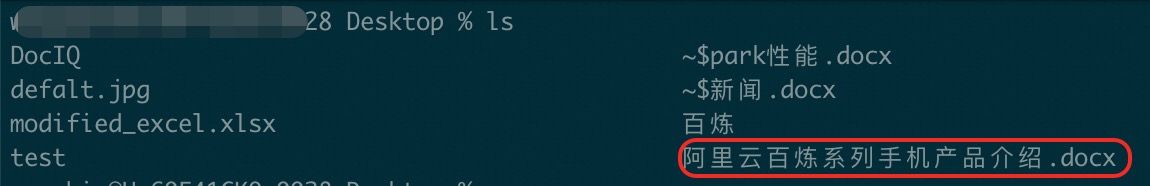
  • file_name: 拡張子を含めて、アップロードするファイル名を渡します。値は実際のファイル名と一致する必要があります。たとえば、図に示されているファイルをアップロードする場合、 Alibaba_Cloud_Model_Studio_Mobile_Phone_Series_Introduction.docx を渡します。
    image
  • file_md5: アップロードするファイルの MD5 ハッシュを渡します。Alibaba Cloud は現在この値を検証しないため、URL からのファイルアップロードが容易になります。
    Python では、hashlib モジュールを使用して MD5 ハッシュを取得できます。他の言語については、完全なサンプルコードをご参照ください。
    import hashlib
    
    def calculate_md5(file_path):
        """
        ファイルの MD5 ハッシュを計算します。
    
        Args:
            file_path (str): ファイルのローカルパス。
    
        Returns:
            str: ファイルの MD5 ハッシュ。
        """
        md5_hash = hashlib.md5()
    
        # ファイルをバイナリモードで読み込みます。
        with open(file_path, "rb") as f:
            # 大きなファイルの場合、メモリ使用量を抑えるためにチャンクで読み込みます。
            for chunk in iter(lambda: f.read(4096), b""):
                md5_hash.update(chunk)
    
        return md5_hash.hexdigest()
    
    # 使用例
    file_path = "これをアップロードするファイルの実際のローカルパスに置き換えてください。例: /path/to/your/Alibaba Cloud Model Studio Product Overview.docx"
    md5_value = calculate_md5(file_path)
    print(f"ファイルの MD5 ハッシュは: {md5_value}")
    
    コード内の file_path 変数をファイルの実際のローカルパスに置き換え、コードを実行して対象のファイルの MD5 ハッシュを取得します。 以下に値の例を示します。
    ファイルの MD5 ハッシュは: 2ef7361ea907f3a1b91e3b9936f5643a
    
  • file_size: アップロードするファイルのサイズをバイト単位で渡します。
    Python では、os モジュールを使用してこの値を取得できます。他の言語については、完全なサンプルコードをご参照ください。
    import os
    
    def get_file_size(file_path: str) -> int:
        """
        ファイルのサイズをバイト単位で取得します。
    
        Args:
            file_path (str): ファイルの実際のローカルパス。
    
        Returns:
            int: ファイルサイズ (バイト単位)。
        """
        return os.path.getsize(file_path)
    
    # 使用例
    file_path = "これをアップロードするファイルの実際のローカルパスに置き換えてください。例: /path/to/your/Alibaba Cloud Model Studio Product Overview.docx"
    file_size = get_file_size(file_path)
    print(f"ファイルのサイズ (バイト単位) は: {file_size}")
    
    file_path 変数をファイルの実際のローカルパスに置き換えてコードを実行し、対象のファイルのサイズをバイト単位で取得します。 以下に値の例を示します。
    ファイルのサイズ (バイト単位) は: 14015
    
一時的なアップロードリースのリクエストが成功すると、以下が返されます:
  • 一時的なアップロードパラメータのセット:
    • Data.FileUploadLeaseId
    • Data.Param.Method
    • Data.Param.Headers の X-bailian-extra
    • Data.Param.Headers の Content-Type
  • 一時アップロード URL:Data.Param.Url
Python
def apply_lease(client, category_id, file_name, file_md5, file_size, workspace_id):
    """
    Alibaba Cloud Model Studio からファイルアップロードリースをリクエストします。

    Args:
        client (bailian20231229Client): クライアント。
        category_id (str): カテゴリ ID。
        file_name (str): ファイル名。
        file_md5 (str): ファイルの MD5 ハッシュ。
        file_size (int): ファイルサイズ (バイト単位)。
        workspace_id (str): ワークスペース ID。

    Returns:
        Alibaba Cloud Model Studio からのレスポンス。
    """
    headers = {}
    request = bailian_20231229_models.ApplyFileUploadLeaseRequest(
        file_name=file_name,
        md_5=file_md5,
        size_in_bytes=file_size,
    )
    runtime = util_models.RuntimeOptions()
    return client.apply_file_upload_lease_with_options(category_id, workspace_id, request, headers, runtime)
{
  "CategoryId": "default",
  "FileName": "Alibaba Cloud Model Studio Product Overview.docx",
  "Md5": "2ef7361ea907f3a1b91e3b9936f5643a",
  "SizeInBytes": "14015",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx"
}
{
  "RequestId": "778C0B3B-59C2-5FC1-A947-36EDD1XXXXXX",
  "Success": true,
  "Message": "",
  "Code": "success",
  "Status": "200",
  "Data": {
    "FileUploadLeaseId": "1e6a159107384782be5e45ac4759b247.1719325231035",
    "Type": "HTTP",
    "Param": {
      "Method": "PUT",
      "Url": "https://bailian-datahub-data-origin-prod.oss-cn-hangzhou.aliyuncs.com/1005426495169178/10024405/68abd1dea7b6404d8f7d7b9f7fbd332d.1716698936847.pdf?Expires=1716699536&OSSAccessKeyId=YOUR_ACCESS_KEY_ID&Signature=YOUR_SIGNATURE",
      "Headers": "        \"X-bailian-extra\": \"MTAwNTQyNjQ5NTE2OTE3OA==\",\n        \"Content-Type\": \"application/pdf\""
    }
  }
}

2.2. ファイルを一時ストレージにアップロード

アップロードリースを使用して、ローカルストレージまたは一般公開されている URL から Model Studio サーバーにファイルをアップロードします。各ワークスペースは最大 10,000 ファイルをサポートします。サポートされている形式には、PDF、DOCX、DOC、TXT、Markdown、PPTX、PPT、XLSX、XLS、HTML、PNG、JPG、JPEG、BMP、GIF が含まれます。
  • pre_signed_url: ファイルアップロードリースをリクエストする API 応答の Data.Param.Url を指定します。
    これは署名付き URL であり、FormData アップロードをサポートしていません。ファイルをバイナリ形式でアップロードする必要があります。詳細については、サンプルコードをご参照ください。
この例では、オンラインデバッグやサンプルコードの生成はサポートされていません。
  • ローカルアップロード
  • URL アップロード
Python
import requests
from urllib.parse import urlparse

def upload_file(pre_signed_url, file_path):
    """
    ローカルファイルを一時ストレージにアップロードします。

    Args:
        pre_signed_url (str): アップロードリースからの URL。
        file_path (str): ファイルのローカルパス。

    Returns:
        Alibaba Cloud Model Studio からのレスポンス。
    """
    try:
        # リクエストヘッダーを設定します。
        headers = {
            "X-bailian-extra": "前の手順の ApplyFileUploadLease 操作によって返された Data.Param.Headers の X-bailian-extra フィールドの値に置き換えてください。",
            "Content-Type": "前の手順の ApplyFileUploadLease 操作によって返された Data.Param.Headers の Content-Type フィールドの値に置き換えてください。null 値が返された場合は、null 値を渡してください。"
        }

        # ファイルを読み込んでアップロードします。
        with open(file_path, 'rb') as file:
            # ファイルアップロードのリクエストメソッドは、前の手順の ApplyFileUploadLease 操作によって返された Data.Param の Method フィールドの値と同じでなければなりません。
            response = requests.put(pre_signed_url, data=file, headers=headers)

        # レスポンスのステータスコードを確認します。
        if response.status_code == 200:
            print("ファイルは正常にアップロードされました。")
        else:
            print(f"ファイルのアップロードに失敗しました。ResponseCode: {response.status_code}")

    except Exception as e:
        print(f"エラーが発生しました: {str(e)}")

if __name__ == "__main__":

    pre_signed_url_or_http_url = "前の手順の ApplyFileUploadLease 操作によって返された Data.Param の Url フィールドの値に置き換えてください。"

    # ローカルファイルを一時ストレージにアップロードします。
    file_path = "アップロードするファイルの実際のローカルパスに置き換えてください。例: Linux の場合 /path/to/your/Alibaba Cloud Model Studio Product Overview.docx"
    upload_file(pre_signed_url_or_http_url, file_path)

2.3. ファイルをカテゴリに追加

ファイルをアップロードした後、AddFile 操作を呼び出して、同じワークスペース内のカテゴリにファイルを追加します。
  • パーサ: DASHSCOPE_DOCMIND を指定します。
  • lease_id: ファイルアップロードリースをリクエストするときに返される Data.FileUploadLeaseId を設定します。
  • category_id: この例では、default を渡します。アップロードにカスタムカテゴリを使用する場合、対応する category_id を渡す必要があります。
    ここで渡される CategoryId は、ファイルアップロードリースの申請 ステップで使用される CategoryId と一致する必要があります。一致しない場合、Category is mismatched エラーが表示されます。
ファイルを追加すると、Model Studio によってファイルの FileId が返され、その解析が自動的に開始されます。lease_id は直ちに無効になります。別の送信に同じリース ID を再利用しないでください。
Python
def add_file(client: bailian20231229Client, lease_id: str, parser: str, category_id: str, workspace_id: str):
    """
    Alibaba Cloud Model Studio の指定されたカテゴリにファイルを追加します。

    Args:
        client (bailian20231229Client): クライアント。
        lease_id (str): リース ID。
        parser (str): ファイルのパーサー。
        category_id (str): カテゴリ ID。
        workspace_id (str): ワークスペース ID。

    Returns:
        Alibaba Cloud Model Studio からのレスポンス。
    """
    headers = {}
    request = bailian_20231229_models.AddFileRequest(
        lease_id=lease_id,
        parser=parser,
        category_id=category_id,
    )
    runtime = util_models.RuntimeOptions()
    return client.add_file_with_options(workspace_id, request, headers, runtime)
{
  "CategoryId": "default",
  "LeaseId": "d92bd94fa9b54326a2547415e100c9e2.1742195250069",
  "Parser": "DASHSCOPE_DOCMIND",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx"
}
{
  "Status": "200",
  "Message": "",
  "RequestId": "5832A1F4-AF91-5242-8B75-35BDC9XXXXXX",
  "Data": {
    "FileId": "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx",
    "Parser": "DASHSCOPE_DOCMIND"
  },
  "Code": "Success",
  "Success": "true"
}

2.4. クエリファイルの解析状態

ファイルは解析されるまでナレッジベースで使用できません。ピーク時には、このプロセスに数時間かかることがあります。DescribeFile 操作を呼び出して、その解析ステータスをクエリできます。Data.Status フィールドが PARSE_SUCCESS の場合、ファイルの解析は成功しており、ナレッジベースにインポートできます。
Python
def describe_file(client, workspace_id, file_id):
    """
    ファイルの基本情報を取得します。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        file_id (str): ファイル ID。

    Returns:
        Alibaba Cloud Model Studio からのレスポンス。
    """
    headers = {}
    runtime = util_models.RuntimeOptions()
    return client.describe_file_with_options(workspace_id, file_id, headers, runtime)
{
  "FileId": "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx"
}
{
  "Status": "200",
  "Message": "",
  "RequestId": "B9246251-987A-5628-8E1E-17BB39XXXXXX",
  "Data": {
    "CategoryId": "cate_206ea350f0014ea4a324adff1ca13011_10xxxxxx",
    "Status": "PARSE_SUCCESS",
    "FileType": "docx",
    "CreateTime": "2025-03-17 15:47:13",
    "FileName": "Alibaba Cloud Model Studio Product Overview.docx",
    "FileId": "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx",
    "SizeInBytes": "14015",
    "Parser": "DASHSCOPE_DOCMIND"
  },
  "Code": "Success",
  "Success": "true"
}

3. ナレッジベースの作成

3.1. ナレッジベースの初期化

ファイルが解析されたら、同じワークスペース内でそのファイルからナレッジベースを作成できます。まず、CreateIndex 操作を呼び出して、ドキュメント検索ナレッジベースを初期化 (ただし最終化はしない) します。
  • workspace_id: 「ワークスペース ID の取得方法」をご参照ください。
  • file_id:カテゴリにファイルを追加する際に API によって返される FileId を指定します。
    source_type が DATA_CENTER_FILE に設定されている場合、このパラメーターは必須であり、指定されていない場合は API がエラーを返します。
  • structure_type: この例では、unstructured を渡します。
  • ソースタイプ:この例では、 DATA_CENTER_FILE を指定します。
  • sink_type: この例では、 BUILT_IN を指定します。
この API が返す Data.Id フィールドの値は、後続のインデックス構築に使用されるナレッジベース ID です。
このナレッジベースに関連する後続のすべての API 操作で必要となるため、ナレッジベース ID を安全に保管してください。
Python
def create_index(client, workspace_id, file_id, name, structure_type, source_type, sink_type):
    """
    Alibaba Cloud Model Studio でナレッジベースを作成 (初期化) します。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        file_id (str): ファイル ID。
        name (str): ナレッジベースの名前。
        structure_type (str): ナレッジベースのデータ構造タイプ。
        source_type (str): データソースのタイプ。カテゴリとファイルタイプがサポートされています。
        sink_type (str): ナレッジベースのベクターストレージタイプ。

    Returns:
        Alibaba Cloud Model Studio からのレスポンス。
    """
    headers = {}
    request = bailian_20231229_models.CreateIndexRequest(
        structure_type=structure_type,
        name=name,
        source_type=source_type,
        sink_type=sink_type,
        document_ids=[file_id]
    )
    runtime = util_models.RuntimeOptions()
    return client.create_index_with_options(workspace_id, request, headers, runtime)
{
  "Name": "Alibaba Cloud Model Studio スマートフォンナレッジベース",
  "SinkType": "BUILT_IN",
  "SourceType": "DATA_CENTER_FILE",
  "StructureType": "unstructured",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx",
  "DocumentIds": [
    "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx"
  ]
}
{
  "Status": "200",
  "Message": "success",
  "RequestId": "87CB0999-F1BB-5290-8C79-A875B2XXXXXX",
  "Data": {
    "Id": "mymxbdxxxx"
  },
  "Code": "Success",
  "Success": "true"
}

3.2. インデックスジョブの送信

ナレッジベースを初期化した後、SubmitIndexJob 操作を呼び出してインデックス構築プロセスを開始します。送信が完了すると、Model Studio はすぐに非同期タスクとしてインデックスの構築を開始します。この API 呼び出しによって返される Data.Id は、対応するタスク ID です。次のステップでは、この ID を使用してタスクの最新のステータスをクエリします。
Python
def submit_index(client, workspace_id, index_id):
    """
    Alibaba Cloud Model Studio にインデックスジョブを送信します。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        index_id (str): ナレッジベース ID。

    Returns:
        Alibaba Cloud Model Studio からのレスポンス。
    """
    headers = {}
    submit_index_job_request = bailian_20231229_models.SubmitIndexJobRequest(
        index_id=index_id
    )
    runtime = util_models.RuntimeOptions()
    return client.submit_index_job_with_options(workspace_id, submit_index_job_request, headers, runtime)
{
  "IndexId": "mymxbdxxxx",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx"
}
{
  "Status": "200",
  "Message": "success",
  "RequestId": "7774575F-571D-5854-82C2-634AB8XXXXXX",
  "Data": {
    "IndexId": "mymxbdxxxx",
    "Id": "3cd6fb57aaf44cd0b4dd2ca584xxxxxx"
  },
  "Code": "Success",
  "Success": "true"
}

3.3. インデックスジョブのステータスのクエリ

インデックスジョブの完了には時間がかかります。ピーク時には、このプロセスに数時間かかることがあります。GetIndexJobStatus 操作を呼び出して、その実行ステータスをクエリします。Data.Status フィールドが COMPLETED の場合、ナレッジベースは作成されています。
Python
def get_index_job_status(client, workspace_id, index_id, job_id):
    """
    インデックスジョブのステータスをクエリします。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        index_id (str): ナレッジベース ID。
        job_id (str): ジョブ ID。

    Returns:
        Alibaba Cloud Model Studio からのレスポンス。
    """
    headers = {}
    get_index_job_status_request = bailian_20231229_models.GetIndexJobStatusRequest(
        index_id=index_id,
        job_id=job_id
    )
    runtime = util_models.RuntimeOptions()
    return client.get_index_job_status_with_options(workspace_id, get_index_job_status_request, headers, runtime)
{
  "IndexId": "mymxbdxxxx",
  "JobId": "3cd6fb57aaf44cd0b4dd2ca584xxxxxx",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx"
}
{
  "Status": "200",
  "Message": "success",
  "RequestId": "E83423B9-7D6D-5283-836B-CF7EAEXXXXXX",
  "Data": {
    "Status": "COMPLETED",
    "Documents": [
      {
        "Status": "FINISH",
        "DocId": "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx",
        "Message": "正常にインポートされました。",
        "DocName": "Alibaba Cloud Model Studio 製品概要",
        "Code": "FINISH"
      }
    ],
    "JobId": "3cd6fb57aaf44cd0b4dd2ca584xxxxxx"
  },
  "Code": "Success",
  "Success": "true"
}
アップロードされたファイルからナレッジベースが作成されました。

ナレッジベースからの取得

ナレッジベースから情報を取得するには、2 つの方法があります:
  • Alibaba Cloud Model Studio アプリケーションの使用: アプリケーションを呼び出す際、rag_options パラメーターを使用してナレッジベース ID index_id を渡します。これにより、モデルを非公開ナレッジで補完し、最新の情報を提供します。
  • Alibaba Cloud API の使用: Retrieve API を呼び出して、指定されたナレッジベースから情報を取得し、元のテキストセグメントを返します。
最初の方法では、取得したテキストセグメントを設定済みのモデルに送信して最終的な回答を生成しますが、2 番目の方法ではテキストセグメントを直接返します。 このセクションでは、Alibaba Cloud API の使用方法について説明します。
指定されたナレッジベースから情報を取得してテキストセグメントを返すには、Retrieve API を呼び出します。レスポンスに無関係な情報が過剰に含まれている場合は、リクエストで SearchFilters を指定して、タグなどの基準で結果をフィルタリングします。
Python
def retrieve_index(client, workspace_id, index_id, query):
    """
    指定されたナレッジベースから情報を取得します。

    Args:
        client (bailian20231229Client): クライアントオブジェクト。
        workspace_id (str): ワークスペース ID。
        index_id (str): ナレッジベース ID。
        query (str): 検索クエリ。

    Returns:
        Model Studio サービスからのレスポンス。
    """
    headers = {}
    retrieve_request = bailian_20231229_models.RetrieveRequest(
        index_id=index_id,
        query=query
    )
    runtime = util_models.RuntimeOptions()
    return client.retrieve_with_options(workspace_id, retrieve_request, headers, runtime)
{
  "IndexId": "mymxbdxxxx",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx",
  "Query": "Alibaba Cloud Model Studio X1 スマートフォンを紹介してください。"
}
{
  "Status": "200",
  "Message": "success",
  "RequestId": "17316EA2-1F4D-55AC-8872-53F6F1XXXXXX",
  "Data": {
    "Nodes": [
      {
        "Score": 0.6294550895690918,
        "Metadata": {
          "file_path": "https://bailian-datahub-data-prod.oss-cn-beijing.aliyuncs.com/10285263/multimodal/docJson/Model_Studio_Series_Phone_Product_Introduction_1742197778230.json?Expires=1742457465&OSSAccessKeyId=YOUR_ACCESS_KEY_ID&Signature=YOUR_SIGNATURE",
          "is_displayed_chunk_content": "true",
          "_rc_v_score": 0.7449869735535081,
          "image_url": [],
          "nid": "9ad347d9e4d7465d2c1e693a08b0077c|d6f7fbf8403e0df796258e5ada1ee1c1|4772257e93ed64ea087ff4be0d5e4620|7ce1370e4a1958842c9268144a452cc7",
          "_q_score": 1,
          "source": "0",
          "_score": 0.6294550895690918,
          "title": "Alibaba Cloud Model Studio スマートフォン製品紹介",
          "doc_id": "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx",
          "content": "Alibaba Cloud Model Studio スマートフォン製品紹介\nAlibaba Cloud Model Studio X1 — 究極の視覚体験をお楽しみください: 6.7 インチ 1440 x 3200 ピクセルの超クリアスクリーンと 120 Hz のリフレッシュレートで、滑らかで鮮やかな視覚体験を提供します。256 GB の大容量ストレージと 12 GB の RAM の強力な組み合わせにより、大規模なゲームやマルチタスクも楽々こなします。長持ちする 5000 mAh バッテリーと超高感度クアッドカメラシステムで、人生の素晴らしい瞬間をすべて捉えます。参考価格: 4,599–4,999\nTongyi Vivid 7 — スマート写真の新しい体験: 6.5 インチ 1080 x 2400 ピクセルのフルスクリーンを搭載。AI スマート写真機能により、すべての写真がプロ級の色とディテールで表示されます。8 GB の RAM と 128 GB のストレージでスムーズな操作を保証し、4,500 mAh のバッテリーが日常のニーズを満たします。側面の指紋認証は便利で安全です。参考価格: 2,999–3,299\nStardust S9 Pro — 革新的な視覚の饗宴: 画期的な 6.9 インチ 1440 x 3088 ピクセルのアンダースクリーンカメラデザインにより、ボーダーレスな視覚体験を提供します。512 GB のストレージと 16 GB の RAM を備えた最高級の構成に、6,000 mAh のバッテリーと 100 W の高速充電技術を組み合わせ、パフォーマンスと耐久性の両方を提供し、技術トレンドをリードします。参考価格: 5,999–6,499。",
          "_rc_score": 0,
          "workspace_id": "llm-4u5xpd1xdjqpxxxx",
          "hier_title": "Alibaba Cloud Model Studio スマートフォン製品紹介",
          "_rc_t_score": 0.05215025693178177,
          "doc_name": "Alibaba Cloud Model Studio シリーズスマートフォン製品紹介",
          "pipeline_id": "mymxbdxxxx",
          "_id": "llm-4u5xpd1xdjqp8itj_mymxbd6172_file_0b21e0a852cd40cd9741c54fefbb61cd_10285263_0_0"
        },
        "Text": "Alibaba Cloud Model Studio スマートフォン製品紹介\nAlibaba Cloud Model Studio X1 — 究極の視覚体験をお楽しみください: 6.7 インチ 1440 x 3200 ピクセルの超クリアスクリーンと 120 Hz のリフレッシュレートで、滑らかで鮮やかな視覚体験を提供します。256 GB の大容量ストレージと 12 GB の RAM の強力な組み合わせにより、大規模なゲームやマルチタスクも楽々こなします。長持ちする 5000 mAh バッテリーと超高感度クアッドカメラシステムで、人生の素晴らしい瞬間をすべて捉えます。参考価格: 4,599–4,999\nTongyi Vivid 7 — スマート写真の新しい体験: 6.5 インチ 1080 x 2400 ピクセルのフルスクリーンを搭載。AI スマート写真機能により、すべての写真がプロ級の色とディテールで表示されます。8 GB の RAM と 128 GB のストレージでスムーズな操作を保証し、4,500 mAh のバッテリーが日常のニーズを満たします。側面の指紋認証は便利で安全です。参考価格: 2,999–3,299\nStardust S9 Pro — 革新的な視覚の饗宴: 画期的な 6.9 インチ 1440 x 3088 ピクセルのアンダースクリーンカメラデザインにより、ボーダーレスな視覚体験を提供します。512 GB のストレージと 16 GB の RAM を備えた最高級の構成に、6,000 mAh のバッテリーと 100 W の高速充電技術を組み合わせ、パフォーマンスと耐久性の両方を提供し、技術トレンドをリードします。参考価格: 5,999–6,499。"
      },
      {
        "Score": 0.5322970747947693,
        "Metadata": {
          "file_path": "https://bailian-datahub-data-prod.oss-cn-beijing.aliyuncs.com/10285263/multimodal/docJson/Model_Studio_Series_Phone_Product_Introduction_1742197778230.json?Expires=1742457465&OSSAccessKeyId=YOUR_ACCESS_KEY_ID&Signature=YOUR_SIGNATURE",
          "is_displayed_chunk_content": "true",
          "_rc_v_score": 0.641660213470459,
          "image_url": [],
          "nid": "00be1864c18b4c39c59f83713af80092|4f2bfb02cc9fc4e85597b2e717699207",
          "_q_score": 0.9948930557644994,
          "source": "0",
          "_score": 0.5322970747947693,
          "title": "Alibaba Cloud Model Studio スマートフォン製品紹介",
          "doc_id": "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx",
          "content": "Alibaba Cloud Model Studio Flex Fold+ — 折りたたみ式スクリーンの新時代: 革新と豪華さを兼ね備え、7.6 インチ 1800 x 2400 ピクセルのメインスクリーンと 4.7 インチ 1080 x 2400 ピクセルの外部スクリーンを搭載。マルチアングル自由停止ヒンジ設計は、さまざまなシナリオのニーズに対応します。Alibaba Cloud Model Studio Flex Fold+ — 折りたたみ式スクリーンの新時代: 革新と豪華さを兼ね備え、7.6 インチ 1800 x 2400 ピクセルのメインスクリーンと 4.7 インチ 1080 x 2400 ピクセルの外部スクリーンを搭載。マルチアングル自由停止ヒンジ設計は、さまざまなシナリオのニーズに対応します。512 GB のストレージ、12 GB の RAM、4700 mAh のバッテリー、UTG 超薄型フレキシブルガラスが、折りたたみ式スクリーンの時代の新しい章を開きます。さらに、このスマートフォンはデュアル SIM デュアルスタンバイと衛星通話をサポートし、世界中のどこにいても接続を維持できます。参考小売価格: 9,999–10,999。各スマートフォンは職人技の傑作であり、手の中の技術芸術作品となるように設計されています。スマートな相棒を選んで、未来の技術生活の新しい章を始めましょう。",
          "_rc_score": 0,
          "workspace_id": "llm-4u5xpd1xdjqpxxxx",
          "hier_title": "Alibaba Cloud Model Studio スマートフォン製品紹介",
          "_rc_t_score": 0.05188392847776413,
          "doc_name": "Alibaba Cloud Model Studio シリーズスマートフォン製品紹介",
          "pipeline_id": "mymxbdxxxx",
          "_id": "llm-4u5xpd1xdjqp8itj_mymxbd6172_file_0b21e0a852cd40cd9741c54fefbb61cd_10285263_0_2"
        },
        "Text": "Alibaba Cloud Model Studio Flex Fold+ — 折りたたみ式スクリーンの新時代: 革新と豪華さを兼ね備え、7.6 インチ 1800 x 2400 ピクセルのメインスクリーンと 4.7 インチ 1080 x 2400 ピクセルの外部スクリーンを搭載。マルチアングル自由停止ヒンジ設計は、さまざまなシナリオのニーズに対応します。Alibaba Cloud Model Studio Flex Fold+ — 折りたたみ式スクリーンの新時代: 革新と豪華さを兼ね備え、7.6 インチ 1800 x 2400 ピクセルのメインスクリーンと 4.7 インチ 1080 x 2400 ピクセルの外部スクリーンを搭載。マルチアングル自由停止ヒンジ設計は、さまざまなシナリオのニーズに対応します。512 GB のストレージ、12 GB の RAM、4700 mAh のバッテリー、UTG 超薄型フレキシブルガラスが、折りたたみ式スクリーンの時代の新しい章を開きます。さらに、このスマートフォンはデュアル SIM デュアルスタンバイと衛星通話をサポートし、世界中のどこにいても接続を維持できます。参考小売価格: 9,999–10,999。各スマートフォンは職人技の傑作であり、手の中の技術芸術作品となるように設計されています。スマートな相棒を選んで、未来の技術生活の新しい章を始めましょう。"
      },
      {
        "Score": 0.5050643086433411,
        "Metadata": {
          "file_path": "https://bailian-datahub-data-prod.oss-cn-beijing.aliyuncs.com/10285263/multimodal/docJson/Model_Studio_Series_Phone_Product_Introduction_1742197778230.json?Expires=1742457465&OSSAccessKeyId=YOUR_ACCESS_KEY_ID&Signature=YOUR_SIGNATURE",
          "is_displayed_chunk_content": "true",
          "_rc_v_score": 0.6757396459579468,
          "image_url": [],
          "nid": "f05d1b51eb6b033b32a162d90a9da71b|5cb6b848be8d11eb168c031025415cc5|4f2bfb02cc9fc4e85597b2e717699207",
          "_q_score": 0.9890713450653327,
          "source": "0",
          "_score": 0.5050643086433411,
          "title": "Alibaba Cloud Model Studio スマートフォン製品紹介",
          "doc_id": "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx",
          "content": "512 GB のストレージと 16 GB の RAM を備えた最高級の構成に、6,000 mAh のバッテリーと 100 W の高速充電技術を組み合わせ、パフォーマンスと耐久性の両方を提供し、技術トレンドをリードします。参考価格: 5,999–6,499。Alibaba Cloud Model Studio Ace Ultra — ゲーマーの選択: 6.67 インチ 1080 x 2400 ピクセルのスクリーン、10 GB の RAM、256 GB のストレージを搭載し、シルクのように滑らかなゲームプレイを保証します。液体冷却システムを備えた 5,500 mAh のバッテリーは、長時間のゲームセッションでも涼しく保ちます。高ダイナミックデュアルスピーカーは、没入感のあるサウンドエフェクトでゲーム体験をアップグレードします。参考価格: 3,999–4,299。Alibaba Cloud Model Studio Zephyr Z9 — 薄くてポータブルな芸術: 軽量な 6.4 インチ 1080 x 2340 ピクセルのデザインで、128 GB のストレージと 6 GB の RAM を備え、日常使用には十分すぎるほどです。4,000 mAh のバッテリーは、一日中安心して使用できます。30 倍のデジタルズームレンズで遠くのディテールを捉えます。薄くてもパワフルです。参考価格: 2,499–2,799。Alibaba Cloud Model Studio Flex Fold+ — 折りたたみ式スクリーンの新時代: 革新と豪華さを兼ね備え、7.6 インチ 1800 x 2400 ピクセルのメインスクリーンと 4.7 インチ 1080 x 2400 ピクセルの外部スクリーンを搭載。マルチアングル自由停止ヒンジ設計は、さまざまなシナリオのニーズに対応します。",
          "_rc_score": 0,
          "workspace_id": "llm-4u5xpd1xdjqpxxxx",
          "hier_title": "Alibaba Cloud Model Studio スマートフォン製品紹介",
          "_rc_t_score": 0.05158032476902008,
          "doc_name": "Alibaba Cloud Model Studio シリーズスマートフォン製品紹介",
          "pipeline_id": "mymxbdxxxx",
          "_id": "llm-4u5xpd1xdjqp8itj_mymxbd6172_file_0b21e0a852cd40cd9741c54fefbb61cd_10285263_0_1"
        },
        "Text": "512 GB のストレージと 16 GB の RAM を備えた最高級の構成に、6,000 mAh のバッテリーと 100 W の高速充電技術を組み合わせ、パフォーマンスと耐久性の両方を提供し、技術トレンドをリードします。参考価格: 5,999–6,499。Alibaba Cloud Model Studio Ace Ultra — ゲーマーの選択: 6.67 インチ 1080 x 2400 ピクセルのスクリーン、10 GB の RAM、256 GB のストレージを搭載し、シルクのように滑らかなゲームプレイを保証します。液体冷却システムを備えた 5,500 mAh のバッテリーは、長時間のゲームセッションでも涼しく保ちます。高ダイナミックデュアルスピーカーは、没入感のあるサウンドエフェクトでゲーム体験をアップグレードします。参考価格: 3,999–4,299。Alibaba Cloud Model Studio Zephyr Z9 — 薄くてポータブルな芸術: 軽量な 6.4 インチ 1080 x 2340 ピクセルのデザインで、128 GB のストレージと 6 GB の RAM を備え、日常使用には十分すぎるほどです。4,000 mAh のバッテリーは、一日中安心して使用できます。30 倍のデジタルズームレンズで遠くのディテールを捉えます。薄くてもパワフルです。参考価格: 2,499–2,799。Alibaba Cloud Model Studio Flex Fold+ — 折りたたみ式スクリーンの新時代: 革新と豪華さを兼ね備え、7.6 インチ 1800 x 2400 ピクセルのメインスクリーンと 4.7 インチ 1080 x 2400 ピクセルの外部スクリーンを搭載。マルチアングル自由停止ヒンジ設計は、さまざまなシナリオのニーズに対応します。"
      }
    ]
  },
  "Code": "Success",
  "Success": "true"
}

ナレッジベースの更新

以下の例は、ドキュメント検索ナレッジベースを更新する方法を示しています。ナレッジベースを使用するアプリケーションは、更新をリアルタイムで反映します。新しいコンテンツは取得可能になり、削除されたコンテンツはアクセスできなくなります。
データクエリまたは画像 Q&A ナレッジベースは API を使用して更新することはできません。詳細については、「ナレッジベースの更新」をご参照ください。
  • 増分更新: サポートされている唯一の方法は、更新されたファイルをアップロードし、ファイルをナレッジベースに追加してから古いファイルを削除するという 3 段階のプロセスです。
  • 完全更新: ナレッジベース内の各ファイルについて、3 つのステップを実行して更新を完了します。
  • 自動更新または同期: 詳細については、「ナレッジベースを自動的に更新または同期する方法」をご参照ください。
  • 単一更新のファイル制限: 一度に更新するファイルは 10,000 ファイル以下にすることを推奨します。この制限を超えると、ナレッジベースが正しく更新されない可能性があります。

1. 更新されたファイルのアップロード

ナレッジベースの作成:ステップ 2 の手順に従って、更新されたファイルをナレッジベースを含むワークスペースにアップロードします。
更新されたファイル用に新しいアップロードパラメータのセットを生成するために、新しいファイルアップロードリースをリクエストしてください。

2. ナレッジベースへのファイルの追加

2.1. 追加タスクの送信

アップロードされたファイルが解析された後、SubmitIndexAddDocumentsJob 操作を呼び出して、新しいファイルをナレッジベースに追加し、ナレッジベースインデックスを再構築します。タスクを送信すると、Model Studio は非同期でナレッジベースを再構築します。この操作では、タスク ID (job_id) である Data.Id が返されます。次のステップでこの ID を使用して、タスクのステータスをクエリします。
  • SubmitIndexAddDocumentsJob 操作を呼び出した後、タスクが完了するまでには時間がかかります。 job_id を使用してタスクのステータスをクエリできます。 タスクが完了する前に再送信しないでください。
Python
def submit_index_add_documents_job(client, workspace_id, index_id, file_id, source_type):
    """
    解析済みのファイルをドキュメント検索ナレッジベースに追加してインポートします。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        index_id (str): ナレッジベース ID。
        file_id (str): ファイル ID。
        source_type(str): データの型。

    Returns:
        Alibaba Cloud Model Studio サービスからのレスポンス。
    """
    headers = {}
    submit_index_add_documents_job_request = bailian_20231229_models.SubmitIndexAddDocumentsJobRequest(
        index_id=index_id,
        document_ids=[file_id],
        source_type=source_type
    )
    runtime = util_models.RuntimeOptions()
    return client.submit_index_add_documents_job_with_options(workspace_id, submit_index_add_documents_job_request, headers, runtime)
{
  "IndexId": "mymxbdxxxx",
  "SourceType": "DATA_CENTER_FILE",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx",
  "DocumentIds": [
    "file_247a2fd456a349ee87d071404840109b_10xxxxxx"
  ]
}
{
  "Status": "200",
  "RequestId": "F693EB60-FEFC-559A-BF56-A41F52XXXXXX",
  "Message": "success",
  "Data": {
    "Id": "d8d189a36a3248438dca23c078xxxxxx"
  },
  "Code": "Success",
  "Success": "true"
}

2.2. タスク完了の待機

インデックス作成タスクの完了には時間がかかります。ピーク時には、このプロセスに数時間かかることがあります。GetIndexJobStatus 操作を呼び出して、その実行ステータスをクエリできます。応答の Data.Status フィールドの値が COMPLETED であることは、更新されたすべてのファイルがナレッジベースに正常に追加されたことを示します。
応答内の Documents リストには、指定した job_id に対応する追加タスク用のすべてのファイルが含まれています。
Python
def get_index_job_status(client, workspace_id, index_id, job_id):
    """
    インデックス作成タスクのステータスをクエリします。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        index_id (str): ナレッジベース ID。
        job_id (str): タスク ID。

    Returns:
        Alibaba Cloud Model Studio サービスからのレスポンス。
    """
    headers = {}
    get_index_job_status_request = bailian_20231229_models.GetIndexJobStatusRequest(
        index_id=index_id,
        job_id=job_id
    )
    runtime = util_models.RuntimeOptions()
    return client.get_index_job_status_with_options(workspace_id, get_index_job_status_request, headers, runtime)
{
  "IndexId": "mymxbdxxxx",
  "JobId": "76f243b9ee534d59a61f156ff0xxxxxx",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx"
}
{
  "Status": 200,
  "RequestId": "7F727D58-D90E-51E7-B56E-985A42XXXXXX",
  "Message": "success",
  "Data": {
    "Status": "COMPLETED",
    "Documents": [
      {
        "Status": "FINISH",
        "DocId": "file_247a2fd456a349ee87d071404840109b_10xxxxxx",
        "Message": "インポート成功",
        "DocName": "Alibaba Cloud Model Studio スマートフォン製品紹介",
        "Code": "FINISH"
      }
    ],
    "JobId": "76f243b9ee534d59a61f156ff0xxxxxx"
  },
  "Code": "Success",
  "Success": true
}

3. 古いファイルの削除

最後に、DeleteIndexDocument 操作を呼び出して、ナレッジベースから古いバージョンのファイルを永久に削除します。これにより、古い情報が誤って取得されるのを防ぎます。
  • file_id: 古いファイルの FileId を入力します。
インポートに失敗した (INSERT_ERROR) またはインポートに成功した (FINISH) ステータスのファイルのみを削除できます。ナレッジベース内のファイルのステータスをクエリするには、ListIndexDocuments 操作を呼び出すことができます。
Python
def delete_index_document(client, workspace_id, index_id, file_id):
    """
    指定されたドキュメント検索ナレッジベースから 1 つ以上のファイルを永久に削除します。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        index_id (str): ナレッジベース ID。
        file_id (str): ファイル ID。

    Returns:
        Alibaba Cloud Model Studio サービスからのレスポンス。
    """
    headers = {}
    delete_index_document_request = bailian_20231229_models.DeleteIndexDocumentRequest(
        index_id=index_id,
        document_ids=[file_id]
    )
    runtime = util_models.RuntimeOptions()
    return client.delete_index_document_with_options(workspace_id, delete_index_document_request, headers, runtime)
{
  "DocumentIds": [
    "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx"
  ],
  "IndexId": "mymxbdxxxx",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx"
}
{
  "Status": "200",
  "RequestId": "2D8505EC-C667-5102-9154-00B6FEXXXXXX",
  "Message": "success",
  "Data": {
    "DeletedDocument": [
      "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx"
    ]
  },
  "Code": "Success",
  "Success": "true"
}

ナレッジベースの管理

ナレッジベースの作成と使用は API を通じてサポートされていません。これらのタスクは Model Studio コンソールで実行する必要があります。

ナレッジベースの表示

指定されたワークスペース内のナレッジベースを表示するには、ListIndices 操作を呼び出します。
Python
def list_indices(client, workspace_id):
    """
    指定されたワークスペース内のナレッジベースの詳細を取得します。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。

    Returns:
        Alibaba Cloud Model Studio サービスからのレスポンス。
    """
    headers = {}
    list_indices_request = bailian_20231229_models.ListIndicesRequest()
    runtime = util_models.RuntimeOptions()
    return client.list_indices_with_options(workspace_id, list_indices_request, headers, runtime)
{
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx"
}
{
  "Status": "200",
  "RequestId": "5ACB2EB3-6C9A-5B0F-8E60-3FBE7EXXXXXX",
  "Message": "success",
  "Data": {
    "TotalCount": "1",
    "PageSize": "10",
    "PageNumber": "1",
    "Indices": [
      {
        "DocumentIds": [
          "file_0b21e0a852cd40cd9741c54fefbb61cd_10xxxxxx"
        ],
        "Description": "",
        "OverlapSize": 100,
        "SinkInstanceId": "gp-2zegk3i6ca4xxxxxx",
        "SourceType": "DATA_CENTER_FILE",
        "RerankModelName": "gte-rerank-hybrid",
        "SinkRegion": "cn-beijing",
        "Name": "Model Studio スマートフォンナレッジベース",
        "ChunkSize": 500,
        "EmbeddingModelName": "text-embedding-v2",
        "RerankMinScore": 0.01,
        "Id": "mymxbdxxxx",
        "SinkType": "BUILT_IN",
        "Separator": " |,|,|。|?|!|\n|\\?|\\!"
      }
    ]
  },
  "Code": "Success",
  "Success": "true"
}

ナレッジベースの削除

ナレッジベースを永久に削除するには、DeleteIndex 操作を呼び出します。ナレッジベースを削除する前に、Model Studio コンソールでリンクされているすべての Alibaba Cloud Model Studio アプリケーションから関連付けを解除する必要があります。そうしないと、削除は失敗します。注意:この操作では、カテゴリに追加したファイルは削除されません。
Python
def delete_index(client, workspace_id, index_id):
    """
    指定されたナレッジベースを永久に削除します。

    Args:
        client (bailian20231229Client): クライアント。
        workspace_id (str): ワークスペース ID。
        index_id (str): ナレッジベース ID。

    Returns:
        Alibaba Cloud Model Studio サービスからのレスポンス。
    """
    headers = {}
    delete_index_request = bailian_20231229_models.DeleteIndexRequest(
        index_id=index_id
    )
    runtime = util_models.RuntimeOptions()
    return client.delete_index_with_options(workspace_id, delete_index_request, headers, runtime)
{
  "IndexId": "mymxbdxxxx",
  "WorkspaceId": "llm-4u5xpd1xdjqpxxxx"
}
{
  "Status": "200",
  "Message": "success",
  "RequestId": "118CB681-75AA-583B-8D84-25440CXXXXXX",
  "Code": "Success",
  "Success": "true"
}

API

ナレッジベース API とそのリクエストおよびレスポンスパラメータの完全なリストについては、「API カタログ (ナレッジベース)」をご参照ください。

よくある質問

  1. ナレッジベースの更新と同期を自動化するにはどうすればよいですか?
    • ドキュメント検索
    • データクエリと画像 Q&A
    Object Storage Service (OSS)、Function Compute (FC)、および Model Studio ナレッジベースの API を統合します。以下の手順に従ってください:
    1. バケットの作成: OSS コンソールに移動して、ソースファイルを保存するための OSS バケットを作成します。
    2. ナレッジベースの作成: プライベートな知識コンテンツを保存するために、ドキュメント検索ナレッジベースを作成します。
    3. カスタム関数の作成: FC コンソールに移動し、追加や削除などのファイル変更イベント用の関数を作成します。「関数の作成」をご参照ください。これらの関数は、「ナレッジベースの更新」で説明されている関連 API を呼び出すことにより、OSS からナレッジベースへのファイル変更を同期します。
    4. OSS トリガーの作成: FC で、前のステップで作成したカスタム関数に OSS トリガーを関連付けます。OSS への新しいファイルのアップロードなど、ファイルの変更イベントが検出されると、トリガーがアクティブになり、FC が関数を実行します。「トリガー」をご参照ください。
  2. 新しいナレッジベースが空なのはなぜですか? これは通常、インデックスジョブの送信ステップが失敗した場合に発生します。CreateIndex API を呼び出しても SubmitIndexJob API の呼び出しが失敗すると、ナレッジベースは空になります。これを解決するには、再度インデックスジョブを送信し、インデックスジョブが完了するのを待ってください。
  3. 「アップロードしたファイルへのアクセスに失敗しました。アップロード操作が成功したか確認してください」というエラーが表示された場合はどうすればよいですか? このエラーは通常、ファイルを一時ストレージにアップロードするステップが正常に実行されなかったために発生します。AddFile API 操作を呼び出す前に、このステップが正常に実行されることを確認してください。
  4. 「アクセスが拒否されました:このワークスペースへのアクセス権がないか、ワークスペースが存在しません」というエラーが表示された場合はどうすればよいですか? このエラーは通常、以下の理由で発生します:
    • リクエストされたサービスエンドポイント (サービスエンドポイント) が正しくありません: インターネット経由でアクセスする場合、中国サイト (パブリッククラウド) のユーザーは中国 (北京) のサービスエンドポイントを使用し、国際サイトのユーザーはシンガポールのサービスエンドポイントを使用する必要があります。オンラインデバッグ機能を使用している場合は、次の図に示すように、正しいサービスエンドポイントを選択していることを確認してください。
      image
    • WorkspaceId の値が正しくない、またはワークスペースのメンバーではない場合: API を呼び出す前に、WorkspaceId が正しいこと、およびワークスペースのメンバーであることを確認してください。指定されたワークスペースへのメンバーの追加方法
  5. 「指定されたアクセスキーが見つからないか、無効です」というエラーが表示された場合はどうすればよいですか? このエラーは通常、指定された access_key_id または access_key_secret が正しくない場合、あるいは access_key_id が 無効化されている 場合に発生します。 API を呼び出す前に、access_key_id が正しく、無効化されていないことを確認してください。
  6. 「カテゴリが一致しません」というエラーが表示された場合はどうすればよいですか? このエラーは、ApplyFileUploadLease API 呼び出しで使用される CategoryId が、後続の AddFile API 呼び出しで渡される CategoryId と異なる場合に一般的に発生します。 ApplyFileUploadLease から AddFile までのファイルアップロードフロー全体を通して、必ず同じ CategoryId を使用してください。ListCategory API を呼び出して現在のワークスペースにあるカテゴリのリストを取得し、使用している CategoryId が正しいことを確認できます。

課金

  • すべてのナレッジベース機能と API 呼び出しは無料です。「ナレッジベース:課金」をご参照ください。
  • Model Studio にインポートされたファイルなどのデータのストレージスペースは無料です。

エラーコード

このトピックで説明されている API 操作の呼び出しが失敗した場合は、エラーセンターをご参照ください。