

本文介紹Qwen-Audio-ASR-Filetrans非即時語音辨識Python SDK的參數和介面細節。
關於支援的音頻格式、檔案大小限制、時間長度限制等輸入要求,請參見音頻規格。
以下範例使用 DashScope Python SDK 2.0。核心資源(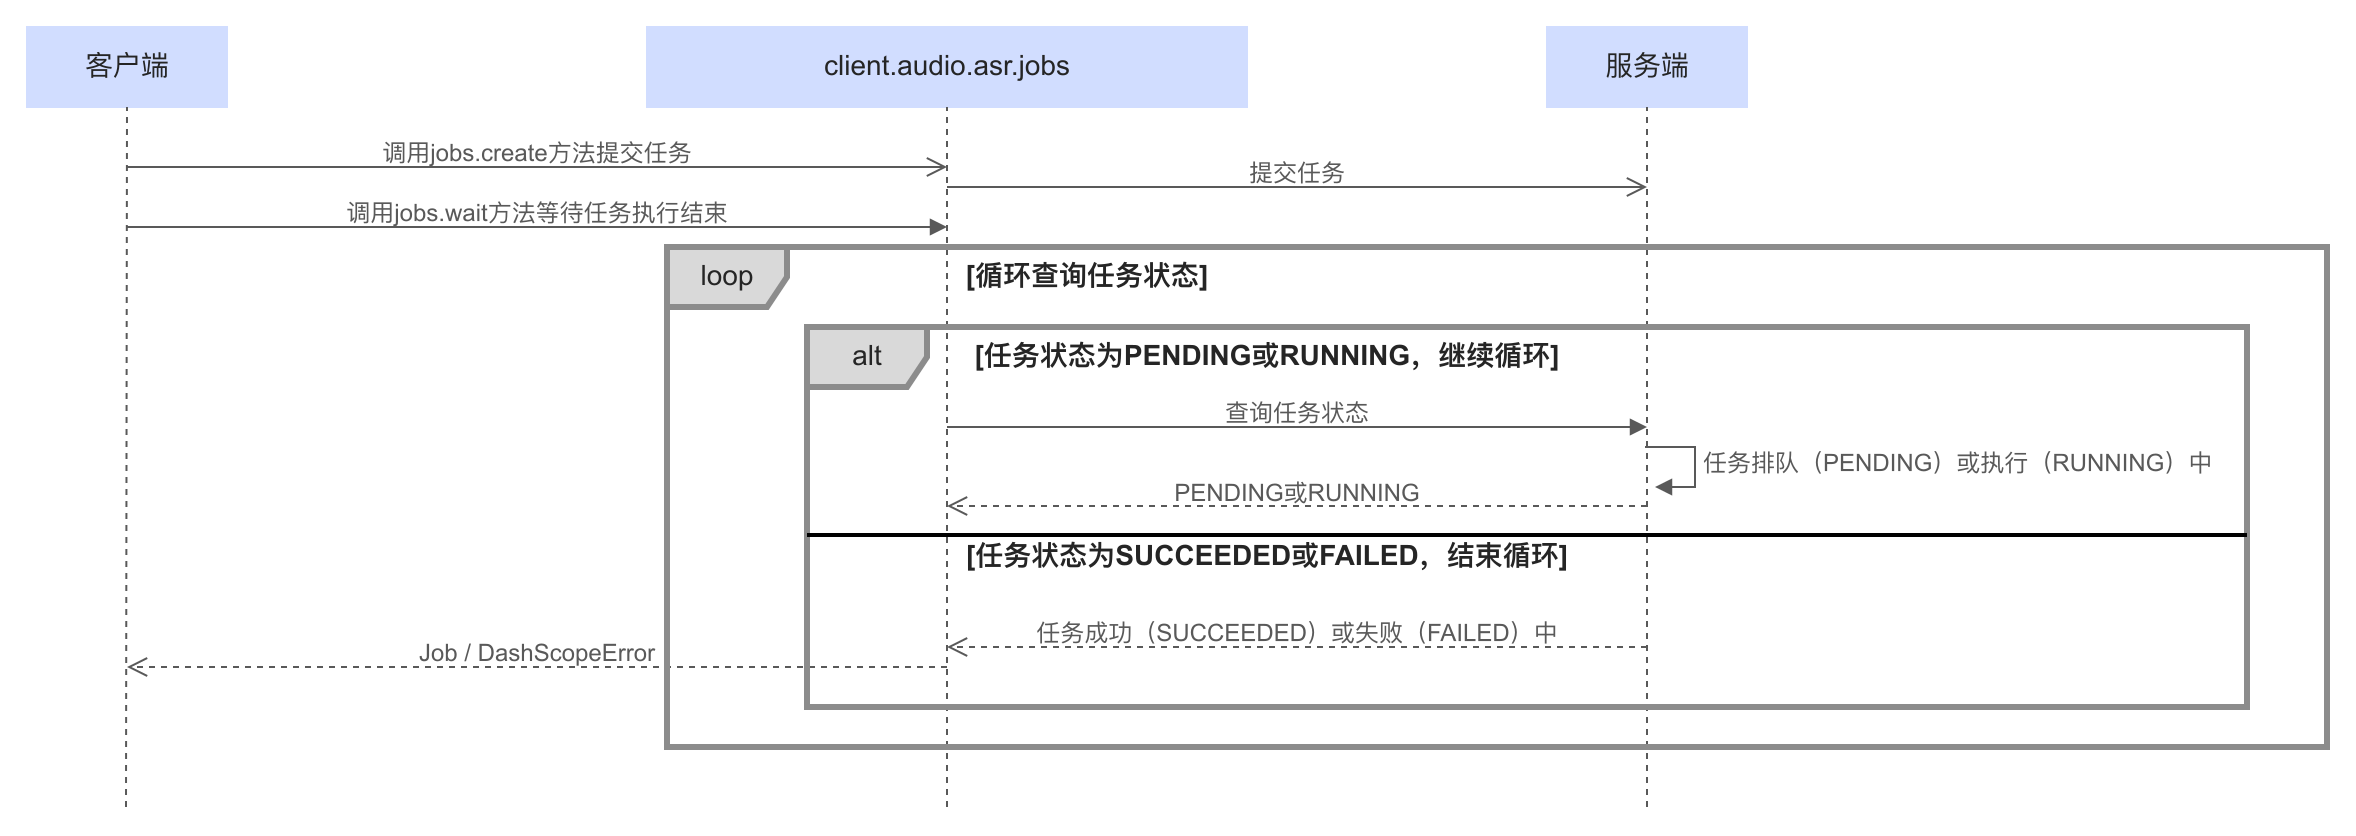
SDK 預設使用北京地區。建立
不同地區的 API Key 不同,請使用對應地區的 API Key。
透過
識別結果儲存為JSON檔案。
需要關注的參數如下:
透過
任務失敗時,預設擲回
不支援Base64編碼方式的音頻。僅支援可通過公網訪問的 URL 所指向的音訊識別,不支援識別二進位流,也不支援直接識別本地檔案。
通常遵循以下幾個步驟(這裡為您提供一種思路,具體情況因不同儲存產品而異,推薦將音頻上傳至阿里雲OSS):
使用SDK時,若錄音檔案儲存體在阿里雲OSS,不支援使用以
任務提交後將進入排隊(PENDING)狀態,排隊時間取決於隊列長度和檔案時間長度,無法明確給出,通常在數分鐘內,請耐心等待。並且音頻時間長度越長,所需時間越久。
如遇代碼報錯問題,請根據錯誤碼中的資訊進行排查。
可能是限流原因,請耐心等待。
請檢查音頻格式和採樣率是否正確且符合參數約束。
可以使用ffprobe工具擷取音訊容器、編碼、採樣率、聲道等資訊:
前提條件
- 已開通服務並擷取API Key。請配置API Key到環境變數,而非寫入程式碼在代碼中,防範因代碼泄露導致的安全風險。
- 安裝最新版DashScope SDK。
快速開始
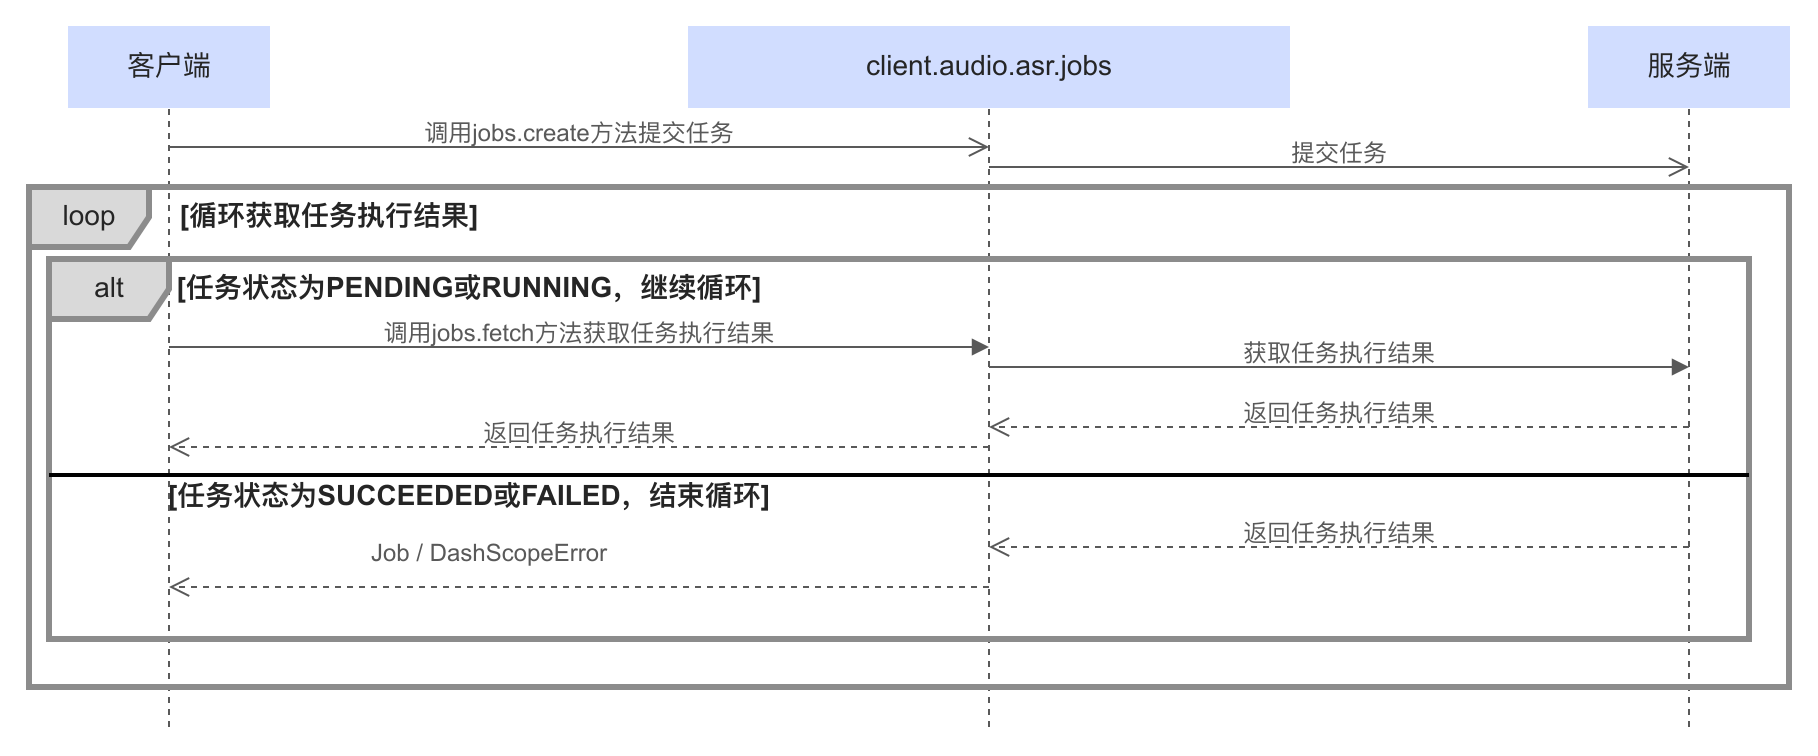
以下範例使用 DashScope Python SDK 2.0。核心資源(client.audio.asr)提供任務提交、等待和查詢介面,可透過以下兩種方式呼叫:
- 非同步提交任務+同步等待任務結束:提交任務後,阻塞當前線程直到任務結束並擷取識別結果。
- 非同步提交任務+非同步查詢任務執行結果:提交任務後,在需要的時候通過調用查詢任務介面擷取任務的執行結果。
- 非同步提交任務+同步等待任務結束
- 非同步提交任務+非同步查詢任務執行結果
-
呼叫
client.audio.asr.jobs.create提交任務並設定請求參數。- 檔案轉寫服務對通過API提交的任務採取儘力服務原則進行處理。任務提交後將進入排隊(
PENDING)狀態,排隊時間取決於隊列長度和檔案時間長度,無法明確給出,通常在數分鐘內。任務開始處理後,語音辨識將以數百倍加速完成。 - 每一個任務完成後,識別結果和URL下載連結有效期間為24小時,逾時後無法查詢任務或通過先前查詢結果中的URL下載結果。
- 檔案轉寫服務對通過API提交的任務採取儘力服務原則進行處理。任務提交後將進入排隊(
-
呼叫
client.audio.asr.jobs.wait(job=job)同步等待任務結束。 任務處於PENDING或RUNNING狀態時,jobs.wait持續等待;任務成功後傳回Job。 介面傳回Job,可透過job.results取得結果清單,其中的transcription_url為轉寫結果下載位址。
介面地址
SDK 預設使用北京地區。建立 dashscope.Client 時,透過 region 指定地區,透過 workspace 指定業務空間。地區設定僅作用於該 Client。
- 新加坡
- 華北2(北京)
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1調用時請將{WorkspaceId}替換為真實的業務空間ID。請求參數
透過 client.audio.asr.transcribe 或 client.audio.asr.jobs.create 設定請求參數。
| 參數 | 類型 | 是否必須 | 說明 |
|---|---|---|---|
model | str | 是 | 模型名稱。 |
file_urls | list[str] | 是 | 音視頻檔案轉寫的URL列表,支援HTTP / HTTPS協議,單次請求僅支援1個URL。關於支援的音頻格式、檔案大小限制、時間長度限制等輸入要求,請參見音頻規格。若錄音檔案儲存體在阿里雲OSS,使用RESTful API方式支援使用以oss://為首碼的臨時 URL,使用SDK方式不支援使用以 oss://為首碼的臨時 URL。 |
parameters.keep_dialect | bool | 否 | 僅 qwen-audio-3.1-asr-flash-filetrans 支援。預設值為 false:將方言轉寫為普通話;設為 true 時保留方言表達。 |
parameters.vocabulary_id | str | 否 | 先行編譯熱詞列表 ID。需預先調用建立熱詞列表介面產生,識別時傳入該 ID 即可使用列表中的熱詞。適用於詞彙已知且相對穩定、需要跨請求複用同一詞表的情境。使用方法請參見先行編譯熱詞。 |
parameters.vocabulary | dict | 否 | 即時熱詞。以索引值對形式傳入,鍵為熱詞文本(string),值為熱詞權重(integer),無需預先建立熱詞列表。權重取值範圍為 [1, 5] 或 50:取 [1, 5] 時值越大模型越傾向輸出該詞;取 50 時為超級熱詞,召回率大幅提升,但超級熱詞數量最多不超過 50 個。適用於臨時性、會話層級的熱詞最佳化。與預編譯熱詞同時設定時,系統會合併兩類熱詞;合併後超過 2000 個時,隨機選擇 2000 個使用。使用方法請參見即時熱詞。樣本:以下範例重用快速入門中已設定地區和業務空間的 client。 |
parameters.channel_id | list[int] | 否 | 指定在多音軌音頻檔案中需要識別的音軌索引,索引從 0 開始。例如,[0] 表示識別第一個音軌,[0, 1] 表示同時識別第一和第二個音軌。如果省略此參數,則預設處理第一個音軌。預設值:[0]。 |
parameters.special_word_filter | str | 否 | 指定在語音辨識過程中需要處理的敏感詞,並支援對不同敏感詞設定不同的處理方式。詳情請參見敏感詞過濾。 |
parameters.diarization_enabled | bool | 否 | 是否啟用說話人分離,預設關閉。僅適用於單聲道音頻,多頻道音訊不支援說話人分離。啟用該功能後,識別結果中將顯示speaker_id欄位,用於區分不同說話人。如果啟用說話人分離功能,建議音頻時間長度不超過2小時,否則可能導致識別失敗或逾時。 speaker_id的樣本,請參見識別結果說明。 |
parameters.speaker_count | int | 否 | 說話人數量參考值。取值範圍為2至100的整數(包含2和100)。預設自動判斷說話人數量,如果配置此項,只能輔助演算法盡量輸出指定人數,無法保證一定會輸出此人數。無預設值。 |
parameters.language_hints | list[str] | 否 | 設定待識別語言代碼。如果無法提前確定語種,可不設定,模型會自動識別語種。最多支援設定 4 個值,超出時僅前 4 個生效。
點擊查看支援的語言代碼
|
響應結果
Job
Job 封裝任務資訊、原始輸出和用量資訊。
| 欄位 | 說明 |
|---|---|
task_id | 任務 ID。 |
status | 任務狀態:PENDING、RUNNING、SUCCEEDED 或 FAILED。 |
submitted_at | 提交時間,對應 job.output["submit_time"]。 |
scheduled_at | 開始處理時間,對應 job.output["scheduled_time"]。 |
finished_at | 結束時間,對應 job.output["end_time"]。 |
output | 原始任務輸出字典。 |
results | 子任務結果清單,可透過 job.results 讀取;下載 transcription_url 指向的 JSON 檔案可取得辨識文字。 |
usage | 任務用量資訊。 qwen-audio-3.1-asr-flash-filetrans 使用 input_tokens、output_tokens 和 total_tokens 統計 Token 用量;qwen-audio-3.0-asr-flash-filetrans 按 duration 計量。 |
Job.output
job.output 是服務端傳回的原始任務輸出字典。
- PENDING
- RUNNING
- SUCCEEDED
- FAILED (raise_on_error=False)
| 參數 | 說明 |
|---|---|
code | 代表錯誤碼。可以結合message欄位,對照錯誤碼排查問題。 |
message | 代表錯誤資訊。可以結合code欄位,對照錯誤碼排查問題。 |
task_id | 任務ID。 |
task_status | 任務狀態。有PENDING、RUNNING、SUCCEEDED和FAILED這四種狀態。當任務包含多個子任務時,只要存在任一子任務成功,整個任務狀態將標記為SUCCEEDED,需通過subtask_status欄位判斷具體子任務結果。 |
results | 子任務識別結果。 |
subtask_status | 子任務狀態。有PENDING、RUNNING、SUCCEEDED和FAILED這四種狀態。 |
file_url | 被識別音訊URL。 |
transcription_url | 音頻識別結果對應的URL。識別結果以JSON格式儲存在一個JSON檔案中,您可以通過transcription_url對應的連結下載檔案或直接通過HTTP請求讀取該檔案中的內容。JSON檔案的內容請參見識別結果說明。 |
識別結果說明
識別結果儲存為JSON檔案。
| 參數 | 類型 | 說明 |
|---|---|---|
audio_format | string | 源檔案中音訊格式。 |
channels | array[integer] | 源檔案中音訊音軌索引資訊,對單軌音頻返回[0],對雙軌音頻返回[0, 1],以此類推。 |
original_sampling_rate | integer | 源檔案中音訊採樣率(Hz)。 |
original_duration_in_milliseconds | integer | 源檔案中的原始音頻時間長度(ms)。 |
channel_id | integer | 轉寫結果的音軌索引,以0為起始。 |
content_duration | integer | 音軌中被判定為語音內容的時間長度(ms)。 以下計費說明適用於 qwen-audio-3.0-asr-flash-filetrans。qwen-audio-3.1-asr-flash-filetrans 按 Token 計費。 |
transcript | string | 段落層級的語音轉寫結果。 |
sentences | array | 句子層級的語音轉寫結果。 |
words | array | 詞層級的語音轉寫結果。 |
begin_time | integer | 開始時間戳(ms)。 |
end_time | integer | 結束時間戳記(ms)。 |
text | string | 語音轉寫結果。 |
speaker_id | integer | 當前說話人的索引,以0為起始,用於區分不同的說話人。僅在啟用說話人分離功能時,該欄位才會顯示於識別結果中。 |
punctuation | string | 預測出的詞之後的標點符號(如有)。 |
關鍵介面
核心資源(client.audio.asr)
透過 dashscope.Client 建立用戶端後,使用 client.audio.asr 資源。以下方法均傳回 Job。
| 方法 | 方法簽章 | 說明 |
|---|---|---|
transcribe | 提交任務並同步等待完成。預設模型為 qwen-audio-3.1-asr-flash-filetrans;呼叫其他模型時明確設定 model。 | |
jobs.create | 提交任務,傳回包含 task_id 和 status 的 Job,不等待辨識完成。 | |
jobs.wait | 傳入 Job 或任務 ID,同步等待任務完成。透過 poll_interval 和 max_interval 設定初始和最大輪詢間隔,透過 timeout 設定總等待時間,單位均為秒。 | |
jobs.fetch | 透過任務 ID 查詢一次任務狀態和結果,不阻塞等待任務完成。 |
錯誤碼
任務失敗時,預設擲回 DashScopeError。如需取得失敗任務的 Job,在建立 Client 時設定 raise_on_error=False,並檢查 job.status。
如遇報錯問題,請參見錯誤碼進行排查。
當任務包含多個子任務時,只要存在任一子任務成功,整個任務狀態將標記為SUCCEEDED,需通過subtask_status欄位判斷具體子任務結果。
錯誤返回樣本:
常見問題
功能特性
Q:是否支援Base64編碼方式的音頻?
不支援Base64編碼方式的音頻。僅支援可通過公網訪問的 URL 所指向的音訊識別,不支援識別二進位流,也不支援直接識別本地檔案。
Q:如何將音頻檔案以公網可訪問的URL形式提供?
通常遵循以下幾個步驟(這裡為您提供一種思路,具體情況因不同儲存產品而異,推薦將音頻上傳至阿里雲OSS):
1、選擇儲存和託管方式
1、選擇儲存和託管方式
如以下這幾種:
-
Object Storage Service服務(推薦):
- 使用雲端服務商的Object Storage Service服務(如阿里雲OSS),將音頻檔案上傳到儲存桶中,並設定為公開訪問。
- 優點:高可用性、支援 CDN 加速、易於管理。
-
Web 服務器:
- 將音頻檔案放置在支援 HTTP/HTTPS 訪問的 Web 服務器上(如 Nginx、Apache)。
- 優點:適合小型專案或本地測試。
-
內容分發網路(CDN):
- 將音頻檔案託管在 CDN 上,通過 CDN 提供的 URL 訪問。
- 優點:加速檔案傳輸,適合高並發情境。
2、上傳音頻檔案
2、上傳音頻檔案
根據選擇的儲存/託管方式,將音頻上傳,如:
-
Object Storage Service服務:
- 登入雲端服務商的控制台,建立儲存桶。
- 上傳音頻檔案,並設定檔案許可權為“公用讀取”或產生臨時訪問連結。
-
Web 服務器:
- 將音頻檔案放置在伺服器指定目錄下(如
/var/www/html/audio/)。 - 確保檔案可以通過 HTTP/HTTPS 訪問。
- 將音頻檔案放置在伺服器指定目錄下(如
3、產生公網可訪問的URL
3、產生公網可訪問的URL
例如:
-
Object Storage Service服務:
- 檔案上傳後,系統會自動產生一個公網存取 URL(通常格式為
https://<bucket-name>.<region>.aliyuncs.com/<file-name>)。 - 如果需要更友好的網域名稱,可以綁定自訂網域名並開啟 HTTPS。
- 檔案上傳後,系統會自動產生一個公網存取 URL(通常格式為
-
Web 服務器:
- 檔案的存取 URL 通常是伺服器位址加上檔案路徑(如
https://your-domain.com/audio/file.mp3)。
- 檔案的存取 URL 通常是伺服器位址加上檔案路徑(如
-
CDN:
- 配置 CDN 加速後,使用 CDN 提供的 URL(如
https://cdn.your-domain.com/audio/file.mp3)。
- 配置 CDN 加速後,使用 CDN 提供的 URL(如
4、驗證URL的可用性
4、驗證URL的可用性
公網環境下,確保產生的 URL 可以正常訪問,例如:
- 在瀏覽器中開啟 URL,檢查是否能播放音頻檔案。
- 使用工具(如
curl或 Postman)驗證 URL 是否返回正確的 HTTP 響應(狀態代碼 200)。
oss://為首碼的臨時 URL。
使用RESTful API時,若錄音檔案儲存體在阿里雲OSS,支援使用以 oss://為首碼的臨時 URL: