

Este tópico descreve os parâmetros e os detalhes da API do SDK Java para reconhecimento de fala não em tempo real Fun-ASR.
Para requisitos de entrada, como formatos de áudio suportados, limites de tamanho de arquivo e limites de duração, consulte Audio specifications.
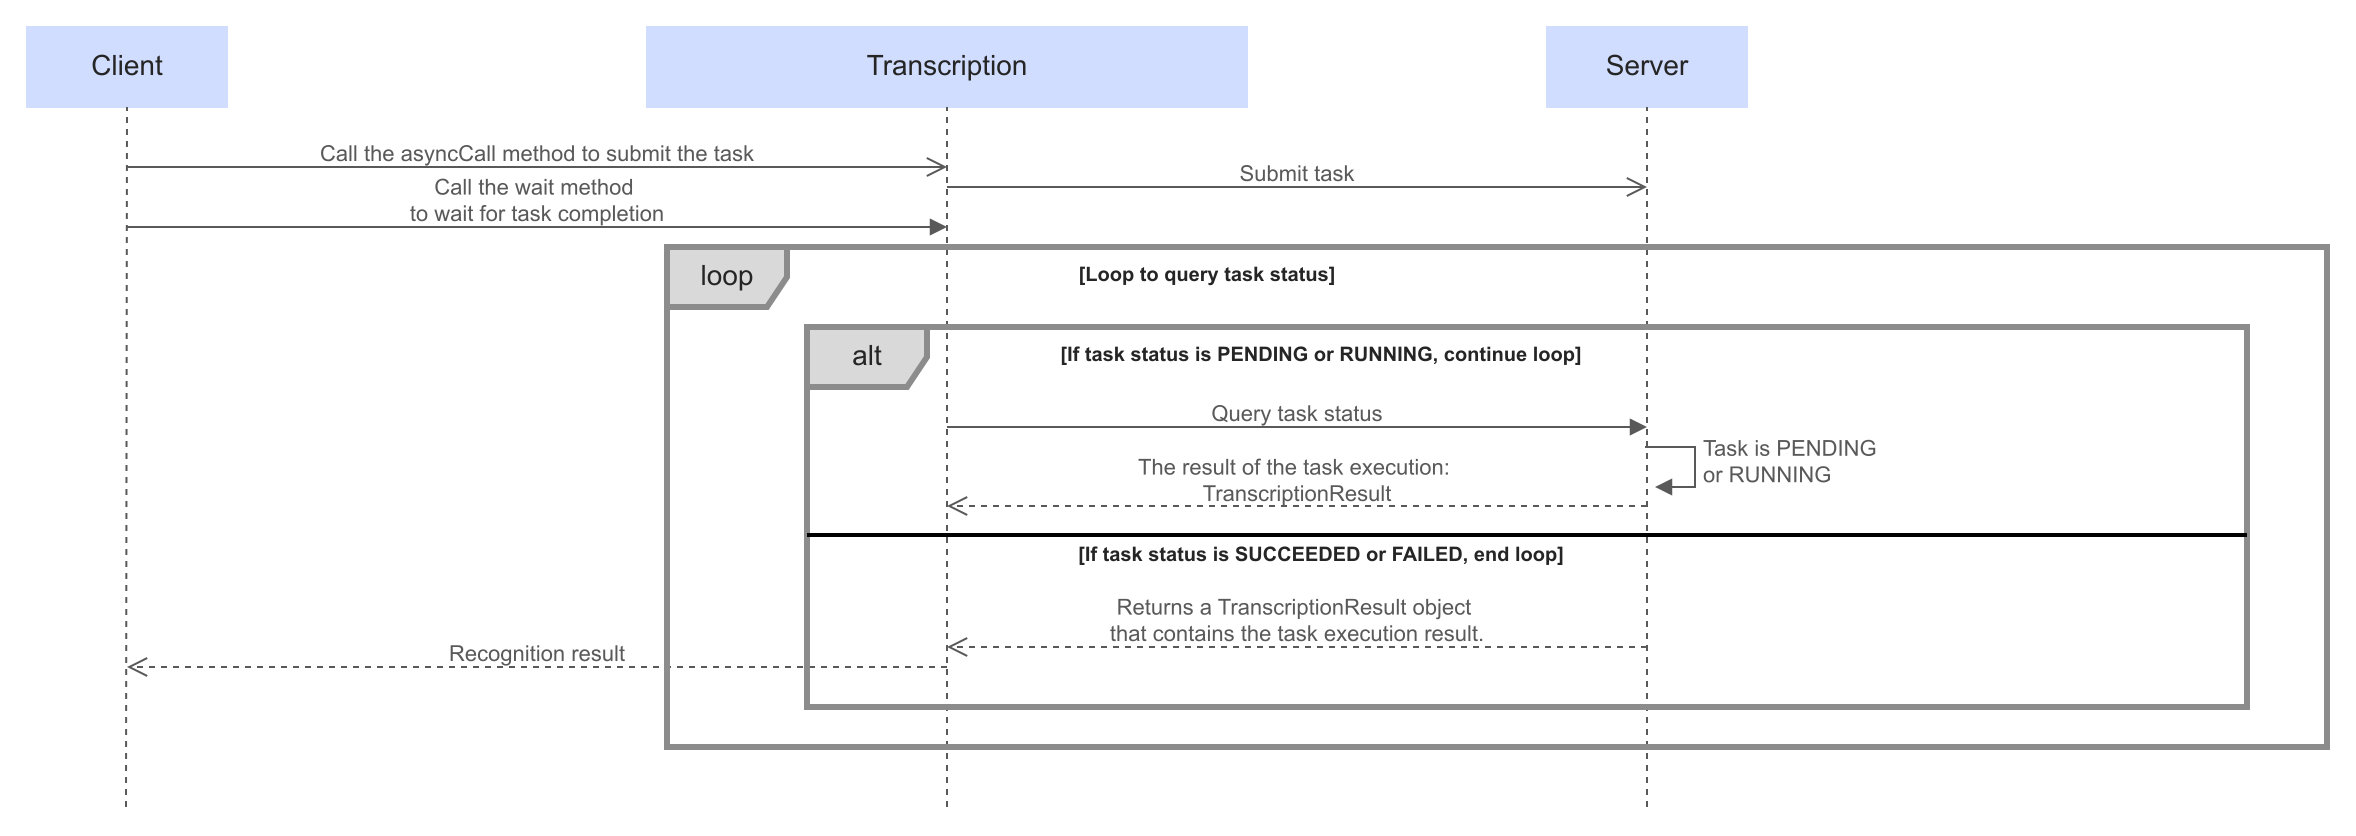
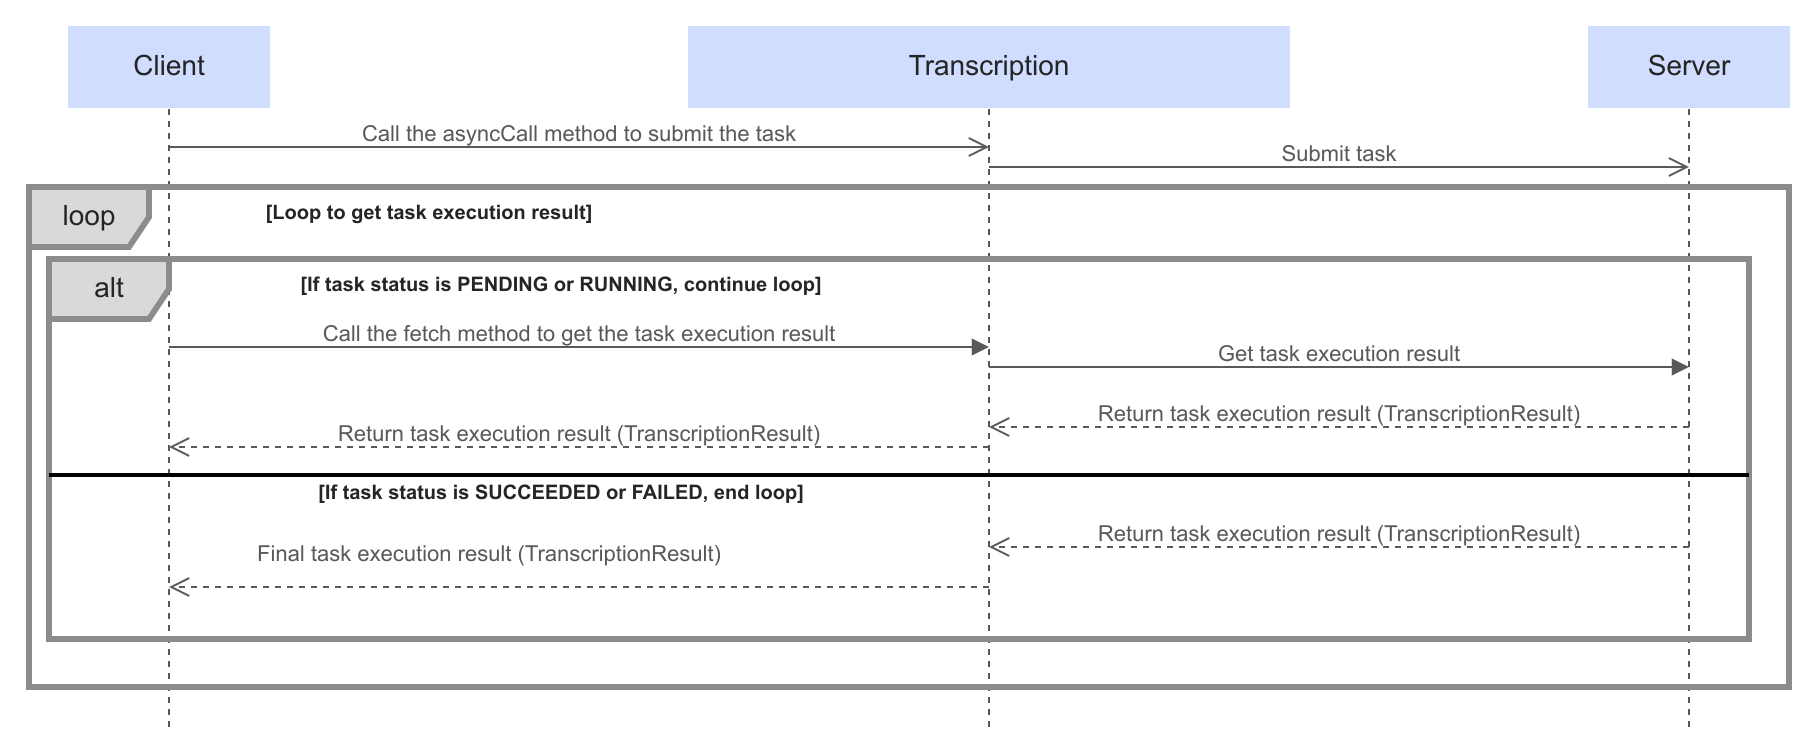
O Core class (Transcription) fornece interfaces para enviar uma tarefa de forma assíncrona, aguardar sincronamente a conclusão da tarefa e consultar o resultado da tarefa de forma assíncrona. Execute o reconhecimento de fala não em tempo real de uma das duas maneiras seguintes:
Por padrão, o SDK usa o endpoint da região China (Beijing). Para mudar para outra região, modifique
Nota:
Configure os parâmetros de solicitação usando os métodos encadeados de
O
O
O resultado do reconhecimento é salvo como um arquivo JSON.
Os seguintes parâmetros merecem atenção:
O
Importe
Se encontrar um erro, consulte Error codes para solução de problemas.
Quando uma tarefa contém várias subtarefas, o status geral da tarefa é marcado como
Áudio codificado em Base64 não é suportado. Apenas áudio em uma URL acessível publicamente pode ser reconhecido. Fluxos binários e arquivos locais não podem ser reconhecidos diretamente.
As etapas típicas são as seguintes. Esta é uma abordagem; o processo exato varia conforme o product de armazenamento. Recomendamos que você upload the audio to Alibaba Cloud OSS:
Ao usar o SDK, se os arquivos de áudio estiverem armazenados no Alibaba Cloud OSS, URLs temporárias com o prefixo
Após o envio de uma tarefa, ela entra no estado de fila (PENDING). O tempo de espera depende do tamanho da fila e da duração do áudio, portanto não pode ser afirmado com exatidão, mas geralmente fica dentro de alguns minutos. Em geral, quanto mais longo o áudio, mais tempo leva.
Se o seu código retornar um erro, solucione-o com base nas informações em Error codes.
Isso pode ser causado por limitação de taxa. Aguarde um momento e tente novamente.
Verifique se o formato de áudio e a taxa de amostragem estão corretos e atendem às restrições de parâmetros.
Use a ferramenta ffprobe para obter o container de áudio, codec, taxa de amostragem, canais e outros detalhes:
Pré-requisitos
- Você ativou o service e Obtain an API key. Utilize Configure API key as an environment variable em vez de codificá-la diretamente no seu código para evitar riscos de segurança causados por vazamento de código.
- Install the latest DashScope SDK.
Início rápido
O Core class (Transcription) fornece interfaces para enviar uma tarefa de forma assíncrona, aguardar sincronamente a conclusão da tarefa e consultar o resultado da tarefa de forma assíncrona. Execute o reconhecimento de fala não em tempo real de uma das duas maneiras seguintes:
- Envie uma tarefa de forma assíncrona e aguarde sincronamente sua conclusão: após enviar a tarefa, a thread atual é bloqueada até que a tarefa termine e o resultado do reconhecimento seja retornado.
- Envie uma tarefa de forma assíncrona e consulte o resultado da tarefa de forma assíncrona: após enviar a tarefa, chame a interface de consulta para obter o resultado da tarefa sempre que necessário.
- Enviar uma tarefa de forma assíncrona e aguardar sincronamente sua conclusão
- Enviar uma tarefa de forma assíncrona e consultar o resultado da tarefa de forma assíncrona
- Configure o Request parameters.
- Instancie um Core class (Transcription).
-
Chame o método
asyncCalldo Core class (Transcription) para enviar a tarefa de forma assíncrona.- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
PENDING). O tempo de espera depende do tamanho da fila e da duração do arquivo, portanto não pode ser definido com precisão, mas geralmente fica dentro de alguns minutos. Assim que o processamento começa, o reconhecimento de fala é concluído a uma velocidade centenas de vezes superior ao tempo real. - Após a conclusão de cada tarefa, o resultado do reconhecimento e a URL de download permanecem válidos por 24 horas. Depois que expiram, não é mais possível consultar a tarefa ou baixar o resultado pela URL retornada em uma consulta anterior.
- O service de transcrição de arquivos processa tarefas enviadas por meio da API com base no melhor esforço. Após o envio, a tarefa entra no estado de fila (
-
Chame o método
waitdo Core class (Transcription) para aguardar sincronamente a conclusão da tarefa. Uma tarefa pode estar no estadoPENDING,RUNNING,SUCCEEDEDouFAILED. Enquanto a tarefa estiver no estadoPENDINGouRUNNING, a interfacewaitpermanece bloqueada. Quando a tarefa atinge o estadoSUCCEEDEDouFAILED, a interfacewaitdesbloqueia e retorna o resultado da tarefa. O métodowaitretorna um Task result (TranscriptionResult).
Endpoints
Por padrão, o SDK usa o endpoint da região China (Beijing). Para mudar para outra região, modifique Constants.baseHttpApiUrl antes da inicialização.
- Singapore
- China (Beijing)
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1Ao fazer uma chamada, substitua {WorkspaceId} pelo seu Workspace ID real.- As API keys diferem entre regiões. Certifique-se de usar a API key correspondente à região de destino.
- A configuração de região é global e afeta as chamadas de API de todos os SDKs DashScope.
Parâmetros de solicitação
Configure os parâmetros de solicitação usando os métodos encadeados de TranscriptionParam.
| Parâmetro | Tipo | Obrigatório | Descrição |
|---|---|---|---|
model | String | Sim | O nome do modelo. |
fileUrls | List<String> | Sim | Lista de URLs dos arquivos de áudio ou vídeo a serem transcritos. HTTP e HTTPS são suportados. Uma única solicitação suporta apenas uma URL. Para requisitos de entrada, como formatos de áudio suportados, limites de tamanho de arquivo e limites de duração, consulte Audio specifications.Se a gravação estiver armazenada no Alibaba Cloud OSS, a API RESTful suporta URLs temporárias com o prefixo oss://, enquanto o SDK não suporta URLs temporárias com prefixo oss://. |
vocabularyId | String | Não | ID de uma lista de palavras-chave pré-compilada.Gere esse ID antecipadamente chamando a API de criação de lista de palavras-chave. Passe o ID durante o reconhecimento para usar as palavras-chave da lista.Indicado para cenários onde o vocabulário é conhecido e relativamente estável, e onde você precisa reutilizar a mesma lista de palavras entre solicitações.Para detalhes de uso, consulte Precompiled hotwords. |
vocabulary | Map<String, Integer> | Não | Hotwords instantâneas. Passe pares de chave-valor em que as chaves são os textos das hotwords (string) e os valores são pesos inteiros (integer). Não é necessário criar uma lista pré-compilada.Para saber como usar, consulte Hotwords instantâneas.Defina vocabulary através do método parameter ou do método parameters da instância TranscriptionParam: |
channelId | List<Integer> | Não | Índice das faixas de áudio a serem reconhecidas em um arquivo de áudio multifaixa. O índice começa em 0. Por exemplo, [0] reconhece a primeira faixa, e [0, 1] reconhece a primeira e a segunda faixas simultaneamente. Se você omitir este parâmetro, apenas a primeira faixa será processada.Valor padrão: [0]. |
specialWordFilter | String | Não | Palavras sensíveis a serem processadas durante o reconhecimento de fala. Você pode definir um método de tratamento diferente para cada palavra sensível. Para detalhes, consulte Sensitive word filtering. |
diarizationEnabled | Boolean | Não | Se deve ativar a diarização de falantes. Desativado por padrão.Aplica-se apenas a áudio mono. Áudio multicanal não suporta diarização de falantes.Quando ativado, o resultado do reconhecimento inclui um campo speaker_id que distingue diferentes falantes.Quando a diarização de falantes estiver ativada, mantenha a duração do áudio dentro de 2 horas. Caso contrário, o reconhecimento pode falhar ou atingir o tempo limite. speaker_id, consulte Recognition result description. |
speakerCount | Integer | Não | Valor de referência para o número de falantes. O intervalo válido é um número inteiro de 2 a 100 (inclusive).Por padrão, o número de falantes é detectado automaticamente. Se você definir este valor, ele apenas orientará o algoritmo a gerar a contagem especificada quando possível, sem garantir essa contagem exata.Sem valor padrão. |
language_hints | String[] | Não | Códigos de idioma a serem reconhecidos. Se não for possível determinar o idioma antecipadamente, deixe sem definir e o modelo detectará o idioma automaticamente.Você pode definir até 1 valor. Se definir mais, apenas os 1 primeiros serão usados.
Clique para visualizar os códigos de idioma suportados
language_hints através do método parameter ou do método parameters da instância TranscriptionParam: |
apiKey | String | Não | Sua API key. Se você configurou a API key como uma variável de ambiente, não precisa defini-la no seu código. Caso contrário, você deve defini-la no seu código. |
Resposta
Resultado da tarefa (TranscriptionResult)
O TranscriptionResult encapsula o resultado da tarefa atual.
| Interface/Método | Parâmetro | Valor de retorno | Descrição |
|---|---|---|---|
Nenhum | requestId | Obtém o requestId. | |
Nenhum | taskId | Obtém o taskId. | |
Nenhum | TaskStatus, o status da tarefa | Obtém o status da tarefa.TaskStatus é uma enumeração. Você só precisa se concentrar nos quatro estados seguintes: PENDING, RUNNING, SUCCEEDED e FAILED.Quando uma tarefa contém várias subtarefas, o status geral da tarefa é marcado como SUCCEEDED desde que qualquer subtarefa tenha sucesso. Use o campo subtask_status para verificar o resultado de cada subtarefa individualmente. | |
Nenhum | Subtask result (TranscriptionTaskResult) | Obtém o Subtask result (TranscriptionTaskResult).Cada tarefa reconhece um ou mais arquivos de áudio. Arquivos de áudio diferentes são processados em subtarefas separadas, portanto cada tarefa corresponde a uma ou mais subtarefas. | |
Nenhum | O resultado da tarefa, em formato JSON | Obtém o resultado da tarefa.O resultado consiste em dados no formato JSON. Se quiser obter o resultado da tarefa através da interface getOutput, faça a análise por conta própria após obter o resultado.
Clique para visualizar o exemplo JSON Exemplo de sucesso code é o código de erro e message é a mensagem de erro. Esses dois campos aparecem apenas quando ocorre um erro. Você pode usá-los, juntamente com o Error codes, para solucionar o problema. |
Resultado da subtarefa (TranscriptionTaskResult)
O TranscriptionTaskResult encapsula o resultado de uma subtarefa. Uma subtarefa reconhece um único arquivo de áudio.
| Interface/Método | Parâmetro | Valor de retorno | Descrição |
|---|---|---|---|
Nenhum | URL do arquivo de áudio reconhecido | Obtém a URL do arquivo de áudio reconhecido. | |
Nenhum | URL do resultado do reconhecimento | Obtém a URL do resultado do reconhecimento. Esta URL é válida por 24 horas. Após a expiração, não é mais possível consultar a tarefa ou baixar o resultado pela URL retornada em uma consulta anterior.O resultado do reconhecimento é salvo como um arquivo JSON. Baixe o arquivo através da URL ou leia seu conteúdo diretamente através de uma solicitação HTTP.Para o significado de cada campo nos dados JSON, consulte Recognition result description. | |
Nenhum | TaskStatus, o status da subtarefa | Obtém o status da subtarefa.TaskStatus é uma enumeração. Você só precisa se concentrar nos quatro estados seguintes: PENDING, RUNNING, SUCCEEDED e FAILED. | |
Nenhum | Informações importantes geradas durante a execução da tarefa, que podem estar vazias | Obtém as informações importantes geradas durante a execução da tarefa.Quando uma tarefa falha, verifique este conteúdo para analisar a causa. |
Descrição do resultado do reconhecimento
O resultado do reconhecimento é salvo como um arquivo JSON.
| Parâmetro | Tipo | Descrição |
|---|---|---|
audio_format | string | Formato de áudio do arquivo de origem. |
channels | array[integer] | Índice da faixa de áudio no arquivo de origem. Para áudio de faixa única, [0] é retornado; para áudio de duas faixas, [0, 1] é retornado; e assim por diante. |
original_sampling_rate | integer | Taxa de amostragem (Hz) do áudio no arquivo de origem. |
original_duration_in_milliseconds | integer | Duração original do áudio (ms) no arquivo de origem. |
channel_id | integer | Índice da faixa do resultado da transcrição, começando em 0. |
content_duration | integer | Duração (ms) do conteúdo na faixa identificado como fala.O service de modelo de reconhecimento de fala transcreve apenas o conteúdo de uma faixa identificado como fala, medindo e faturando com base nessa duração. Conteúdo que não seja fala não é medido nem faturado. Normalmente, a duração do conteúdo de fala é menor que a duração original do áudio. Como a existência de conteúdo de fala é determinada por um modelo de IA, o resultado pode diferir ligeiramente da situação real. |
transcript | string | Resultado da transcrição no nível de parágrafo. |
sentences | array | Resultado da transcrição no nível de sentença. |
words | array | Resultado da transcrição no nível de palavra. |
begin_time | integer | Carimbo de data/hora inicial (ms). |
end_time | integer | Carimbo de data/hora final (ms). |
text | string | Resultado da transcrição. |
speaker_id | integer | Índice do falante atual, começando em 0, usado para distinguir entre diferentes falantes.Este campo aparece no resultado do reconhecimento apenas quando a diarização de falantes está ativada. |
punctuation | string | Pontuação prevista após a palavra, se houver. |
Interfaces principais
Classe de parâmetros de consulta de tarefa (TranscriptionQueryParam)
O TranscriptionQueryParam é usado ao aguardar a conclusão de uma tarefa (chamando o método wait de Transcription) ou ao consultar o resultado da tarefa (chamando o método fetch de Transcription).
Crie uma instância de TranscriptionQueryParam através do método estático FromTranscriptionParam.
| Interface/método | Parâmetros | Valor de retorno | Descrição |
|---|---|---|---|
| uma instância de TranscriptionQueryParam | Cria uma instância de TranscriptionQueryParam. |
Classe principal (Transcription)
Importe Transcription com import com.alibaba.dashscope.audio.asr.transcription.*;. Suas interfaces principais são as seguintes:
| Interface/método | Parâmetros | Valor de retorno | Descrição |
|---|---|---|---|
param: os parâmetros de reconhecimento de fala, uma instância de TranscriptionParam | Task result (TranscriptionResult) | Envia uma tarefa de reconhecimento de fala de forma assíncrona. | |
queryParam: uma instância de TranscriptionQueryParam | Task result (TranscriptionResult) | Bloqueia a thread atual até que a tarefa assíncrona termine (o status da tarefa é SUCCEEDED ou FAILED). | |
queryParam: uma instância de TranscriptionQueryParam | Task result (TranscriptionResult) | Consulta o resultado da tarefa atual de forma assíncrona. |
Códigos de erro
Se encontrar um erro, consulte Error codes para solução de problemas.
Quando uma tarefa contém várias subtarefas, o status geral da tarefa é marcado como SUCCEEDED desde que pelo menos uma subtarefa tenha sucesso. Verifique o campo subtask_status para determinar o resultado de cada subtarefa.
Exemplo de resposta de erro:
FAQ
Recursos
P: Áudio codificado em Base64 é suportado?
Áudio codificado em Base64 não é suportado. Apenas áudio em uma URL acessível publicamente pode ser reconhecido. Fluxos binários e arquivos locais não podem ser reconhecidos diretamente.
P: Como torno um arquivo de áudio disponível em uma URL acessível publicamente?
As etapas típicas são as seguintes. Esta é uma abordagem; o processo exato varia conforme o product de armazenamento. Recomendamos que você upload the audio to Alibaba Cloud OSS:
1. Escolha um método de armazenamento e hospedagem
1. Escolha um método de armazenamento e hospedagem
Por exemplo:
-
Object Storage Service (recomendado):
- Use o Object Storage Service de um provedor cloud (como Alibaba Cloud OSS) para carregar o arquivo de áudio em um bucket e configurá-lo para acesso público.
- Vantagens: alta disponibilidade, suporte a aceleração CDN e gerenciamento fácil.
-
Servidor web:
- Coloque o arquivo de áudio em um servidor web que suporte acesso HTTP/HTTPS (como Nginx ou Apache).
- Vantagens: adequado para pequenos projetos ou testes locais.
-
Rede de distribuição de conteúdo (CDN):
- Hospede o arquivo de áudio em uma CDN e acesse-o através da URL fornecida pela CDN.
- Vantagens: acelera a entrega de arquivos e é adequado para cenários de alta concorrência.
2. Carregue o arquivo de áudio
2. Carregue o arquivo de áudio
Carregue o áudio de acordo com o método de armazenamento ou hospedagem escolhido. Por exemplo:
-
Object Storage Service:
- Faça login no console do provedor cloud e crie um bucket.
- Carregue o arquivo de áudio e defina sua permissão como leitura pública ou gere um link de acesso temporário.
-
Servidor web:
- Coloque o arquivo de áudio em um diretório designado no servidor (como
/var/www/html/audio/). - Certifique-se de que o arquivo esteja acessível via HTTP/HTTPS.
- Coloque o arquivo de áudio em um diretório designado no servidor (como
3. Gere uma URL acessível publicamente
3. Gere uma URL acessível publicamente
Por exemplo:
-
Object Storage Service:
- Após o carregamento do arquivo, o sistema gera automaticamente uma URL de acesso público (geralmente no formato
https://<bucket-name>.<region>.aliyuncs.com/<file-name>). - Para um nome de domínio mais amigável, vincule um domínio personalizado e ative HTTPS.
- Após o carregamento do arquivo, o sistema gera automaticamente uma URL de acesso público (geralmente no formato
-
Servidor web:
- A URL de acesso geralmente é o endereço do servidor mais o caminho do arquivo (como
https://your-domain.com/audio/file.mp3).
- A URL de acesso geralmente é o endereço do servidor mais o caminho do arquivo (como
-
CDN:
- Após configurar a aceleração CDN, use a URL fornecida pela CDN (como
https://cdn.your-domain.com/audio/file.mp3).
- Após configurar a aceleração CDN, use a URL fornecida pela CDN (como
4. Verifique se a URL funciona
4. Verifique se a URL funciona
Certifique-se de que a URL gerada seja acessível pela rede pública. Por exemplo:
- Abra a URL em um navegador e verifique se o arquivo de áudio é reproduzido.
- Use uma ferramenta (como
curlou Postman) para verificar se a URL retorna a resposta HTTP correta (código de status 200).
oss:// não são suportadas.
Ao usar a API RESTful, se os arquivos de áudio estiverem armazenados no Alibaba Cloud OSS, URLs temporárias com o prefixo oss:// são suportadas:
- A URL temporária é válida por 48 horas e não pode ser usada após a expiração. Não utilize em ambiente de produção.
- A API para obtenção de credencial de upload tem limite de 100 QPS e não suporta scale out. Não utilize em ambientes de produção, cenários de alta concorrência ou cenários de teste de estresse.
- Para ambientes de produção, use um service de armazenamento estável, como OSS, para garantir a disponibilidade de arquivos a longo prazo e evitar problemas de limitação de taxa.