

Cette rubrique détaille les paramètres et l'API du SDK Java pour la reconnaissance vocale hors temps réel Fun-ASR.
Pour les exigences d'entrée (formats audio pris en charge, limites de taille de fichier et de durée), consultez Spécifications audio.
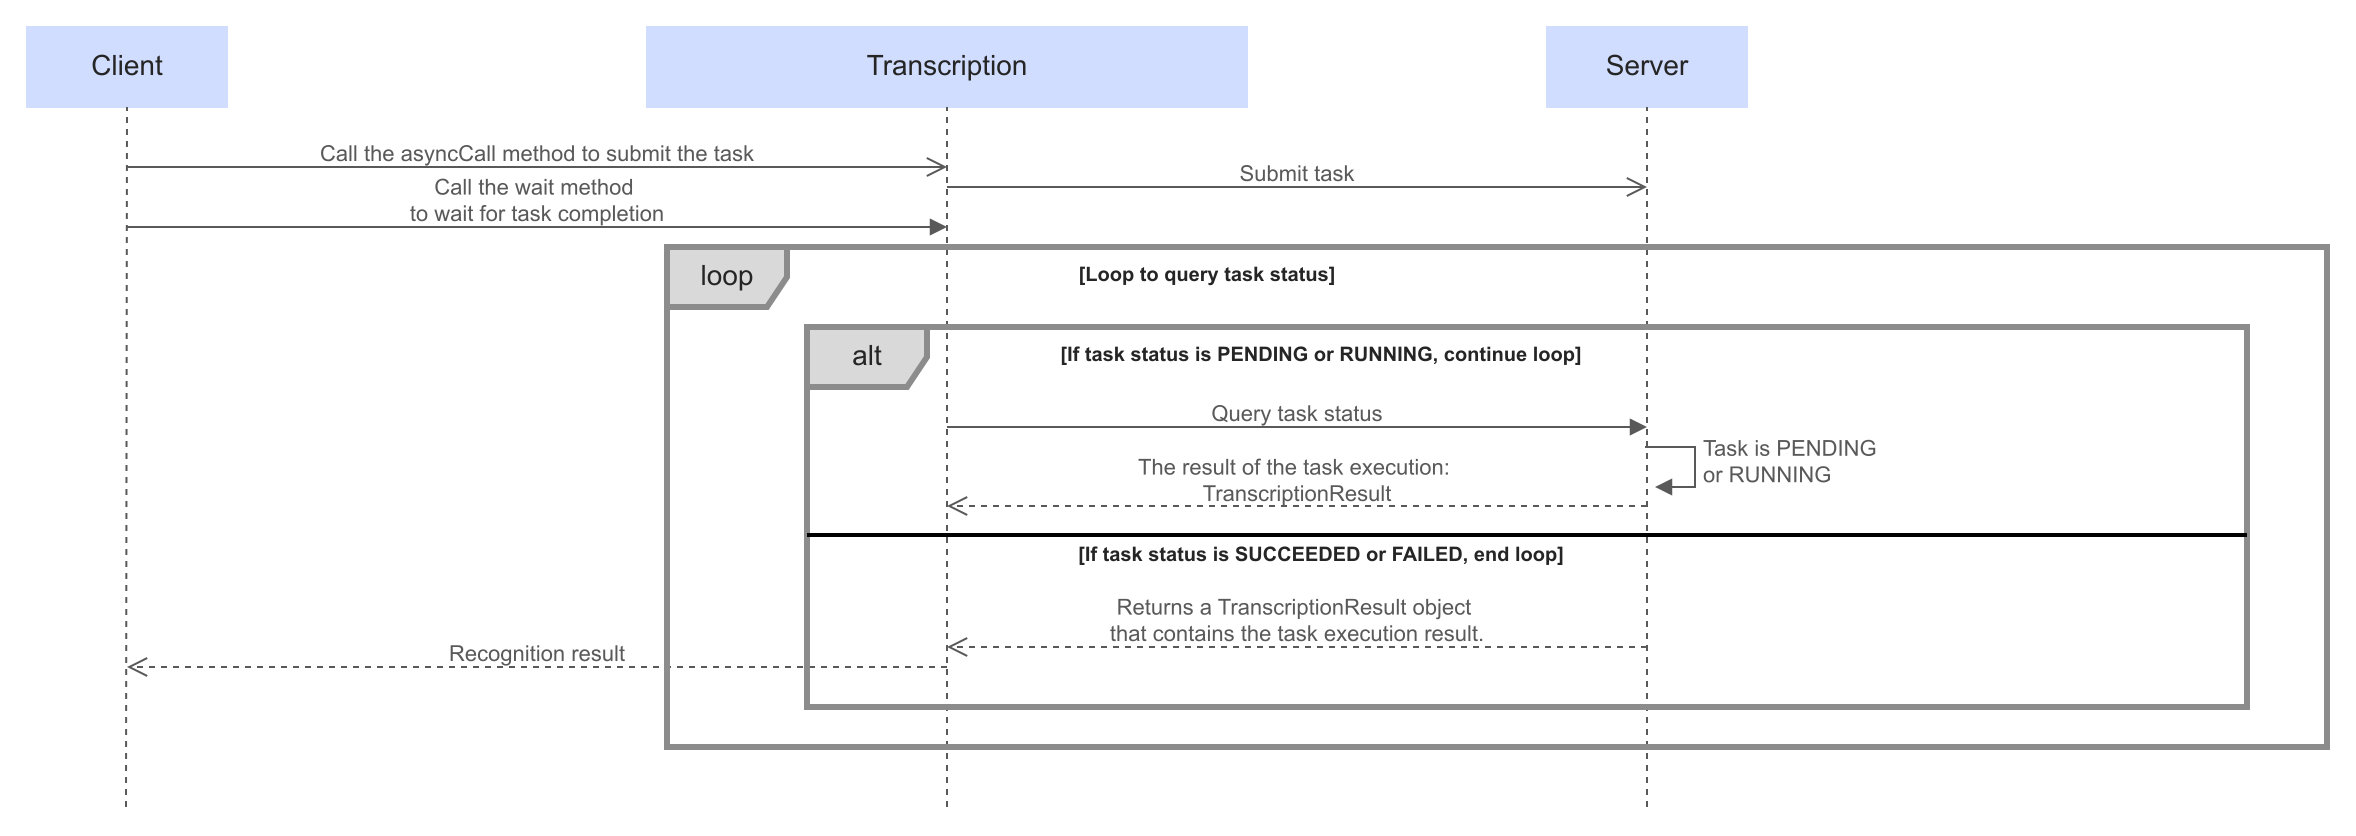
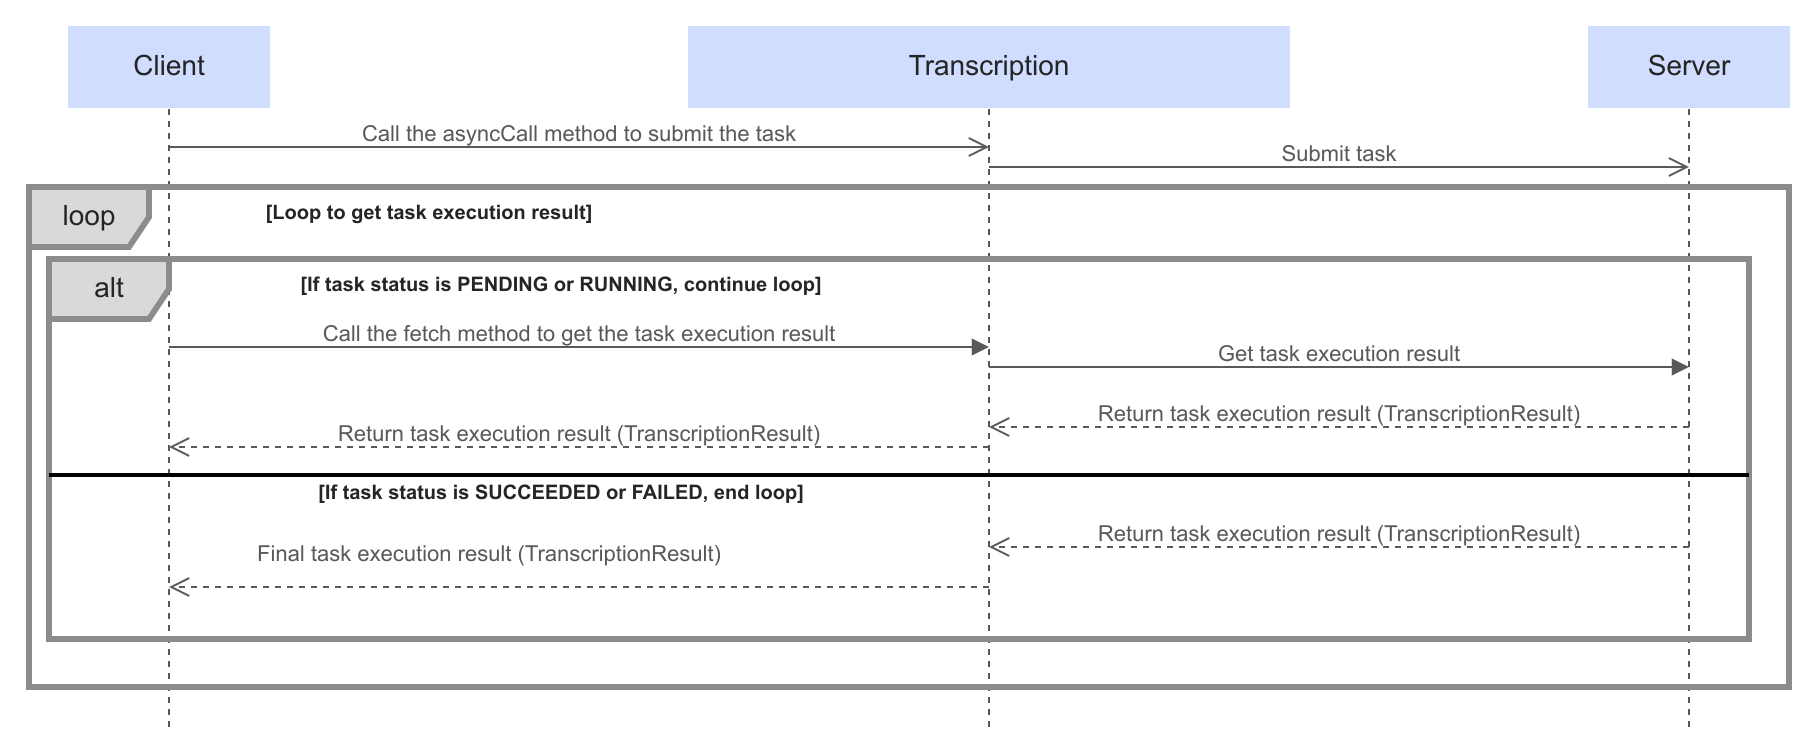
La classe principale (Transcription) fournit des interfaces pour soumettre une tâche de manière asynchrone, attendre sa fin de façon synchrone et interroger son résultat de manière asynchrone. Vous pouvez exécuter la reconnaissance vocale hors temps réel selon l'une des deux méthodes suivantes :
Par défaut, le SDK utilise l'endpoint de la région Chine (Pékin). Pour basculer vers une autre région, modifiez
Remarque :
Configurez les paramètres de requête à l'aide des méthodes chaînées de
Le résultat de reconnaissance est enregistré sous forme de fichier JSON.
Les paramètres suivants méritent une attention particulière :
Importez
Si vous rencontrez une erreur, consultez les codes d'erreur pour résoudre le problème.
Lorsqu'une tâche contient plusieurs sous-tâches, l'état global de la tâche est marqué comme
L'audio encodé en Base64 n'est pas pris en charge. Seul l'audio accessible via une URL publique peut être reconnu. Les flux binaires et les fichiers locaux ne peuvent pas être reconnus directement.
Les étapes typiques sont les suivantes. Il s'agit d'une approche parmi d'autres ; le processus exact varie selon le produit de stockage. Nous vous recommandons de télécharger l'audio vers Alibaba Cloud OSS :
Lors de l'utilisation du SDK, si les fichiers audio sont stockés dans Alibaba Cloud OSS, les URL temporaires avec le préfixe
Une fois une tâche soumise, elle passe à l'état mis en file d'attente (PENDING). Le temps d'attente dépend de la longueur de la file et de la durée de l'audio ; il ne peut donc pas être déterminé exactement, mais reste généralement inférieur à quelques minutes. En règle générale, plus l'audio est long, plus le traitement prend du temps.
Si votre code retourne une erreur, résolvez le problème en vous basant sur les informations contenues dans les codes d'erreur.
Cela peut être dû à une limitation de débit. Patientez un instant et réessayez.
Vérifiez que le format audio et le taux d'échantillonnage sont corrects et respectent les contraintes des paramètres.
Utilisez l'outil ffprobe pour obtenir le conteneur audio, le codec, le taux d'échantillonnage, les canaux et d'autres détails :
Prérequis
- Vous avez activé le service et obtenu une clé API. Veuillez configurer la clé API comme variable d'environnement plutôt que de la coder en dur, afin d'éviter les risques de sécurité liés à une fuite de code.
- Installez la dernière version du SDK DashScope.
Démarrage rapide
La classe principale (Transcription) fournit des interfaces pour soumettre une tâche de manière asynchrone, attendre sa fin de façon synchrone et interroger son résultat de manière asynchrone. Vous pouvez exécuter la reconnaissance vocale hors temps réel selon l'une des deux méthodes suivantes :
- Soumission asynchrone avec attente synchrone : après la soumission d'une tâche, le thread actuel se bloque jusqu'à ce que la tâche soit terminée et que le résultat de reconnaissance soit retourné.
- Soumission asynchrone avec interrogation asynchrone : après la soumission d'une tâche, appelez l'interface d'interrogation pour obtenir le résultat quand vous le souhaitez.
- Soumettre une tâche de manière asynchrone et attendre sa fin de façon synchrone
- Soumettre une tâche de manière asynchrone et interroger le résultat de manière asynchrone
- Configurez les paramètres de requête.
- Instanciez la classe principale (Transcription).
-
Appelez la méthode
asyncCallde la classe principale (Transcription) pour soumettre la tâche de manière asynchrone.- Le service de transcription de fichiers traite les tâches soumises via l'API au mieux de ses capacités. Une fois soumise, une tâche passe à l'état mis en file d'attente (
PENDING). Le temps d'attente dépend de la longueur de la file et de la durée du fichier ; il ne peut donc pas être déterminé avec précision, mais reste généralement inférieur à quelques minutes. Dès que le traitement commence, la reconnaissance vocale s'effectue à une vitesse des centaines de fois supérieure au temps réel. - Une fois chaque tâche terminée, le résultat de reconnaissance et l'URL de téléchargement restent valides pendant 24 heures. Passé ce délai, vous ne pouvez plus interroger la tâche ni télécharger le résultat via l'URL retournée lors d'une requête précédente.
- Le service de transcription de fichiers traite les tâches soumises via l'API au mieux de ses capacités. Une fois soumise, une tâche passe à l'état mis en file d'attente (
-
Appelez la méthode
waitde la classe principale (Transcription) pour attendre la fin de la tâche de manière synchrone. Une tâche peut se trouver dans l'étatPENDING,RUNNING,SUCCEEDEDouFAILED. Tant que la tâche est dans l'étatPENDINGouRUNNING, l'interfacewaitreste bloquante. Lorsque la tâche atteint l'étatSUCCEEDEDouFAILED, l'interfacewaitcesse de bloquer et retourne le résultat de la tâche.waitretourne un résultat de tâche (TranscriptionResult).
Endpoints
Par défaut, le SDK utilise l'endpoint de la région Chine (Pékin). Pour basculer vers une autre région, modifiez Constants.baseHttpApiUrl avant l'initialisation.
- Singapour
- Chine (Pékin)
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1Lors de l'appel, remplacez {WorkspaceId} par votre véritable ID d'espace de travail.- Les clés API diffèrent selon les régions. Assurez-vous d'utiliser la clé API correspondant à la région cible.
- Le paramètre de région est global et affecte les appels API de tous les SDK DashScope.
Paramètres de requête
Configurez les paramètres de requête à l'aide des méthodes chaînées de TranscriptionParam.
| Paramètre | Type | Obligatoire | Description |
|---|---|---|---|
model | String | Oui | Le nom du modèle. |
fileUrls | List<String> | Oui | Liste des URL des fichiers audio ou vidéo à transcrire. HTTP et HTTPS sont pris en charge. Une seule requête ne prend en charge qu'une seule URL. Pour les exigences d'entrée telles que les formats audio pris en charge, les limites de taille de fichier et les limites de durée, consultez Spécifications audio.Si l'enregistrement est stocké dans Alibaba Cloud OSS, l'API RESTful prend en charge les URL temporaires préfixées par oss://, tandis que le SDK ne prend pas en charge les URL temporaires préfixées par oss://. |
vocabularyId | String | Non | ID d'une liste de mots chauds précompilée.Générez cet ID au préalable en appelant l'API de création de liste de mots chauds. Transmettez l'ID lors de la reconnaissance pour utiliser les mots chauds de la liste.Convient aux scénarios où le vocabulaire est connu et relativement stable, et où vous devez réutiliser la même liste de mots entre plusieurs requêtes.Pour plus de détails sur l'utilisation, consultez Mots chauds précompilés. |
vocabulary | Map<String, Integer> | Non | Mots-clés instantanés. Transmettez des paires clé-valeur dont les clés sont les mots-clés (string) et les valeurs sont des poids entiers (integer). Aucune liste précompilée n’est nécessaire.Pour leur utilisation, consultez Mots-clés instantanés.Définissez vocabulary via la méthode parameter ou la méthode parameters de l'instance TranscriptionParam : |
channelId | List<Integer> | Non | Index des pistes audio à reconnaître dans un fichier audio multipiste. L'index commence à 0. Par exemple, [0] reconnaît la première piste, et [0, 1] reconnaît simultanément les première et deuxième pistes. Si vous omettez ce paramètre, seule la première piste est traitée.Valeur par défaut : [0]. |
specialWordFilter | String | Non | Mots sensibles à traiter lors de la reconnaissance vocale. Vous pouvez définir une méthode de gestion différente pour chaque mot sensible. Pour plus de détails, consultez Filtrage des mots sensibles. |
diarizationEnabled | Boolean | Non | Indique s'il faut activer la diarisation des locuteurs. Désactivé par défaut.S'applique uniquement à l'audio mono. L'audio multicanal ne prend pas en charge la diarisation des locuteurs.Lorsque cette option est activée, le résultat de reconnaissance inclut un champ speaker_id qui distingue les différents locuteurs.Lorsque la diarisation des locuteurs est activée, maintenez la durée audio en dessous de 2 heures. Sinon, la reconnaissance peut échouer ou expirer. speaker_id, consultez Description du résultat de reconnaissance. |
speakerCount | Integer | Non | Valeur de référence pour le nombre de locuteurs. La plage valide est un entier de 2 à 100 (inclus).Par défaut, le nombre de locuteurs est détecté automatiquement. Si vous définissez cette valeur, elle guide simplement l'algorithme pour produire le nombre spécifié lorsque cela est possible, sans garantir ce compte exact.Aucune valeur par défaut. |
language_hints | String[] | Non | Codes de langue à reconnaître. Si vous ne pouvez pas déterminer la langue à l'avance, laissez ce champ vide et le modèle détectera la langue automatiquement.Vous pouvez définir jusqu’à 1 valeur. Au-delà, seules les 1 premières sont prises en compte.
Cliquez pour voir les codes de langue pris en charge
language_hints via la méthode parameter ou la méthode parameters de l'instance TranscriptionParam : |
apiKey | String | Non | Votre clé API. Si vous avez configuré la clé API comme variable d'environnement, vous n'avez pas besoin de la définir dans votre code. Dans le cas contraire, vous devez la définir dans votre code. |
Réponse
Résultat de tâche (TranscriptionResult)
TranscriptionResult encapsule le résultat de la tâche actuelle.
| Interface/Méthode | Paramètre | Valeur de retour | Description |
|---|---|---|---|
Aucun | requestId | Obtient le requestId. | |
Aucun | taskId | Obtient le taskId. | |
Aucun | TaskStatus, l'état de la tâche | Obtient l'état de la tâche.TaskStatus est une énumération. Seuls les quatre états suivants sont pertinents : PENDING, RUNNING, SUCCEEDED et FAILED.Lorsqu'une tâche contient plusieurs sous-tâches, l'état global de la tâche est marqué comme SUCCEEDED dès qu'une seule sous-tâche réussit. Utilisez le champ subtask_status pour vérifier le résultat de chaque sous-tâche individuelle. | |
Aucun | Résultat de sous-tâche (TranscriptionTaskResult) | Obtient le résultat de sous-tâche (TranscriptionTaskResult).Chaque tâche reconnaît un ou plusieurs fichiers audio. Les différents fichiers audio sont traités dans des sous-tâches distinctes ; chaque tâche correspond donc à une ou plusieurs sous-tâches. | |
Aucun | Le résultat de la tâche, au format JSON | Obtient le résultat de la tâche.Le résultat est constitué de données au format JSON. Si vous souhaitez obtenir le résultat de la tâche via l'interface getOutput, analysez-le vous-même après l'avoir obtenu.
Cliquez pour voir l'exemple JSON Exemple de succès code » est le code d'erreur et « message » est le message d'erreur. Ces deux champs n'apparaissent qu'en cas d'erreur. Vous pouvez les utiliser, conjointement avec les codes d'erreur, pour résoudre le problème. |
Résultat de sous-tâche (TranscriptionTaskResult)
TranscriptionTaskResult encapsule le résultat d'une sous-tâche. Une sous-tâche reconnaît un seul fichier audio.
| Interface/Méthode | Paramètre | Valeur de retour | Description |
|---|---|---|---|
Aucun | URL du fichier audio reconnu | Obtient l'URL du fichier audio reconnu. | |
Aucun | URL du résultat de reconnaissance | Obtient l'URL du résultat de reconnaissance. Cette URL est valide pendant 24 heures. Une fois expirée, vous ne pouvez plus interroger la tâche ni télécharger le résultat via l'URL retournée lors d'une requête précédente.Le résultat de reconnaissance est enregistré sous forme de fichier JSON. Vous pouvez télécharger le fichier via l'URL ou lire directement son contenu via une requête HTTP.Pour la signification de chaque champ dans les données JSON, consultez Description du résultat de reconnaissance. | |
Aucun | TaskStatus, l'état de la sous-tâche | Obtient l'état de la sous-tâche.TaskStatus est une énumération. Seuls les quatre états suivants sont pertinents : PENDING, RUNNING, SUCCEEDED et FAILED. | |
Aucun | Informations clés générées lors de l'exécution de la tâche, pouvant être vides | Obtient les informations clés générées lors de l'exécution de la tâche.En cas d'échec d'une tâche, vérifiez ce contenu pour en analyser la cause. |
Description du résultat de reconnaissance
Le résultat de reconnaissance est enregistré sous forme de fichier JSON.
| Paramètre | Type | Description |
|---|---|---|
audio_format | string | Format audio du fichier source. |
channels | array[integer] | Index de piste de l'audio dans le fichier source. Pour un audio monopiste, [0] est retourné ; pour un audio bipiste, [0, 1] est retourné, et ainsi de suite. |
original_sampling_rate | integer | Taux d'échantillonnage (Hz) de l'audio dans le fichier source. |
original_duration_in_milliseconds | integer | Durée audio originale (ms) dans le fichier source. |
channel_id | integer | Index de piste du résultat de transcription, commençant à 0. |
content_duration | integer | Durée (ms) du contenu de la piste identifié comme parole.Le service de modèle de reconnaissance vocale transcrit uniquement le contenu d'une piste identifié comme parole, et facture en fonction de cette durée. Le contenu non vocal n'est ni mesuré ni facturé. En règle générale, la durée du contenu vocal est inférieure à la durée audio originale. Étant donné que la présence de contenu vocal est déterminée par un modèle d'IA, le résultat peut différer légèrement de la situation réelle. |
transcript | string | Résultat de transcription au niveau du paragraphe. |
sentences | array | Résultat de transcription au niveau de la phrase. |
words | array | Résultat de transcription au niveau du mot. |
begin_time | integer | Horodatage de début (ms). |
end_time | integer | Horodatage de fin (ms). |
text | string | Résultat de transcription. |
speaker_id | integer | Index du locuteur actuel, commençant à 0, utilisé pour distinguer les différents locuteurs.Ce champ n'apparaît dans le résultat de reconnaissance que si la diarisation des locuteurs est activée. |
punctuation | string | Ponctuation prédite après le mot, le cas échéant. |
Interfaces clés
Classe de paramètres d'interrogation de tâche (TranscriptionQueryParam)
TranscriptionQueryParam est utilisé lors de l'attente de la fin d'une tâche (appel de la méthode wait de Transcription) ou de l'interrogation du résultat de la tâche (appel de la méthode fetch de Transcription).
Créez une instance TranscriptionQueryParam via la méthode statique FromTranscriptionParam.
| Interface/méthode | Paramètres | Valeur de retour | Description |
|---|---|---|---|
| une instance TranscriptionQueryParam | Crée une instance TranscriptionQueryParam. |
Classe principale (Transcription)
Importez Transcription avec « import com.alibaba.dashscope.audio.asr.transcription.*; ». Ses interfaces clés sont les suivantes :
| Interface/méthode | Paramètres | Valeur de retour | Description |
|---|---|---|---|
param : les paramètres de reconnaissance vocale, une instance TranscriptionParam | Résultat de tâche (TranscriptionResult) | Soumet une tâche de reconnaissance vocale de manière asynchrone. | |
queryParam : une instance TranscriptionQueryParam | Résultat de tâche (TranscriptionResult) | Bloque le thread actuel jusqu'à la fin de la tâche asynchrone (l'état de la tâche est SUCCEEDED ou FAILED). | |
queryParam : une instance TranscriptionQueryParam | Résultat de tâche (TranscriptionResult) | Interroge le résultat de la tâche actuelle de manière asynchrone. |
Codes d'erreur
Si vous rencontrez une erreur, consultez les codes d'erreur pour résoudre le problème.
Lorsqu'une tâche contient plusieurs sous-tâches, l'état global de la tâche est marqué comme SUCCEEDED dès qu'au moins une sous-tâche réussit. Vérifiez le champ subtask_status pour déterminer le résultat de chaque sous-tâche.
Exemple de réponse d'erreur :
FAQ
Fonctionnalités
Q : L'audio encodé en Base64 est-il pris en charge ?
L'audio encodé en Base64 n'est pas pris en charge. Seul l'audio accessible via une URL publique peut être reconnu. Les flux binaires et les fichiers locaux ne peuvent pas être reconnus directement.
Q : Comment rendre un fichier audio disponible via une URL accessible publiquement ?
Les étapes typiques sont les suivantes. Il s'agit d'une approche parmi d'autres ; le processus exact varie selon le produit de stockage. Nous vous recommandons de télécharger l'audio vers Alibaba Cloud OSS :
1. Choisir une méthode de stockage et d'hébergement
1. Choisir une méthode de stockage et d'hébergement
Par exemple :
-
Service de stockage objet (recommandé) :
- Utilisez le service de stockage objet d'un fournisseur cloud (tel qu'Alibaba Cloud OSS) pour télécharger le fichier audio dans un bucket et le configurer en accès public.
- Avantages : haute disponibilité, prise en charge de l'accélération CDN et gestion simplifiée.
-
Serveur web :
- Placez le fichier audio sur un serveur web prenant en charge l'accès HTTP/HTTPS (tel que Nginx ou Apache).
- Avantages : convient aux petits projets ou aux tests locaux.
-
Réseau de diffusion de contenu (CDN) :
- Hébergez le fichier audio sur un CDN et accédez-y via l'URL fournie par le CDN.
- Avantages : accélère la distribution des fichiers et convient aux scénarios à forte concurrence.
2. Télécharger le fichier audio
2. Télécharger le fichier audio
Téléchargez l'audio selon la méthode de stockage ou d'hébergement choisie. Par exemple :
-
Service de stockage objet :
- Connectez-vous à la console du fournisseur cloud et créez un bucket.
- Téléchargez le fichier audio et définissez son autorisation sur lecture publique ou générez un lien d'accès temporaire.
-
Serveur web :
- Placez le fichier audio dans un répertoire dédié sur le serveur (tel que
/var/www/html/audio/). - Assurez-vous que le fichier est accessible via HTTP/HTTPS.
- Placez le fichier audio dans un répertoire dédié sur le serveur (tel que
3. Générer une URL accessible publiquement
3. Générer une URL accessible publiquement
Par exemple :
-
Service de stockage objet :
- Après le téléchargement du fichier, le système génère automatiquement une URL d'accès public (généralement au format
https://<bucket-name>.<region>.aliyuncs.com/<file-name>). - Pour un nom de domaine plus convivial, liez un domaine personnalisé et activez HTTPS.
- Après le téléchargement du fichier, le système génère automatiquement une URL d'accès public (généralement au format
-
Serveur web :
- L'URL d'accès correspond généralement à l'adresse du serveur suivie du chemin du fichier (comme
https://your-domain.com/audio/file.mp3).
- L'URL d'accès correspond généralement à l'adresse du serveur suivie du chemin du fichier (comme
-
CDN :
- Après avoir configuré l'accélération CDN, utilisez l'URL fournie par le CDN (telle que
https://cdn.your-domain.com/audio/file.mp3).
- Après avoir configuré l'accélération CDN, utilisez l'URL fournie par le CDN (telle que
4. Vérifier que l'URL fonctionne
4. Vérifier que l'URL fonctionne
Assurez-vous que l'URL générée est accessible sur le réseau public. Par exemple :
- Ouvrez l'URL dans un navigateur et vérifiez si le fichier audio se lit.
- Utilisez un outil (tel que
curlou Postman) pour vérifier que l'URL retourne la réponse HTTP correcte (code d'état 200).
oss:// ne sont pas prises en charge.
Lors de l'utilisation de l'API RESTful, si les fichiers audio sont stockés dans Alibaba Cloud OSS, les URL temporaires avec le préfixe oss:// sont prises en charge :
- L'URL temporaire est valide pendant 48 heures et ne peut plus être utilisée après expiration. Ne l'utilisez pas dans un environnement de production.
- L'API pour obtenir un identifiant de téléchargement est limitée à 100 QPS et ne prend pas en charge la mise à l'échelle. Ne l'utilisez pas dans des environnements de production, des scénarios à haute concurrence ou des scénarios de test de charge.
- Pour les environnements de production, utilisez un service de stockage stable tel qu'OSS pour garantir la disponibilité à long terme des fichiers et éviter les problèmes de limitation de débit.