

Este tema describe los parámetros e interfaces del SDK de Python para reconocimiento de voz no en tiempo real de Qwen-Audio-ASR-Filetrans.
Para los requisitos de entrada, como formatos de audio compatibles, límites de tamaño de archivo y límites de duración, consulte Especificaciones de audio.
Los siguientes ejemplos usan DashScope Python SDK 2.0. El Recurso principal (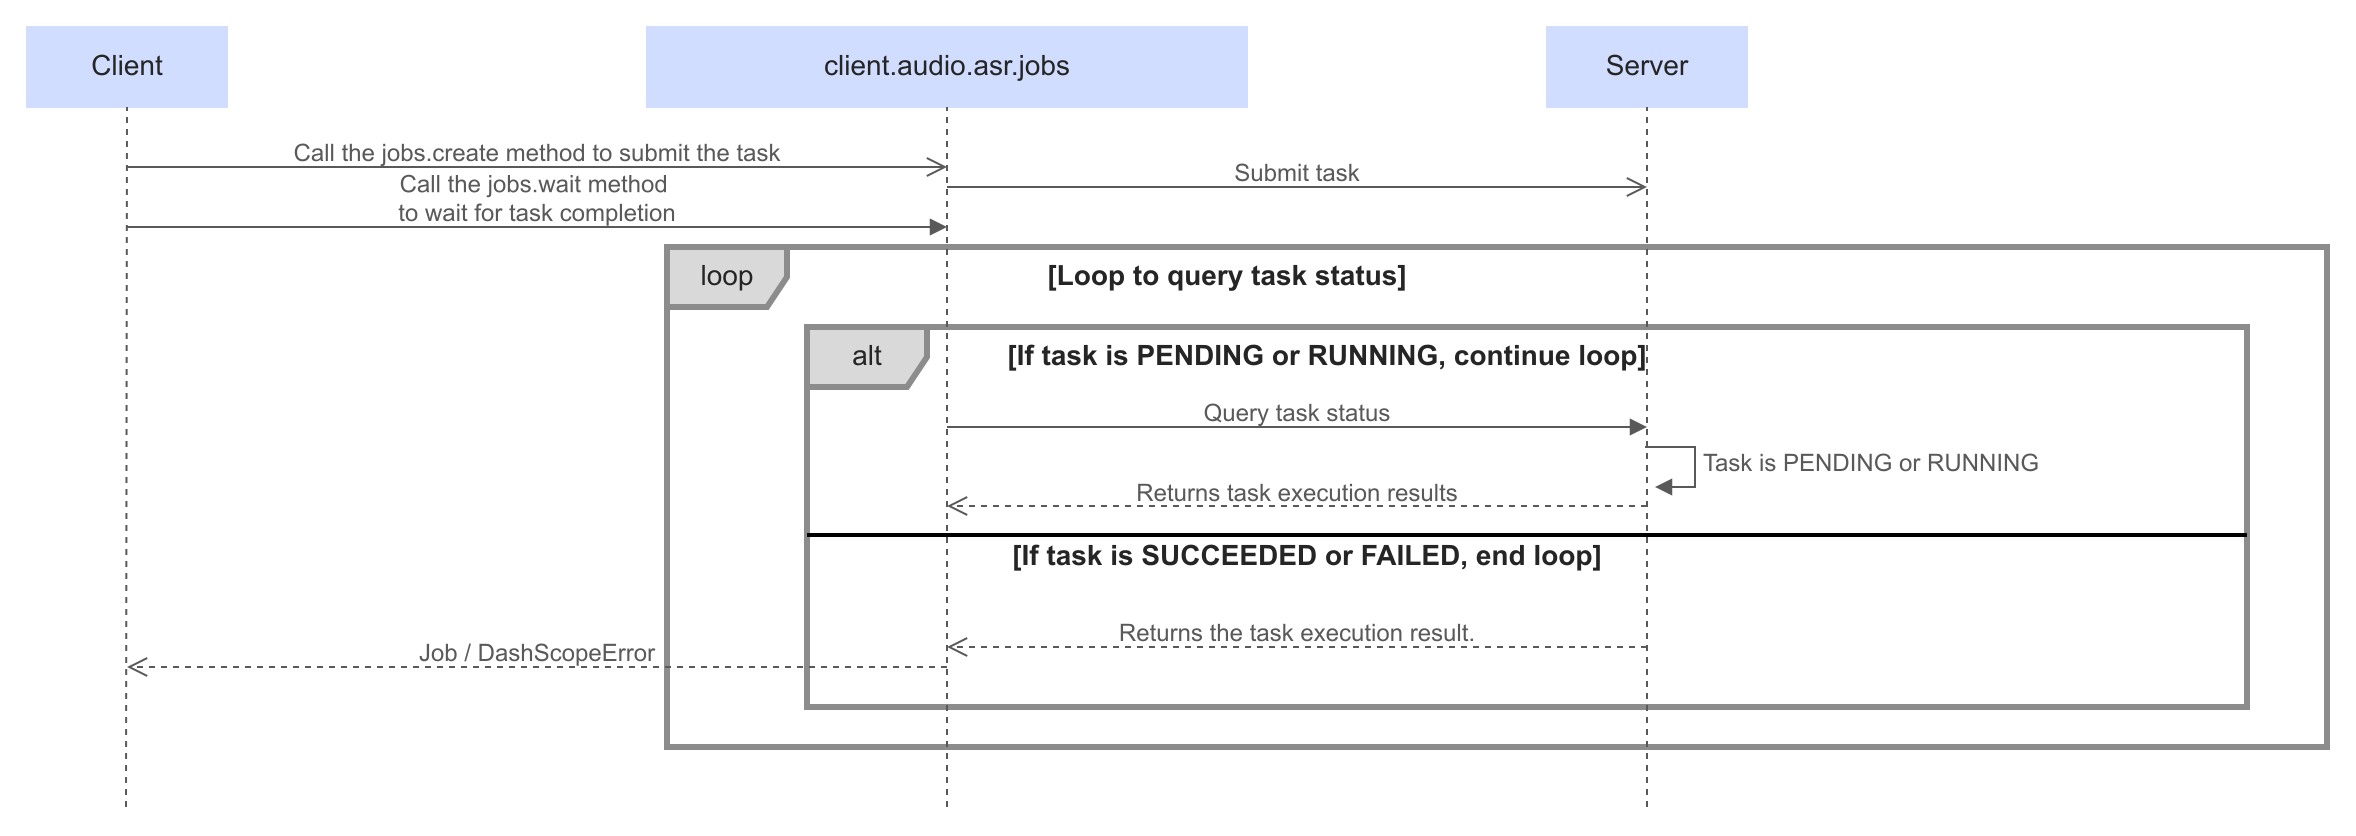
El SDK usa la región de Pekín de forma predeterminada. Al crear
Las claves de API varían entre regiones. Use la clave de la región correspondiente.
Configure los parámetros mediante
El resultado del reconocimiento se guarda como un archivo JSON.
Los siguientes parámetros son dignos de mención:
Cree un cliente con
De forma predeterminada, una tarea fallida genera
No se admite audio codificado en Base64. Solo se puede reconocer audio en una URL de acceso público. Las secuencias binarias y los archivos locales no se pueden reconocer directamente.
Los pasos típicos son los siguientes. Este es un enfoque; el proceso exacto varía según el producto de almacenamiento. Le recomendamos que cargue el audio en Alibaba Cloud OSS:
Al utilizar el SDK, si los archivos de audio están almacenados en Alibaba Cloud OSS, no se admiten URLs temporales con el prefijo
Después de enviar una tarea, esta entra en estado de espera (PENDING). El tiempo de espera depende de la longitud de la cola y la duración del audio, por lo que no se puede indicar con exactitud, pero generalmente es de unos pocos minutos. En general, cuanto más largo sea el audio, más tiempo tardará.
Si encuentra un error de código, resuelva el problema basándose en la información de Códigos de error.
Esto puede deberse a una limitación de tasa. Espere un momento e inténtelo de nuevo.
Verifique que el formato de audio y la frecuencia de muestreo sean correctos y cumplan con las restricciones de los parámetros.
Utilice la herramienta ffprobe para obtener el contenedor de audio, códec, frecuencia de muestreo, canales y otros detalles:
Requisitos previos
- Ha activado el servicio y ha seguido los pasos para Obtener una clave de API. Por favor, Configure la clave de API como una variable de entorno en lugar de codificarla directamente en su código para prevenir riesgos de seguridad causados por fugas de código.
- Instale el SDK de DashScope más reciente.
Inicio rápido
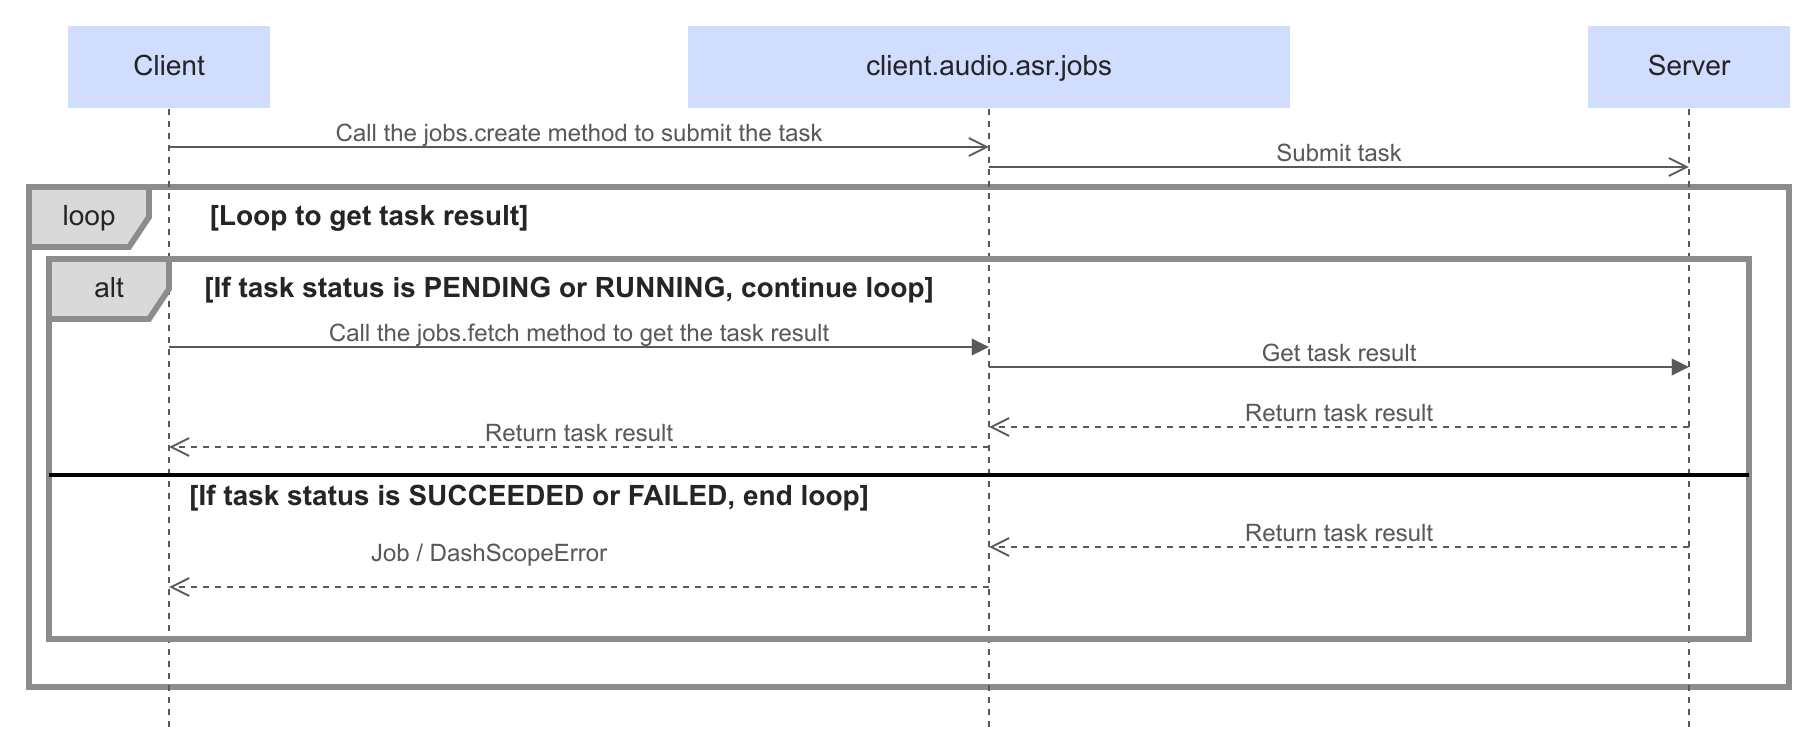
Los siguientes ejemplos usan DashScope Python SDK 2.0. El Recurso principal (client.audio.asr) proporciona métodos para enviar, esperar y consultar tareas de las dos formas siguientes:
- Enviar la tarea de forma asíncrona y esperar de forma síncrona: después de enviar la tarea, bloquee el hilo actual hasta que finalice la tarea y devuelva el resultado de reconocimiento.
- Enviar la tarea de forma asíncrona y consultar el resultado de forma asíncrona: después de enviar la tarea, llame a la interfaz de consulta para recuperar el resultado cuando lo necesite.
- Enviar de forma asíncrona y esperar de forma síncrona
- Enviar de forma asíncrona y consultar el resultado de forma asíncrona
-
Llame a
client.audio.asr.jobs.createpara enviar una tarea con los parámetros de solicitud.- El servicio de transcripción de archivos procesa las tareas enviadas a través de la API con el mejor esfuerzo posible. Después de enviar una tarea, esta entra en el estado de en cola (
PENDING). El tiempo de espera depende de la longitud de la cola y de la duración del archivo, por lo que no se puede determinar con precisión, pero generalmente es de unos pocos minutos. Una vez que comienza el procesamiento, el reconocimiento de voz se completa a una velocidad cientos de veces superior al tiempo real. - Después de que finaliza cada tarea, el resultado de reconocimiento y la URL de descarga son válidos durante 24 horas. Después de su caducidad, ya no podrá consultar la tarea ni descargar el resultado a través de la URL devuelta en una consulta anterior.
- El servicio de transcripción de archivos procesa las tareas enviadas a través de la API con el mejor esfuerzo posible. Después de enviar una tarea, esta entra en el estado de en cola (
-
Llame a
client.audio.asr.jobs.wait(job=job)para esperar a que finalice de forma síncrona. Mientras la tarea esté enPENDINGoRUNNING,jobs.waitsigue esperando. Devuelve unJobcuando la tarea se completa correctamente. Los métodos devuelven unJob. Lea la lista de resultados enjob.results; cadatranscription_urlapunta a un resultado de transcripción descargable.
Endpoints de servicio
El SDK usa la región de Pekín de forma predeterminada. Al crear dashscope.Client, especifique la región en region y el ID del espacio de trabajo en workspace. La configuración de región se aplica solo a este Client.
- Singapore
- China (Beijing)
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1Reemplace {WorkspaceId} con su ID de espacio de trabajo real.Parámetros de solicitud
Configure los parámetros mediante client.audio.asr.transcribe o client.audio.asr.jobs.create.
| Parámetro | Tipo | Obligatorio | Descripción |
|---|---|---|---|
model | str | Sí | El nombre del modelo. |
file_urls | list[str] | Sí | Una lista de URL de los archivos de audio o video a transcribir. Se admiten HTTP y HTTPS. Una sola solicitud admite únicamente una URL. Para los requisitos de entrada, como formatos de audio compatibles, límites de tamaño de archivo y límites de duración, consulte Especificaciones de audio.Si la grabación se almacena en Alibaba Cloud OSS, la API RESTful admite URLs temporales con el prefijo oss://, mientras que el SDK no admite URLs temporales con el prefijo oss://. |
parameters.keep_dialect | bool | No | Compatible solo con qwen-audio-3.1-asr-flash-filetrans. El valor predeterminado es false, que transcribe dialectos al chino estándar. Establézcalo en true para conservar las expresiones dialectales. Consulte la Referencia de API para más detalles. |
parameters.vocabulary_id | str | No | El ID de una lista de palabras clave precompilada.Genere este ID con antelación llamando a la API de creación de lista de palabras clave. Pase el ID durante el reconocimiento para usar las palabras clave de la lista.Adecuado para escenarios donde el vocabulario es conocido y relativamente estable, y donde necesita reutilizar la misma lista de palabras en distintas solicitudes.Para obtener detalles sobre el uso, consulte Palabras clave precompiladas. |
parameters.vocabulary | dict | No | Palabras clave instantáneas.Se pasan como pares clave-valor, donde la clave es el texto de la palabra clave (string) y el valor es el peso de la palabra clave (integer). No es necesario crear una lista de palabras clave con antelación. El peso oscila entre [1, 5] o se establece en 50: un valor en [1, 5] hace que el modelo tenga más probabilidades de generar la palabra a medida que aumenta el valor; un valor de 50 designa una súper palabra clave, lo que mejora enormemente la recuperación, pero el número de súper palabras clave no puede exceder 50.Adecuado para la optimización temporal de palabras clave a nivel de sesión.Cuando las palabras clave instantáneas y precompiladas se configuran juntas, el sistema fusiona ambos conjuntos. Si el conjunto fusionado contiene más de 2000 palabras clave, el sistema selecciona aleatoriamente 2000 para usar. Para detalles de uso, consulte Palabras clave instantáneas.Ejemplo:El siguiente ejemplo reutiliza el client configurado con la región y el espacio de trabajo en Inicio rápido. |
parameters.channel_id | list[int] | No | El índice de las pistas de audio a reconocer en un archivo de audio multipista. El índice comienza en 0. Por ejemplo, [0] reconoce la primera pista, y [0, 1] reconoce la primera y la segunda pista simultáneamente. Si omite este parámetro, solo se procesa la primera pista.Valor predeterminado: [0]. |
parameters.special_word_filter | str | No | Las palabras sensibles a procesar durante el reconocimiento de voz. Puede establecer un método de manejo diferente para cada palabra sensible. Para más detalles, consulte Filtrado de palabras sensibles. |
parameters.diarization_enabled | bool | No | Si se debe habilitar la diarización de hablantes. Deshabilitado de forma predeterminada.Se aplica solo a audio monoaural. El audio multicanal no admite la diarización de hablantes.Cuando está habilitado, el resultado del reconocimiento incluye un campo speaker_id que distingue a los diferentes hablantes.Cuando la diarización de hablantes está habilitada, mantenga la duración del audio dentro de 2 horas. De lo contrario, el reconocimiento puede fallar o agotar el tiempo de espera. speaker_id, consulte Descripción del resultado de reconocimiento. |
parameters.speaker_count | int | No | Un valor de referencia para el número de hablantes. El rango válido es un entero de 2 a 100 (inclusive).De forma predeterminada, el número de hablantes se detecta automáticamente. Si configura este valor, solo guía al algoritmo para generar el recuento especificado cuando sea posible y no garantiza ese recuento exacto.Sin valor predeterminado. |
parameters.language_hints | list[str] | No | Los códigos de idioma a reconocer. Si no puede determinar el idioma con antelación, déjelo sin configurar y el modelo detectará el idioma automáticamente.Puede especificar hasta 4 valores. Si especifica más, solo se aplican los primeros 4.
Haga clic para ver los códigos de idioma admitidos
|
Respuesta
Job
Job contiene información de la tarea, salida sin procesar y uso.
| Campo | Descripción |
|---|---|
task_id | El ID de la tarea. |
status | El estado de la tarea: PENDING, RUNNING, SUCCEEDED o FAILED. |
submitted_at | La hora de envío, correspondiente a job.output["submit_time"]. |
scheduled_at | El inicio del procesamiento, correspondiente a job.output["scheduled_time"]. |
finished_at | La hora de finalización, correspondiente a job.output["end_time"]. |
output | El diccionario de salida sin procesar de la tarea. |
results | La lista de resultados de subtareas, accesible mediante job.results. Descargue el archivo JSON de transcription_url para obtener el texto reconocido. |
usage | Información de uso de la tarea. qwen-audio-3.1-asr-flash-filetrans informa del uso de Tokens en input_tokens, output_tokens y total_tokens. qwen-audio-3.0-asr-flash-filetrans se mide por duration. |
Job.output
job.output es el diccionario de salida sin procesar de la tarea devuelto por el servicio.
- PENDING
- RUNNING
- SUCCEEDED
- FAILED (raise_on_error=False)
| Parámetro | Descripción |
|---|---|
code | El código de error. Combínelo con el campo message y consulte Códigos de error para solucionar el problema. |
message | El mensaje de error. Combínelo con el campo code y consulte Códigos de error para solucionar el problema. |
task_id | ID de tarea. |
task_status | Estado de la tarea.Uno de cuatro estados: PENDING, RUNNING, SUCCEEDED y FAILED.Cuando una tarea contiene múltiples subtareas, el estado general de la tarea se marca como SUCCEEDED siempre que cualquier subtarea tenga éxito. Compruebe el campo subtask_status para determinar el resultado de cada subtarea. |
results | Resultados de reconocimiento de la subtarea. |
subtask_status | Estado de la subtarea.Uno de cuatro estados: PENDING, RUNNING, SUCCEEDED y FAILED. |
file_url | URL del audio reconocido. |
transcription_url | URL del resultado de reconocimiento de audio.El resultado de reconocimiento se guarda como un archivo JSON. Puede descargar el archivo desde el enlace asociado con transcription_url o leer su contenido directamente mediante una solicitud HTTP. Para ver el contenido del archivo JSON, consulte Descripción del resultado de reconocimiento. |
Descripción del resultado de reconocimiento
El resultado del reconocimiento se guarda como un archivo JSON.
| Parámetro | Tipo | Descripción |
|---|---|---|
audio_format | string | El formato de audio del archivo fuente. |
channels | array[integer] | El índice de pista del audio en el archivo fuente. Para audio de una sola pista, se devuelve [0]; para audio de doble pista, se devuelve [0, 1]; y así sucesivamente. |
original_sampling_rate | integer | La frecuencia de muestreo (Hz) del audio en el archivo fuente. |
original_duration_in_milliseconds | integer | La duración original del audio (ms) en el archivo fuente. |
channel_id | integer | El índice de pista del resultado de la transcripción, comenzando desde 0. |
content_duration | integer | La duración (ms) del contenido en la pista que se identifica como voz. La descripción de facturación siguiente se aplica a qwen-audio-3.0-asr-flash-filetrans. qwen-audio-3.1-asr-flash-filetrans se factura según el uso de tokens. |
transcript | string | El resultado de la transcripción a nivel de párrafo. |
sentences | array | El resultado de la transcripción a nivel de oración. |
words | array | El resultado de la transcripción a nivel de palabra. |
begin_time | integer | La marca de tiempo de inicio (ms). |
end_time | integer | La marca de tiempo de finalización (ms). |
text | string | El resultado de la transcripción. |
speaker_id | integer | El índice del hablante actual, comenzando desde 0, utilizado para distinguir entre diferentes hablantes.Este campo aparece en el resultado del reconocimiento solo cuando la diarización de hablantes está habilitada. |
punctuation | string | La puntuación predicha después de la palabra, si la hay. |
Interfaces clave
Recurso principal (client.audio.asr)
Cree un cliente con dashscope.Client y use el recurso client.audio.asr. Todos los métodos siguientes devuelven un Job.
| Método | Firma del método | Descripción |
|---|---|---|
transcribe | Envíe una tarea y espere su finalización de forma síncrona. El modelo predeterminado es qwen-audio-3.1-asr-flash-filetrans. Especifique model explícitamente para llamar a otro modelo. | |
jobs.create | Envíe una tarea y devuelva un Job con task_id y status, sin esperar a que finalice el reconocimiento. | |
jobs.wait | Pase un Job o ID de tarea y espere la finalización de forma síncrona. Configure los intervalos inicial y máximo de consulta con poll_interval y max_interval, y el tiempo total de espera con timeout. Todos los valores están en segundos. | |
jobs.fetch | Consulte el estado y los resultados una vez mediante el ID de tarea, sin esperar su finalización. |
Códigos de error
De forma predeterminada, una tarea fallida genera DashScopeError. Para recibir un Job fallido, configure raise_on_error=False al crear el Client y compruebe job.status.
Si encuentra un error, consulte Códigos de error para solucionar el problema.
Cuando una tarea contiene múltiples subtareas, el estado general de la tarea se marca como SUCCEEDED siempre que al menos una subtarea tenga éxito. Verifique el campo subtask_status para determinar el resultado de cada subtarea.
Ejemplo de respuesta de error:
FAQ
Funcionalidades
P: ¿Se admite audio codificado en Base64?
No se admite audio codificado en Base64. Solo se puede reconocer audio en una URL de acceso público. Las secuencias binarias y los archivos locales no se pueden reconocer directamente.
P: ¿Cómo puedo hacer que un archivo de audio esté disponible en una URL de acceso público?
Los pasos típicos son los siguientes. Este es un enfoque; el proceso exacto varía según el producto de almacenamiento. Le recomendamos que cargue el audio en Alibaba Cloud OSS:
1. Elegir un método de almacenamiento y alojamiento
1. Elegir un método de almacenamiento y alojamiento
Por ejemplo:
-
Servicio de almacenamiento de objetos (recomendado):
- Utilice el servicio de almacenamiento de objetos de un proveedor de servicios en la nube (como Alibaba Cloud OSS) para cargar el archivo de audio en un bucket y configurarlo como acceso público.
- Ventajas: alta disponibilidad, soporte de aceleración CDN y gestión sencilla.
-
Servidor web:
- Coloque el archivo de audio en un servidor web que admita acceso HTTP/HTTPS (como Nginx o Apache).
- Ventajas: adecuado para proyectos pequeños o pruebas locales.
-
Red de entrega de contenido (CDN):
- Aloje el archivo de audio en una CDN y acceda a él a través de la URL proporcionada por la CDN.
- Ventajas: acelera la entrega de archivos y es adecuado para escenarios de alta concurrencia.
2. Cargar el archivo de audio
2. Cargar el archivo de audio
Cargue el audio según el método de almacenamiento o alojamiento que haya elegido. Por ejemplo:
-
Servicio de almacenamiento de objetos:
- Inicie sesión en la consola del proveedor de servicios en la nube y cree un bucket.
- Cargue el archivo de audio y configure su permiso como lectura pública o genere un enlace de acceso temporal.
-
Servidor web:
- Coloque el archivo de audio en un directorio designado del servidor (como
/var/www/html/audio/). - Asegúrese de que el archivo sea accesible mediante HTTP/HTTPS.
- Coloque el archivo de audio en un directorio designado del servidor (como
3. Generar una URL de acceso público
3. Generar una URL de acceso público
Por ejemplo:
-
Servicio de almacenamiento de objetos:
- Después de cargar el archivo, el sistema genera automáticamente una URL de acceso público (generalmente en el formato
https://<bucket-name>.<region>.aliyuncs.com/<file-name>). - Para un nombre de dominio más amigable, vincule un dominio personalizado y habilite HTTPS.
- Después de cargar el archivo, el sistema genera automáticamente una URL de acceso público (generalmente en el formato
-
Servidor web:
- La URL de acceso suele ser la dirección del servidor más la ruta del archivo (como
https://your-domain.com/audio/file.mp3).
- La URL de acceso suele ser la dirección del servidor más la ruta del archivo (como
-
CDN:
- Después de configurar la aceleración CDN, utilice la URL proporcionada por la CDN (como
https://cdn.your-domain.com/audio/file.mp3).
- Después de configurar la aceleración CDN, utilice la URL proporcionada por la CDN (como
4. Verificar que la URL funcione
4. Verificar que la URL funcione
Asegúrese de que la URL generada sea accesible a través de la red pública. Por ejemplo:
- Abra la URL en un navegador y verifique si el archivo de audio se reproduce.
- Utilice una herramienta (como
curlo Postman) para verificar que la URL devuelva la respuesta HTTP correcta (código de estado 200).
oss://.
Al utilizar la API RESTful, si los archivos de audio están almacenados en Alibaba Cloud OSS, se admiten URLs temporales con el prefijo oss://:
- La URL temporal es válida durante 48 horas y no se puede utilizar después de su caducidad. No la utilice en un entorno de producción.
- La API para obtener una credencial de carga está limitada a 100 QPS y no admite escalado horizontal. No la utilice en entornos de producción, escenarios de alta concurrencia o escenarios de pruebas de estrés.
- Para entornos de producción, utilice un servicio de almacenamiento estable como OSS para garantizar la disponibilidad de archivos a largo plazo y evitar problemas de limitación de tasa.