了解 WebSocket 的接入地址、鉴权、Realtime 与 Inference 交互流程及各模型的事件差异。
前提条件
- 已开通目标模型或应用,并确认其支持的地域。
- 已获取与调用地域、业务空间匹配的 API Key,参见Token 鉴权。
- 使用业务空间专属域名时,已获取 Workspace ID。
请求头
在 WebSocket 握手请求中设置 Authorization。其余请求头按对应模型的参数说明使用。
| 请求头 | 是否必需 | 说明 |
|---|---|---|
Authorization | 是 | 使用 Bearer <API_KEY> 格式传递 API Key。 |
user-agent | 否 | 标识调用客户端。 |
X-DashScope-WorkSpace | 按模型要求 | 指定业务空间 ID,具体使用方式见对应模型的请求头说明。 |
X-DashScope-DataInspection | 按模型要求 | 数据合规检查配置,支持范围与取值见对应模型的请求头说明。 |
接入地址
使用 wss:// 协议,根据目标模型选择 API 路径和模型名的传递位置。下表列出各模型的接入方式,支持的模型及地域见对应模型文档。
| 模型系列 | API 路径 | 模型名传递位置 |
|---|---|---|
| Qwen-Omni-Realtime | /api-ws/v1/realtime | URL 查询参数 model |
| Qwen-Audio-TTS/CosyVoice | /api-ws/v1/inference | run-task 的 payload.model |
| Qwen-TTS-Realtime | /api-ws/v1/realtime | URL 查询参数 model |
| Qwen-Audio-ASR/Fun-ASR/Paraformer | /api-ws/v1/inference | run-task 的 payload.model |
| Qwen-ASR-Realtime | /api-ws/v1/realtime | URL 查询参数 model |
| Qwen-Audio-Realtime | /api-ws/v1/realtime | URL 查询参数 model |
| Qwen-LiveTranslate-Realtime | /api-ws/v1/realtime | URL 查询参数 model |
| 地域 | 业务空间专属域名 |
|---|---|
| 华北 2(北京) | {WorkspaceId}.cn-beijing.maas.aliyuncs.com |
| 新加坡 | {WorkspaceId}.ap-southeast-1.maas.aliyuncs.com |
{WorkspaceId} 替换为实际业务空间 ID。例如:
dashscope.aliyuncs.com,新加坡为 dashscope-intl.aliyuncs.com,API 路径仍为 /api-ws/v1/realtime。API Key 必须与调用地域匹配。
公共交互流程
/api-ws/v1/realtime 使用会话制协议,/api-ws/v1/inference 使用任务制协议。
Realtime 协议
客户端建立连接后,通过 session.update 配置会话,收到 session.updated 后发送输入。提交输入、触发响应和结束会话的方式由目标模型决定。
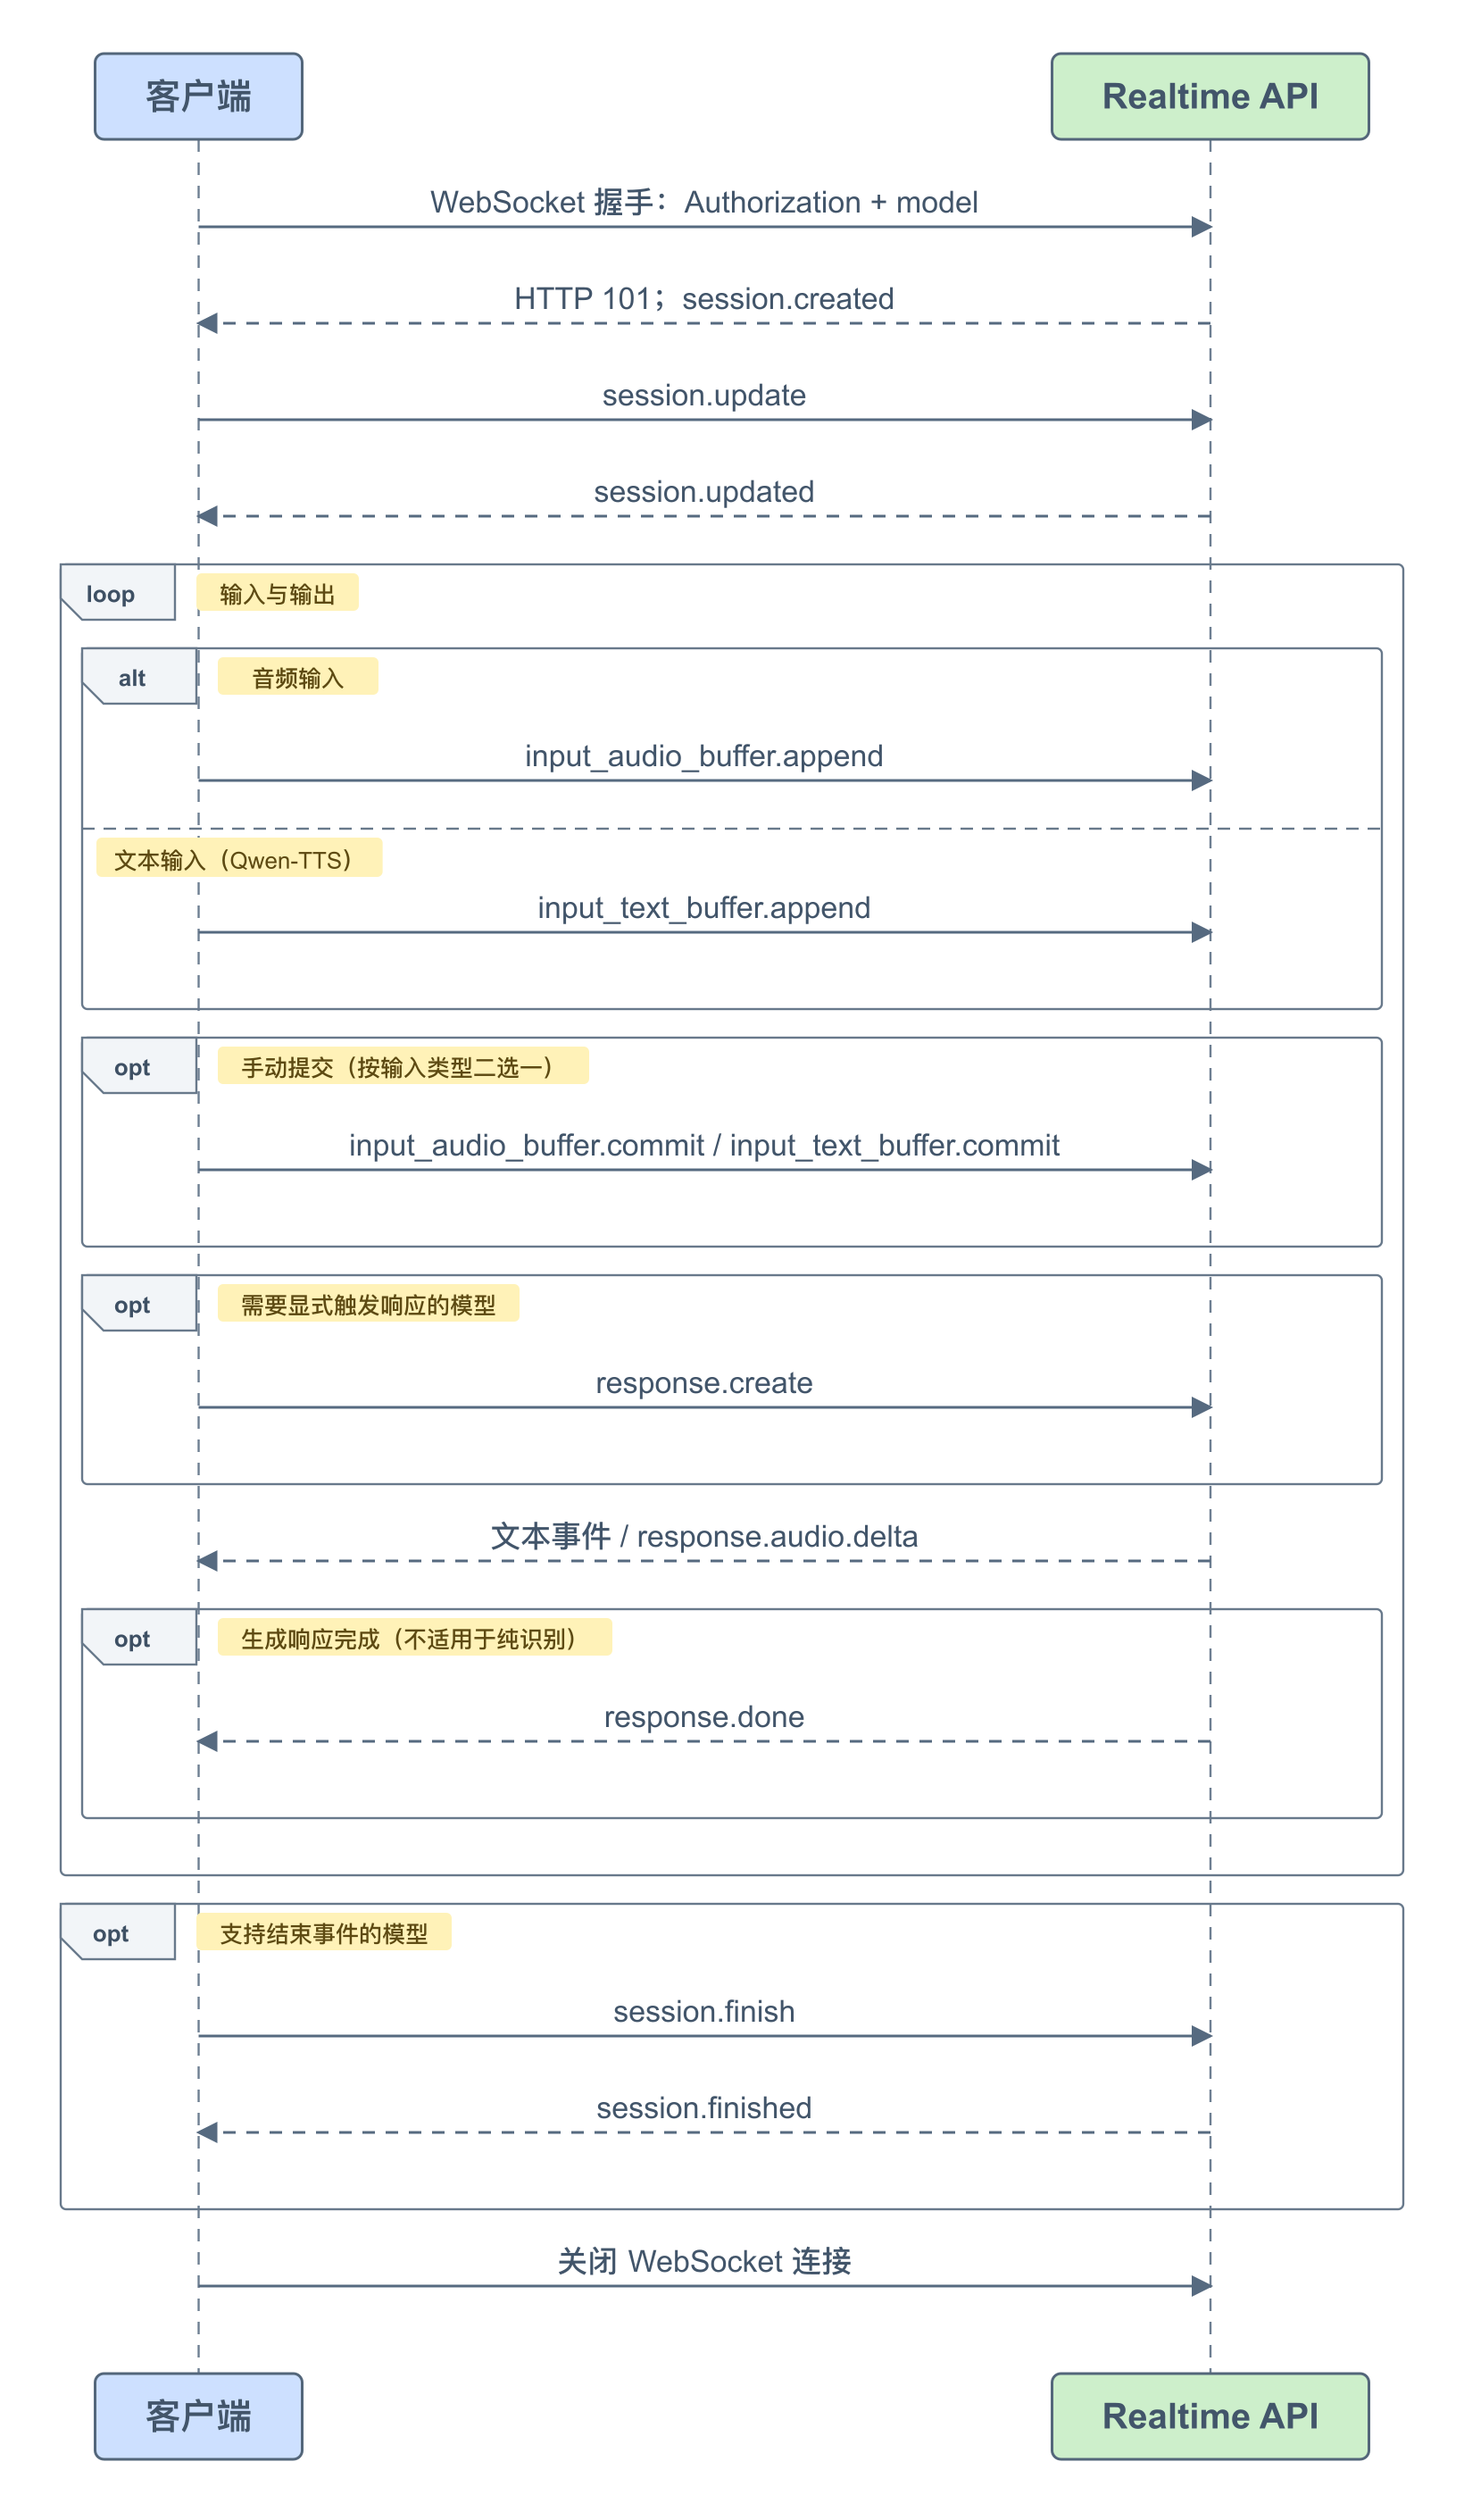
- 建立连接:在 URL 的
model参数中指定模型,在请求头中携带 API Key。握手成功后,服务端发送session.created。 - 配置会话:发送
session.update,设置模型支持的音频格式、输出模态、音色或语音检测参数,等待session.updated。各模型支持的会话参数见对应的客户端事件文档。 - 发送输入:音频通过
input_audio_buffer.append发送 Base64 数据;Qwen-TTS 通过input_text_buffer.append发送文本。支持图像输入的模型使用input_image_buffer.append,并遵循对应模型对图片和音频时序的要求。 - 提交并获取结果:自动模式下由服务端触发处理;手动模式下按输入类型发送
input_audio_buffer.commit或input_text_buffer.commit。是否还需response.create,以及应监听哪些结果事件,参见下方差异对照。 - 结束会话:支持结束事件的模型使用
session.finish,等待session.finished和剩余结果;其他模型在结果接收完成后关闭 WebSocket 连接。response.done表示一次响应结束,不表示整个连接关闭;纯语音识别以转录完成事件标识识别结束。
Inference 协议
客户端发送 run-task 并等待 task-started 后,才开始传输输入。语音识别发送二进制音频帧,语音合成通过 continue-task 发送文本;输入结束后发送 finish-task,等待 task-finished。
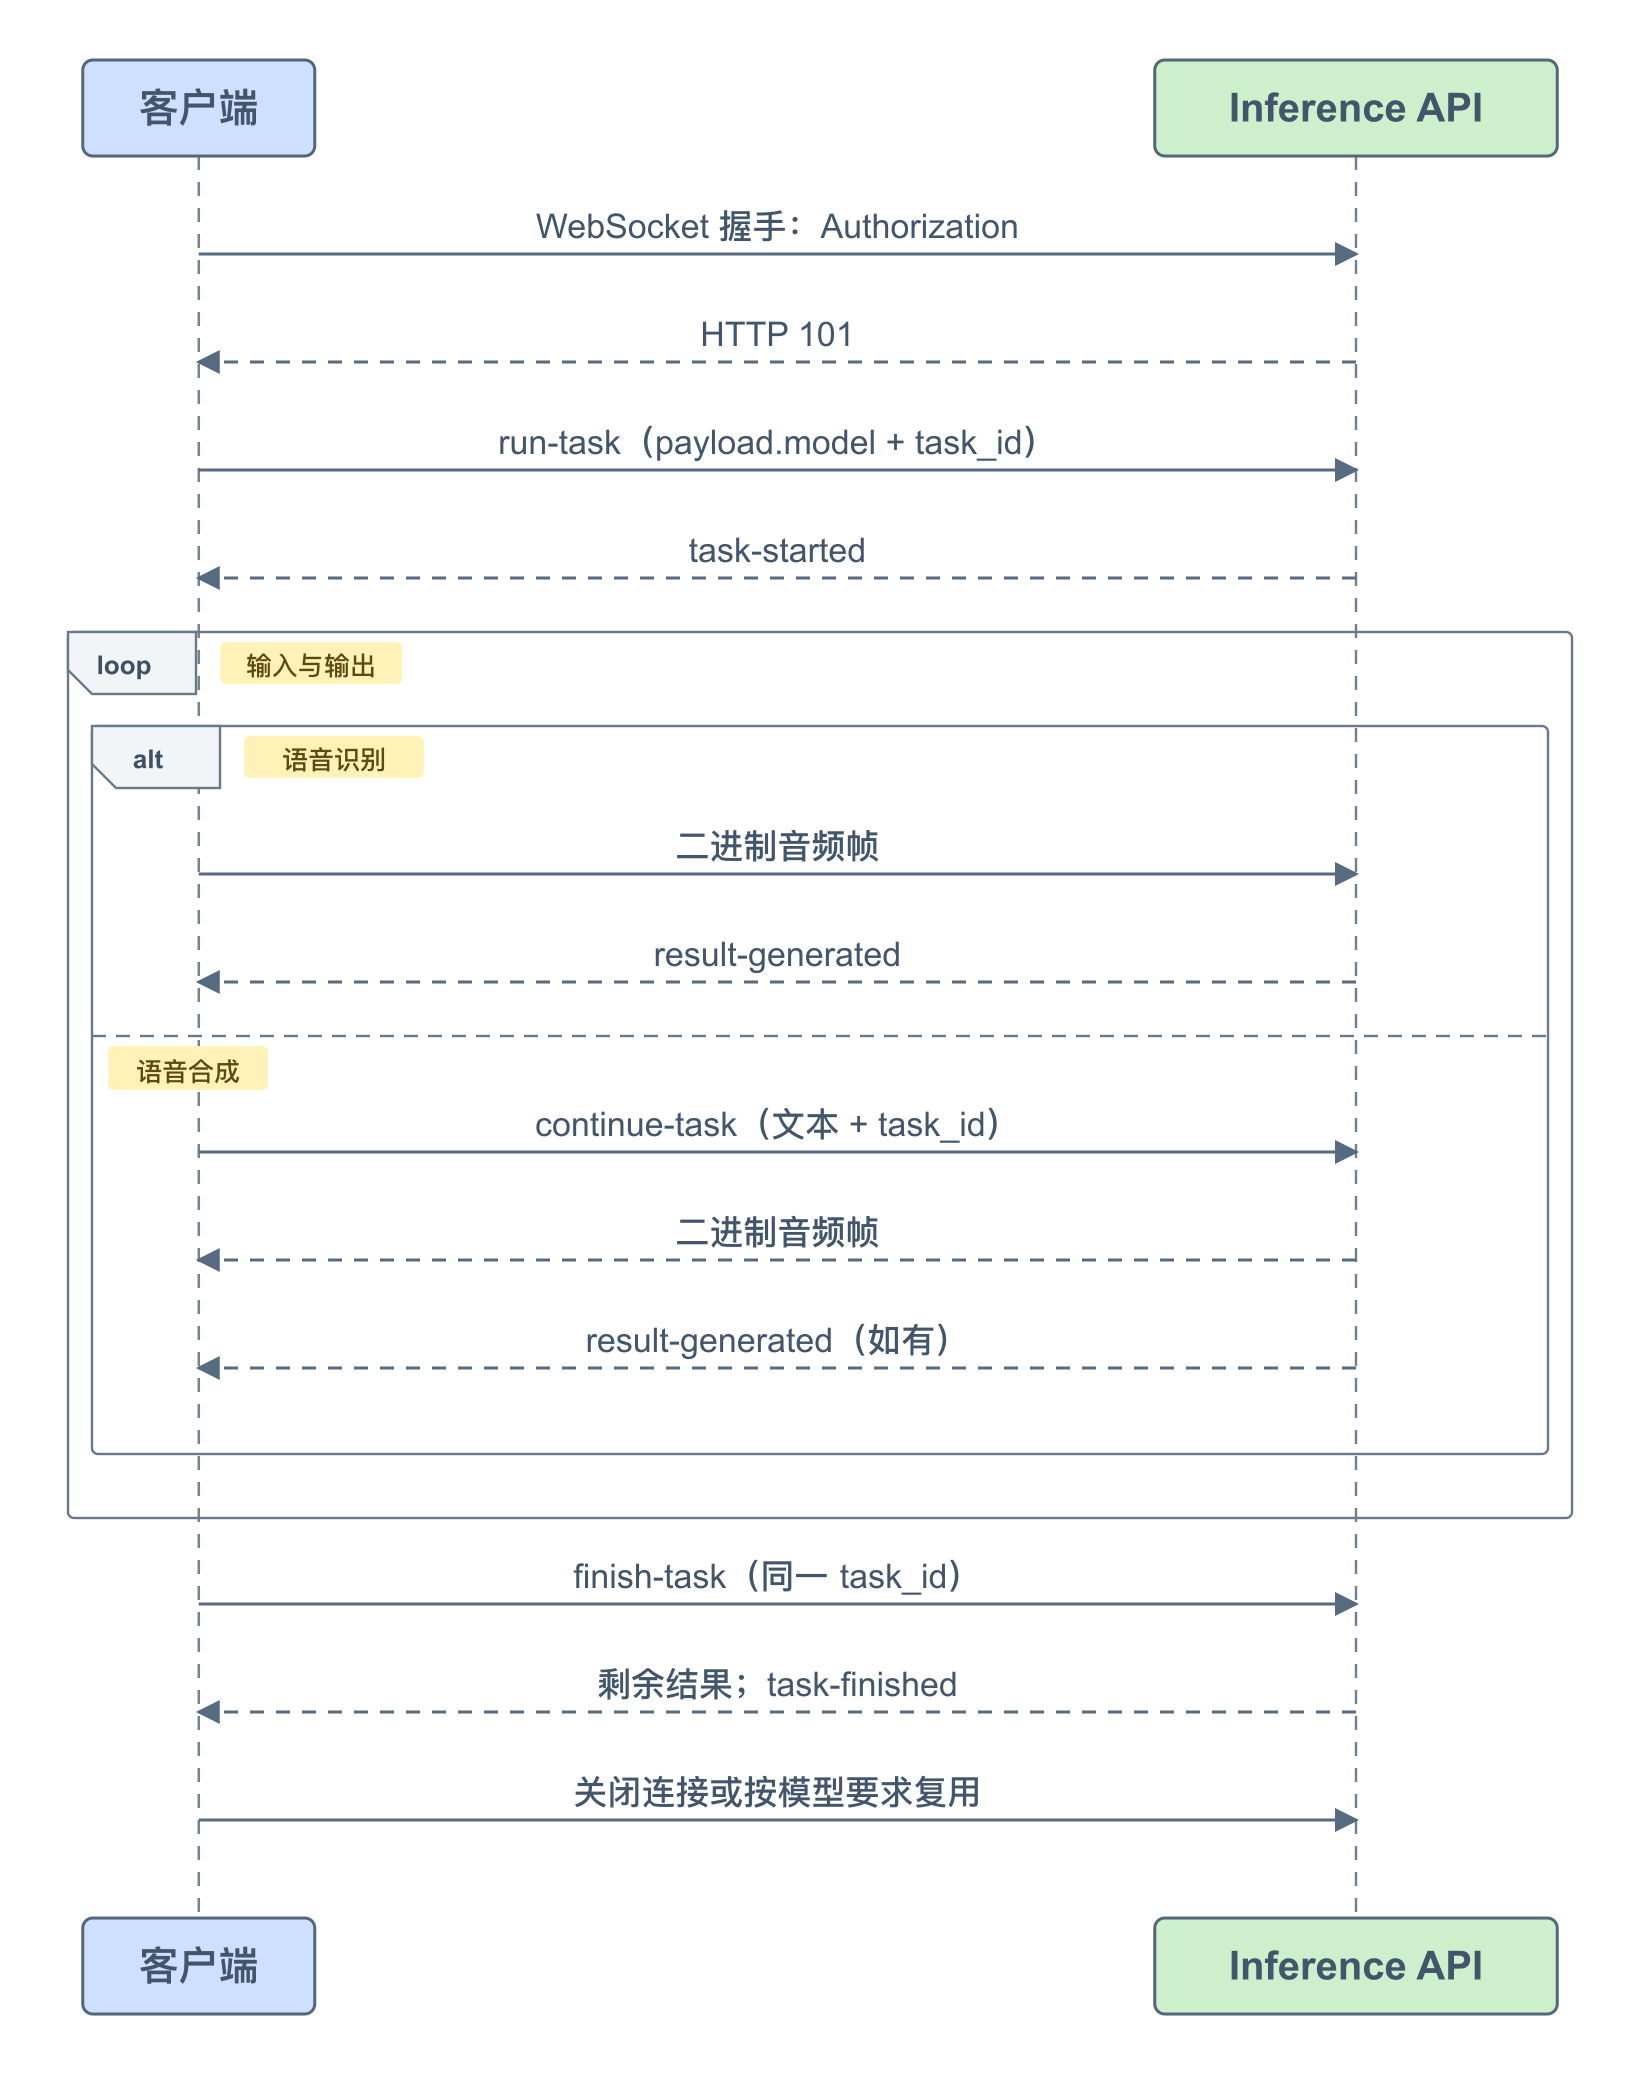
- 建立连接:使用
/api-ws/v1/inference,在请求头中携带 API Key。 - 启动任务:发送
run-task,在payload.model中指定模型,并设置输入格式等参数。为任务生成唯一的header.task_id,等待task-started。 - 传输输入并接收结果:
- 语音识别:发送二进制音频帧,通过
result-generated获取识别结果。 - 语音合成:通过
continue-task的payload.input.text发送待合成文本,接收二进制音频帧;模型还可能通过result-generated返回时间戳等信息。
- 语音识别:发送二进制音频帧,通过
- 结束任务:发送
finish-task后继续接收剩余结果,直到收到task-finished。同一任务的run-task、continue-task和finish-task必须使用相同的header.task_id。之后关闭连接,或按对应模型的要求复用连接。
各模型差异
Realtime 模型
下表列出输入触发和会话结束方式。VAD 类型、音频格式及其他参数的完整取值见对应模型的事件文档。
| 模型 | 输入与触发方式 | 结束方式 |
|---|---|---|
| Qwen3.8-Omni / Qwen3.5-Omni | VAD 模式自动触发响应;Manual 模式先发送 input_audio_buffer.commit,再发送 response.create。 | 接收完结果后关闭连接。 |
| Qwen-TTS-Realtime | server_commit 模式自动提交文本;commit 模式发送 input_text_buffer.commit,无需 response.create。 | session.finish → session.finished |
| Qwen-ASR-Realtime | VAD 模式自动处理;Manual 模式发送 input_audio_buffer.commit,无需 response.create。 | session.finish → session.finished |
| Qwen-Audio-Realtime | 自动模式由服务端判断轮次;Manual 模式先发送 input_audio_buffer.commit,再发送 response.create。 | 接收完结果后关闭连接。 |
| Qwen3.8-LiveTranslate | 使用 output_modalities 配置输出模态,通过 audio.input.turn_detection 配置轮次检测。持续发送音频,输入结束后发送 session.finish。 | session.finish → session.finished |
| Qwen3.5-LiveTranslate | 使用 modalities 和 turn_detection 配置会话。Manual 模式发送 input_audio_buffer.commit 后自动生成响应,无需 response.create。 | session.finish → session.finished |
| 模型 | 主要输出事件 |
|---|---|
| Qwen-Omni-Realtime | response.text.delta / response.audio_transcript.delta / response.audio.delta / response.done |
| Qwen-TTS-Realtime | response.audio.delta / response.done |
| Qwen-ASR-Realtime | conversation.item.input_audio_transcription.text / conversation.item.input_audio_transcription.completed |
| Qwen-Audio-Realtime | response.audio_transcript.delta / response.audio.delta / response.done |
| Qwen3.8-LiveTranslate | response.text.delta / response.audio_transcript.delta / response.audio.delta / response.done |
| Qwen3.5-LiveTranslate | response.text.text / response.audio_transcript.text / response.audio.delta / response.done |
翻译模型的事件名与版本有关:Qwen3.8-LiveTranslate 使用
.delta,Qwen3.5-LiveTranslate 使用 .text。例如,音频对应的译文分别通过 response.audio_transcript.delta 和 response.audio_transcript.text 返回。Inference 模型
Qwen-Audio-TTS/CosyVoice 使用 run-task → task-started → continue-task → finish-task → task-finished 的任务流程;Qwen-Audio-ASR/Fun-ASR/Paraformer 语音识别在 task-started 后发送二进制音频帧。两类模型均通过 task-failed 报告任务错误。
各模型详细接入
实时全模态
实时语音合成
Qwen-Audio-TTS/CosyVoice
Qwen-TTS-Realtime
Sambert
实时语音识别
Qwen-Audio-3.x-ASR-Flash-Streaming/Qwen-Audio-3.1-ASR-Flash-Message/Fun-ASR-Realtime
Qwen-ASR-Realtime
Paraformer
实时语音对话
Qwen-Audio-Realtime
实时音视频翻译
Qwen-Livetranslate-Realtime
错误处理
- 握手失败:根据 HTTP 状态码和错误信息检查连接地址、API Key、业务空间及模型权限。遇到 401/403 时,优先核对鉴权配置。
- 模型不存在或未开通:核对模型名、服务开通状态及调用地域。
- Realtime 错误:处理
error事件,读取错误类型和消息。根据错误信息调整请求中的事件类型或参数。 - Inference 错误:收到
task-failed表示任务失败,可通过header.error_code和header.error_message获取失败原因。