

本文介绍Qwen-Audio-ASR-Filetrans非实时语音识别Python SDK的参数和接口细节。
关于支持的音频格式、文件大小限制、时长限制等输入要求,请参见音频规格。
以下示例使用 DashScope Python SDK 2.0。核心资源(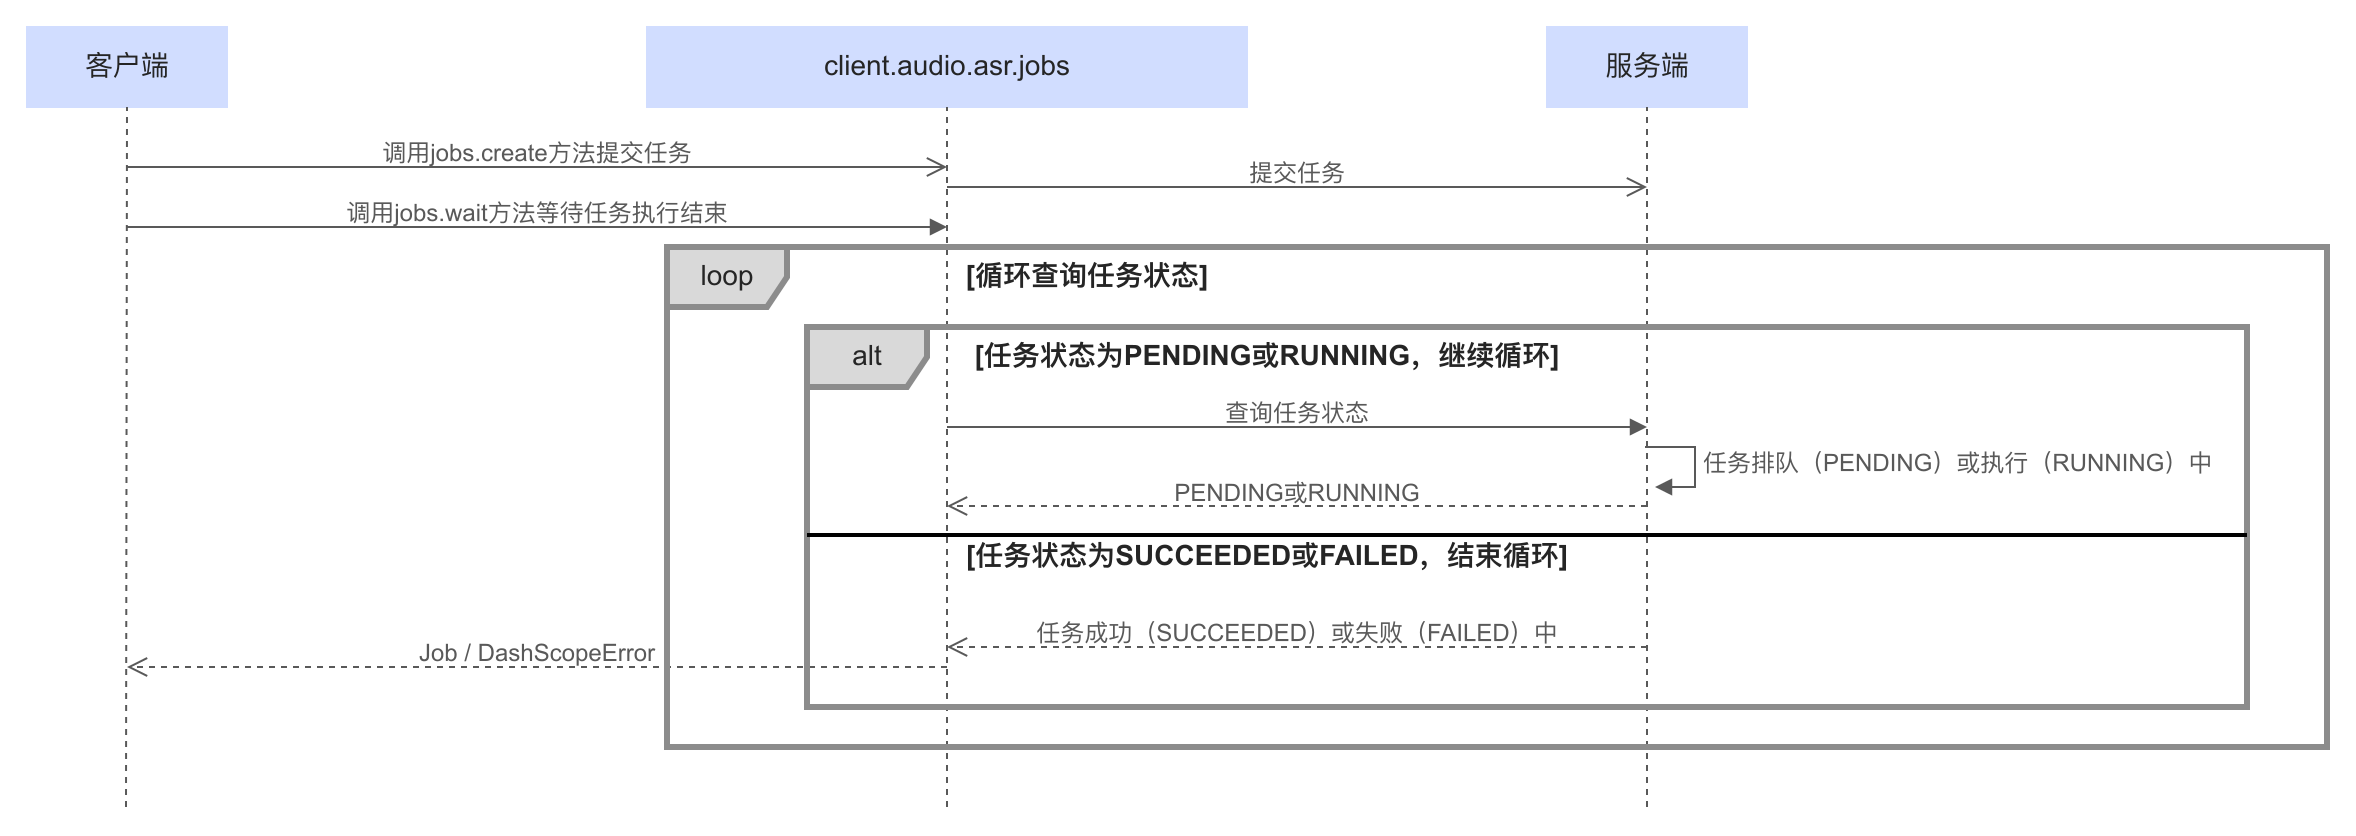
SDK 默认使用北京地域。创建
不同地域的 API Key 不同,请使用对应地域的 API Key。
通过
识别结果保存为JSON文件。
需要关注的参数如下:
通过
任务失败时,默认抛出
不支持Base64编码方式的音频。仅支持可通过公网访问的 URL 所指向的音频的识别,不支持识别二进制流,也不支持直接识别本地文件。
通常遵循以下几个步骤(这里为您提供一种思路,具体情况因不同存储产品而异,推荐将音频上传至阿里云OSS):
使用SDK时,若录音文件存储在阿里云OSS,不支持使用以
任务提交后将进入排队(PENDING)状态,排队时间取决于队列长度和文件时长,无法明确给出,通常在数分钟内,请耐心等待。并且音频时长越长,所需时间越久。
如遇代码报错问题,请根据错误码中的信息进行排查。
可能是限流原因,请耐心等待。
请检查音频格式和采样率是否正确且符合参数约束。
可以使用ffprobe工具获取音频的容器、编码、采样率、声道等信息:
前提条件
- 已开通服务并获取与配置 API Key。请配置API Key到环境变量,而非硬编码在代码中,防范因代码泄露导致的安全风险。
- 安装最新版DashScope SDK。
快速开始
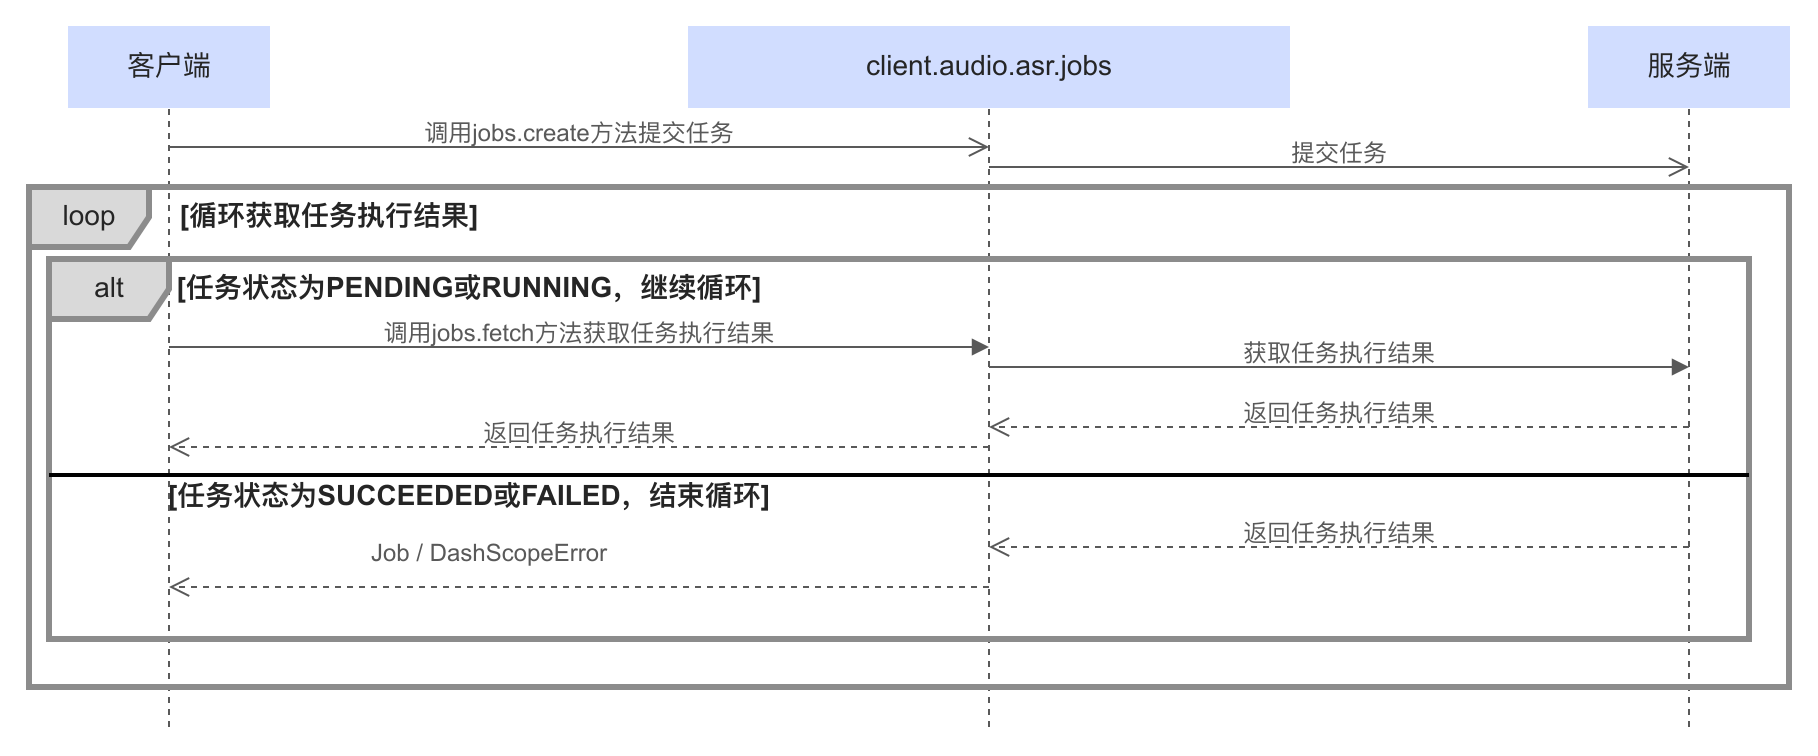
以下示例使用 DashScope Python SDK 2.0。核心资源(client.audio.asr)提供任务提交、等待和查询接口,可通过以下两种方式调用:
- 异步提交任务+同步等待任务结束:提交任务后,阻塞当前线程直到任务结束并获取识别结果。
- 异步提交任务+异步查询任务执行结果:提交任务后,在需要的时候通过调用查询任务接口获取任务的执行结果。
- 异步提交任务+同步等待任务结束
- 异步提交任务+异步查询任务执行结果
-
调用
client.audio.asr.jobs.create提交任务并设置请求参数。- 文件转写服务对通过API提交的任务采取尽力服务原则进行处理。任务提交后将进入排队(
PENDING)状态,排队时间取决于队列长度和文件时长,无法明确给出,通常在数分钟内。任务开始处理后,语音识别将以数百倍加速完成。 - 每一个任务完成后,识别结果和URL下载链接有效期为24小时,超时后无法查询任务或通过先前查询结果中的URL下载结果。
- 文件转写服务对通过API提交的任务采取尽力服务原则进行处理。任务提交后将进入排队(
-
调用
client.audio.asr.jobs.wait(job=job)同步等待任务结束。 任务处于PENDING或RUNNING状态时,jobs.wait持续等待;任务成功后返回Job。 接口返回Job,可通过job.results获取结果列表,其中的transcription_url为转写结果下载地址。
接口地址
SDK 默认使用北京地域。创建 dashscope.Client 时,通过 region 指定地域,通过 workspace 指定业务空间。地域配置仅作用于该 Client。
- 新加坡
- 华北2(北京)
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1调用时请将{WorkspaceId}替换为真实的业务空间ID。请求参数
通过 client.audio.asr.transcribe 或 client.audio.asr.jobs.create 设置请求参数。
| 参数 | 类型 | 是否必须 | 说明 |
|---|---|---|---|
model | str | 是 | 模型名称。 |
file_urls | list[str] | 是 | 音视频文件转写的URL列表,支持HTTP / HTTPS协议,单次请求仅支持1个URL。关于支持的音频格式、文件大小限制、时长限制等输入要求,请参见音频规格。若录音文件存储在阿里云OSS,使用RESTful API方式支持使用以oss://为前缀的临时 URL,使用SDK方式不支持使用以 oss://为前缀的临时 URL。 |
parameters.keep_dialect | bool | 否 | 仅 qwen-audio-3.1-asr-flash-filetrans 支持。默认 false,将方言转写为普通话;设为 true 时保留方言表达。完整参数说明请参见API 参考。 |
parameters.vocabulary_id | str | 否 | 预编译热词列表 ID。需预先调用创建热词列表接口生成,识别时传入该 ID 即可使用列表中的热词。适用于词汇已知且相对稳定、需要跨请求复用同一词表的场景。使用方法请参见预编译热词。 |
parameters.vocabulary | dict | 否 | 即时热词。以键值对形式传入,键为热词文本(string),值为热词权重(integer),无需预先创建热词列表。权重取值范围为 [1, 5] 或 50:取 [1, 5] 时值越大模型越倾向输出该词;取 50 时为超级热词,召回率大幅提升,但超级热词数量最多不超过 50 个。适用于临时性、会话级别的热词优化。与预编译热词同时配置时,系统会合并两类热词;合并后超过 2000 个时,随机选择 2000 个使用。使用方法请参见即时热词。示例:以下示例复用快速开始中已配置地域和业务空间的 client。 |
parameters.channel_id | list[int] | 否 | 指定在多音轨音频文件中需要识别的音轨索引,索引从 0 开始。例如,[0] 表示识别第一个音轨,[0, 1] 表示同时识别第一和第二个音轨。如果省略此参数,则默认处理第一个音轨。默认值:[0]。 |
parameters.special_word_filter | str | 否 | 指定在语音识别过程中需要处理的敏感词,并支持对不同敏感词设置不同的处理方式。详情请参见敏感词过滤。 |
parameters.diarization_enabled | bool | 否 | 是否启用说话人分离,默认关闭。仅适用于单声道音频,多声道音频不支持说话人分离。启用该功能后,识别结果中将显示speaker_id字段,用于区分不同说话人。如果启用说话人分离功能,建议音频时长不超过2小时,否则可能导致识别失败或超时。 speaker_id的示例,请参见识别结果说明。 |
parameters.speaker_count | int | 否 | 说话人数量参考值。取值范围为2至100的整数(包含2和100)。默认自动判断说话人数量,如果配置此项,只能辅助算法尽量输出指定人数,无法保证一定会输出此人数。无默认值。 |
parameters.language_hints | list[str] | 否 | 设置待识别语言代码。如果无法提前确定语种,可不设置,模型会自动识别语种。最多支持设置 4 个值,超出时仅前 4 个生效。
点击查看支持的语言代码
|
响应结果
Job
Job 封装任务信息、原始输出和用量信息。
| 字段 | 说明 |
|---|---|
task_id | 任务 ID。 |
status | 任务状态:PENDING、RUNNING、SUCCEEDED 或 FAILED。 |
submitted_at | 提交时间,对应 job.output["submit_time"]。 |
scheduled_at | 开始处理时间,对应 job.output["scheduled_time"]。 |
finished_at | 结束时间,对应 job.output["end_time"]。 |
output | 原始任务输出字典。 |
results | 子任务结果列表,可通过 job.results 读取;下载 transcription_url 指向的 JSON 文件可获得识别文本。 |
usage | 任务用量信息。 qwen-audio-3.1-asr-flash-filetrans 使用 input_tokens、output_tokens 和 total_tokens 统计 Token 用量;qwen-audio-3.0-asr-flash-filetrans 按 duration 计量。 |
Job.output
job.output 是服务端返回的原始任务输出字典。
- PENDING
- RUNNING
- SUCCEEDED
- FAILED (raise_on_error=False)
| 参数 | 说明 |
|---|---|
code | 代表错误码。可以结合message字段,对照错误码排查问题。 |
message | 代表错误信息。可以结合code字段,对照错误码排查问题。 |
task_id | 任务ID。 |
task_status | 任务状态。有PENDING、RUNNING、SUCCEEDED和FAILED这四种状态。当任务包含多个子任务时,只要存在任一子任务成功,整个任务状态将标记为SUCCEEDED,需通过subtask_status字段判断具体子任务结果。 |
results | 子任务识别结果。 |
subtask_status | 子任务状态。有PENDING、RUNNING、SUCCEEDED和FAILED这四种状态。 |
file_url | 被识别音频的URL。 |
transcription_url | 音频识别结果对应的URL。识别结果以JSON格式保存在一个JSON文件中,您可以通过transcription_url对应的链接下载文件或直接通过HTTP请求读取该文件中的内容。JSON文件的内容请参见识别结果说明。 |
识别结果说明
识别结果保存为JSON文件。
| 参数 | 类型 | 说明 |
|---|---|---|
audio_format | string | 源文件中音频的格式。 |
channels | array[integer] | 源文件中音频的音轨索引信息,对单轨音频返回[0],对双轨音频返回[0, 1],以此类推。 |
original_sampling_rate | integer | 源文件中音频的采样率(Hz)。 |
original_duration_in_milliseconds | integer | 源文件中的原始音频时长(ms)。 |
channel_id | integer | 转写结果的音轨索引,以0为起始。 |
content_duration | integer | 音轨中被判定为语音内容的时长(ms)。 以下计费说明适用于 qwen-audio-3.0-asr-flash-filetrans。qwen-audio-3.1-asr-flash-filetrans 按 Token 计费。 |
transcript | string | 段落级别的语音转写结果。 |
sentences | array | 句子级别的语音转写结果。 |
words | array | 词级别的语音转写结果。 |
begin_time | integer | 开始时间戳(ms)。 |
end_time | integer | 结束时间戳(ms)。 |
text | string | 语音转写结果。 |
speaker_id | integer | 当前说话人的索引,以0为起始,用于区分不同的说话人。仅在启用说话人分离功能时,该字段才会显示于识别结果中。 |
punctuation | string | 预测出的词之后的标点符号(如有)。 |
关键接口
核心资源(client.audio.asr)
通过 dashscope.Client 创建客户端后,使用 client.audio.asr 资源。以下方法均返回 Job。
| 方法 | 方法签名 | 说明 |
|---|---|---|
transcribe | 提交任务并同步等待完成。默认模型为 qwen-audio-3.1-asr-flash-filetrans;调用其他模型时显式设置 model。 | |
jobs.create | 提交任务,返回包含 task_id 和 status 的 Job,不等待识别完成。 | |
jobs.wait | 传入 Job 或任务 ID,同步等待任务完成。通过 poll_interval 和 max_interval 设置初始和最大轮询间隔,通过 timeout 设置总等待时间,单位均为秒。 | |
jobs.fetch | 通过任务 ID 查询一次任务状态和结果,不阻塞等待任务完成。 |
错误码
任务失败时,默认抛出 DashScopeError。如需获取失败任务的 Job,在创建 Client 时设置 raise_on_error=False,并检查 job.status。
如遇报错问题,请参见错误码进行排查。
当任务包含多个子任务时,只要存在任一子任务成功,整个任务状态将标记为SUCCEEDED,需通过subtask_status字段判断具体子任务结果。
错误返回示例:
常见问题
功能特性
Q:是否支持Base64编码方式的音频?
不支持Base64编码方式的音频。仅支持可通过公网访问的 URL 所指向的音频的识别,不支持识别二进制流,也不支持直接识别本地文件。
Q:如何将音频文件以公网可访问的URL形式提供?
通常遵循以下几个步骤(这里为您提供一种思路,具体情况因不同存储产品而异,推荐将音频上传至阿里云OSS):
1、选择存储和托管方式
1、选择存储和托管方式
如以下这几种:
-
对象存储服务(推荐):
- 使用云服务商的对象存储服务(如阿里云OSS),将音频文件上传到存储桶中,并设置为公开访问。
- 优点:高可用性、支持 CDN 加速、易于管理。
-
Web 服务器:
- 将音频文件放置在支持 HTTP/HTTPS 访问的 Web 服务器上(如 Nginx、Apache)。
- 优点:适合小型项目或本地测试。
-
内容分发网络(CDN):
- 将音频文件托管在 CDN 上,通过 CDN 提供的 URL 访问。
- 优点:加速文件传输,适合高并发场景。
2、上传音频文件
2、上传音频文件
根据选择的存储/托管方式,将音频上传,如:
-
对象存储服务:
- 登录云服务商的控制台,创建存储桶。
- 上传音频文件,并设置文件权限为“公共读”或生成临时访问链接。
-
Web 服务器:
- 将音频文件放置在服务器指定目录下(如
/var/www/html/audio/)。 - 确保文件可以通过 HTTP/HTTPS 访问。
- 将音频文件放置在服务器指定目录下(如
3、生成公网可访问的URL
3、生成公网可访问的URL
例如:
-
对象存储服务:
- 文件上传后,系统会自动生成一个公网访问 URL(通常格式为
https://<bucket-name>.<region>.aliyuncs.com/<file-name>)。 - 如果需要更友好的域名,可以绑定自定义域名并开启 HTTPS。
- 文件上传后,系统会自动生成一个公网访问 URL(通常格式为
-
Web 服务器:
- 文件的访问 URL 通常是服务器地址加上文件路径(如
https://your-domain.com/audio/file.mp3)。
- 文件的访问 URL 通常是服务器地址加上文件路径(如
-
CDN:
- 配置 CDN 加速后,使用 CDN 提供的 URL(如
https://cdn.your-domain.com/audio/file.mp3)。
- 配置 CDN 加速后,使用 CDN 提供的 URL(如
4、验证URL的可用性
4、验证URL的可用性
公网环境下,确保生成的 URL 可以正常访问,例如:
- 在浏览器中打开 URL,检查是否能播放音频文件。
- 使用工具(如
curl或 Postman)验证 URL 是否返回正确的 HTTP 响应(状态码 200)。
oss://为前缀的临时 URL。
使用RESTful API时,若录音文件存储在阿里云OSS,支持使用以 oss://为前缀的临时 URL: