

O modelo de humano digital wan2.2-s2v gera vídeos naturais de fala, canto ou performance a partir de uma única imagem e um arquivo de áudio . Ele aceita qualquer proporção de tela e funciona com imagens de rosto, corpo inteiro ou meio corpo .
Visão geral do modelo
Exemplo de saída
| Exemplo de entrada | Vídeo de saída |
|---|---|
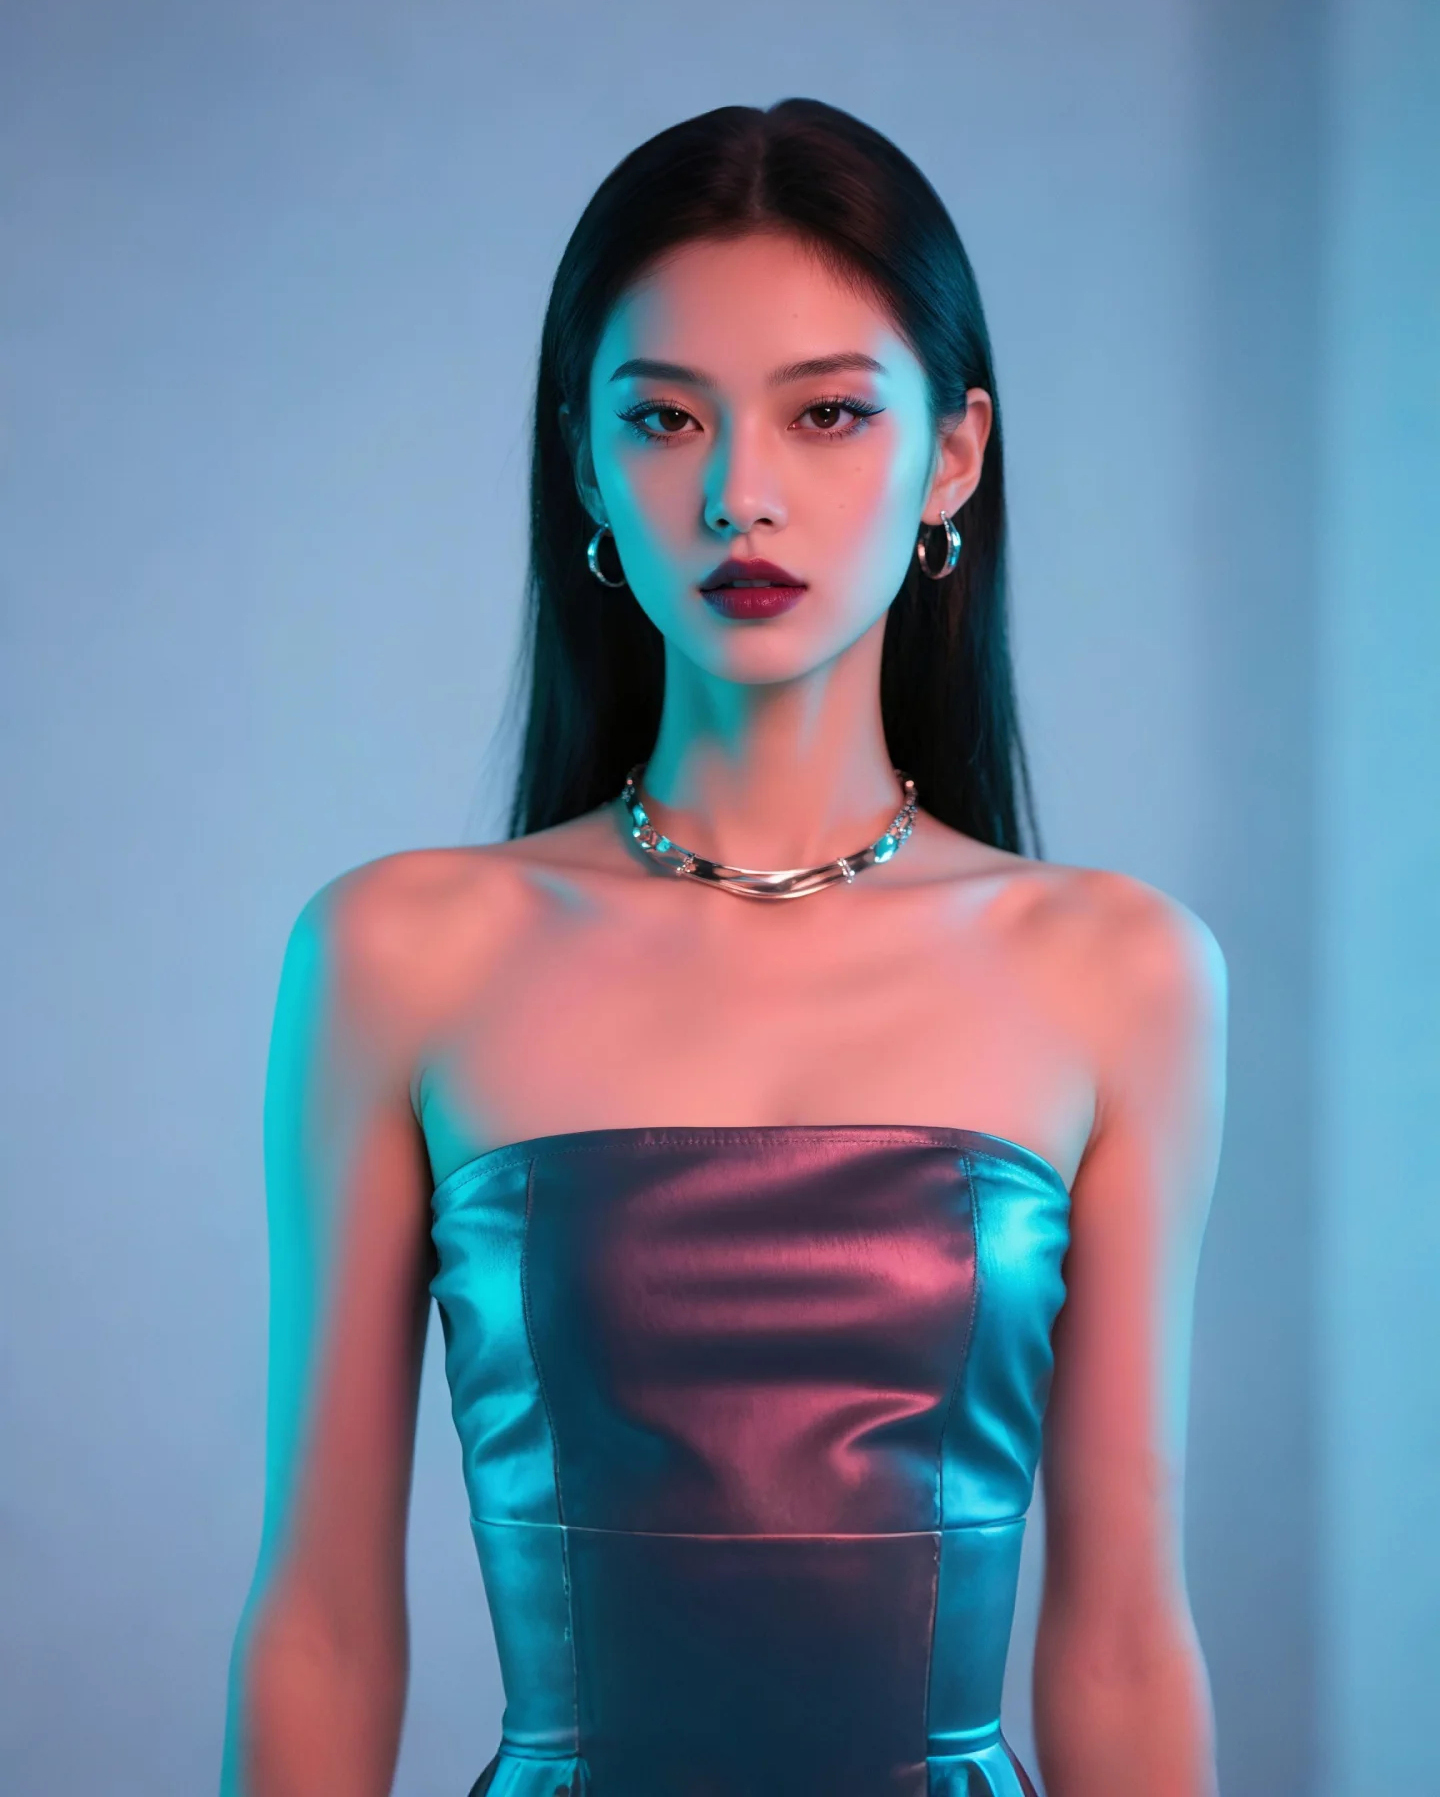 |
- Etapa 1: Chame a API wan2.2-s2v-detect com a URL da imagem para verificar a conformidade.
- Etapa 2: Se a imagem passar na validação, chame a API assíncrona wan2.2-s2v com a URL da imagem e a URL do áudio para enviar a tarefa de geração de vídeo. Em seguida, consulte o resultado periodicamente.
Primeiros passos
Pré-requisitos
Antes de chamar a API, ative o service do modelo e obtenha uma chave de API. Em seguida, defina a chave de API como uma variável de ambiente.
Código de exemplo
A imagem de exemplo neste tópico já passou pela detecção de imagem. O código abaixo demonstra a geração de vídeo.
As solicitações HTTP ocorrem em duas etapas: primeiro crie uma tarefa, depois recupere o resultado.
Etapa 1: Criar uma tarefa e obter o ID da tarefa
Esta solicitação retorna umtask_id que você pode usar para consultar o resultado.
Etapa 2: Consultar o resultado usando o ID da tarefa
Substitua86ecf553-d340-4e21-xxxxxxxxx pelo seu task_id real.
As chaves de API são diferentes para cada região. Para mais informações, consulte Obtenha uma chave de API .
Se você usar um modelo na região China (Beijing), substituabase_urlporhttps://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api/v1/tasks/86ecf553-d340-4e21-xxxxxxxxx, onde {WorkspaceId} é o ID real do seu workspace.
task_id é válido por 24 horas. Após expirar, as consultas falham e a API retorna um status UNKNOWN.