Qwen-Image API リファレンス

Qwen-Image は、複数のアートスタイルをサポートし、 複雑なテキストレンダリング に優れた汎用画像生成モデルです。複数行のレイアウト、段落レベルのテキスト生成、および詳細なディテールレンダリングに対応しています。

クイックアクセス: ユーザーガイド| オンラインで試す(シンガポール | 北京)| 技術ブログ (その他の例)

例

プロンプト

生成された画像

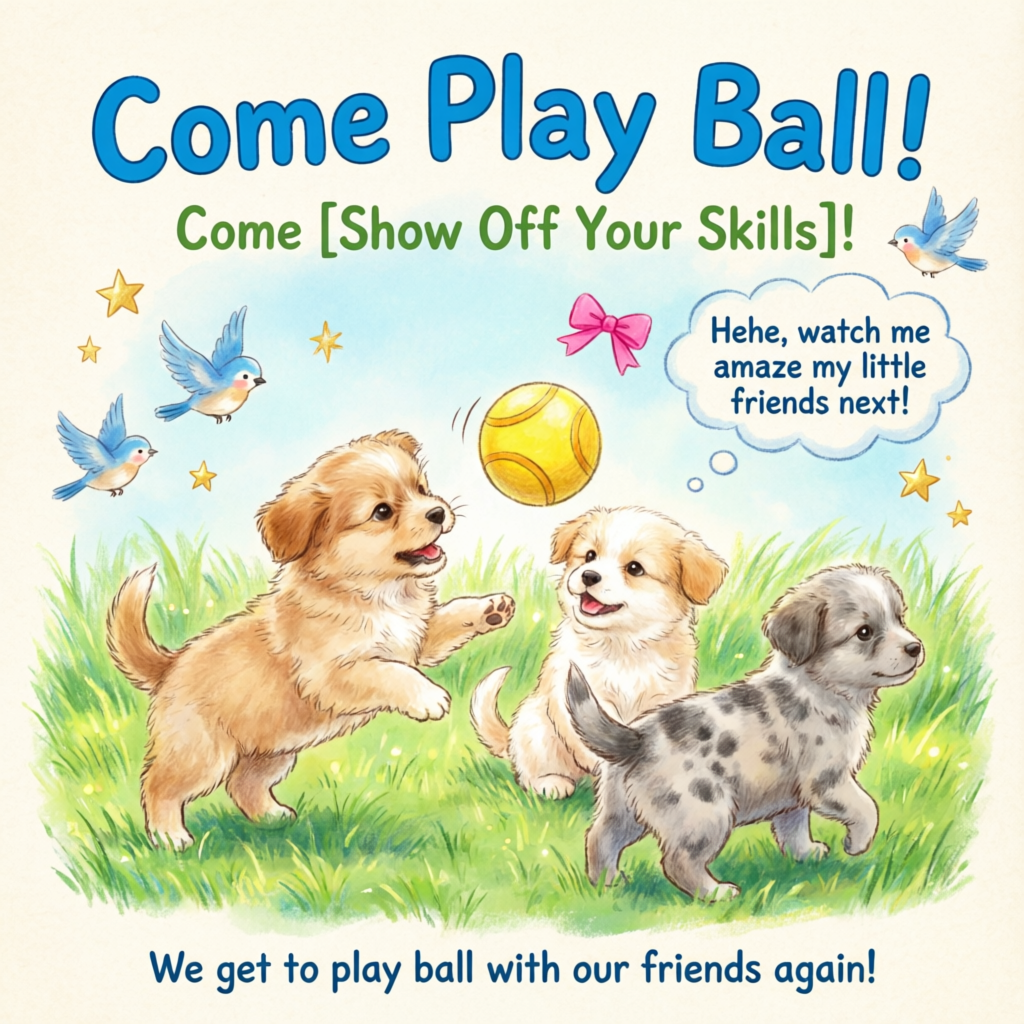
緑豊かな芝生の上で 3 匹の子犬がボールで遊んでいる、癒し系手描きポスター。鳥や星などの装飾要素が散りばめられている。メインタイトル「Come Play Ball!」が、太字の青い漫画風フォントで上部に目立つように表示されている。その下には、サブタイトル「Come [Show Off Your Skills]!」が緑色のフォントで表示されている。吹き出しには「Hehe, watch me amaze my little friends next!」というテキストが書かれており、遊び心のある魅力を加えている。下部には、「We get to play ball with our friends again!」という補足テキストが記載されている。カラーパレットは、新鮮な緑と青を中心に、明るいピンクと黄色のトーンでアクセントをつけ、陽気で子供らしい雰囲気を強調している。

image

モデル概要

モデル説明出力画像の仕様
qwen-image-2.0-pro 推奨
qwen-image-2.0-pro-2026-04-22 と同等の機能を持ちます
画像生成および編集用の Qwen プロ版シリーズ。より強力なテキストレンダリング、リアルなテクスチャ、セマンティックな忠実性を提供します。
画像編集については、「Qwen-Image Editing」をご参照ください。
解像度:幅と高さを自由に設定します。総ピクセル数は 512×512 から 2048×2048 の範囲内である必要があります。デフォルトの解像度は 2048×2048 です。フォーマット:PNG画像数:1~6
qwen-image-2.0-pro-2026-06-22 推奨
qwen-image-2.0-pro-2026-04-22
qwen-image-2.0-pro-2026-03-03
qwen-image-2.0 推奨
qwen-image-2.0-2026-03-03 と同等の機能を持ちます
画像生成および編集用の Qwen 高速化シリーズ。品質と応答速度のバランスが取れています。
画像編集については、「Qwen-Image Editing」をご参照ください。
qwen-image-2.0-2026-03-03 推奨
API を呼び出す前に、ご利用のリージョンでサポートされているモデルリストをご確認ください。

前提条件

呼び出しを行う前に、API キーを取得し、API キーを環境変数としてエクスポートしてください。SDK を使用して呼び出しを行うには、DashScope SDK をインストールする必要があります。
中国 (北京) リージョンとシンガポールリージョンでは、API キーとリクエストエンドポイントがそれぞれ異なります。これらは相互に利用することはできません。リージョンをまたいだ呼び出しは、認証の失敗やサービスエラーにつながります。

同期 API

HTTP

同期呼び出しは、1 回のリクエストで結果を返します。 シンガポール:POST https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation 北京:POST https://{WorkspaceId}.cn-beijing.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation {WorkspaceId} を実際のワークスペース ID に置き換えてください。

リクエストパラメーター

  • Text-to-Image
curl --location 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation' \
--header 'Content-Type: application/json' \
--header "Authorization: Bearer $DASHSCOPE_API_KEY" \
--data '{
    "model": "qwen-image-2.0-pro",
    "input": {
      "messages": [
        {
          "role": "user",
          "content": [
            {
              "text": "緑豊かな芝生の上で 3 匹の子犬がボールで遊んでいる、癒し系手描きポスター。鳥や星などの装飾要素が散りばめられている。メインタイトル「Come Play Ball!」が、太字の青い漫画風フォントで上部に目立つように表示されている。その下には、サブタイトル「Come [Show Off Your Skills]!」が緑色のフォントで表示されている。吹き出しには「Hehe, watch me amaze my little friends next!」というテキストが書かれており、遊び心のある魅力を加えている。下部には、「We get to play ball with our friends again!」という補足テキストが記載されている。カラーパレットは、新鮮な緑と青を中心に、明るいピンクと黄色のトーンでアクセントをつけ、陽気で子供らしい雰囲気を強調している。"
            }
          ]
        }
      ]
    },
    "parameters": {
      "negative_prompt": "低解像度、低品質、歪んだ手足、奇形の指、過飽和の色、蝋人形のような外観、顔のディテールの欠如、過度の滑らかさ、AI のようなアーティファクト、混沌とした構図、ぼやけたまたは歪んだテキスト。",
      "prompt_extend": true,
      "watermark": false,
      "size": "2048*2048"
    }
}'
リクエストヘッダー
Content-Type string (必須)リクエストのコンテンツタイプです。application/json である必要があります。
Authorization string (必須)Model Studio API キーでリクエストを認証します。例:Bearer sk-xxxx。
リクエストボディ
model string (必須)モデル名。例:qwen-image-2.0-pro。
input object (必須)入力情報。

プロパティ

messages array (必須)メッセージオブジェクトの配列。シングルターンの会話のみがサポートされているため、配列には要素を 1 つだけ含める必要があります。

プロパティ

rolestring (必須)メッセージのロール。user に設定します。contentarray (必須)メッセージコンテンツオブジェクトの配列。

プロパティ

textstring(必須)生成したい画像の内容、スタイル、構図などを記述するポジティブプロンプトです。中国語と英語をサポートしています。qwen-image-2.0 シリーズは最大 1,300 トークン、その他のモデルは最大 800 トークンを受け付けます。超過したトークンはシステムによって切り捨てられます。注:テキストフィールドは 1 つだけ許可されます。省略したり、複数指定したりするとエラーが返されます。
parameters object (任意)画像処理パラメーター。

プロパティ

negative_prompt string (任意)画像に含めたくない要素を記述するネガティブプロンプトです。中国語と英語をサポートしています。最大長は 500 文字です。超過した文字は自動的に切り捨てられます。例:低解像度、低品質、歪んだ手足、奇形の指、過飽和の色、蝋人形のような外観、顔のディテールの欠如、過度の滑らかさ、AI 生成のような見た目。混沌とした構図。ぼやけたまたは歪んだテキスト。size string (任意)出力画像の解像度。width*height の形式で指定します。qwen-image-2.0 シリーズモデル:総ピクセル数は 512×512 から 2048×2048 の範囲内である必要があります。デフォルトの解像度は 2048×2048 です。推奨解像度:
  • 2688*1536:16:9
  • 1536*2688:9:16
  • 2048*2048 (デフォルト):1:1
  • 2368*1728:4:3
  • 1728*2368:3:4
n integer (任意)出力画像の数。デフォルトは 1 です。qwen-image-2.0 シリーズモデルでは、1~6 枚の画像を選択できます。prompt_extend bool (任意)スマートなプロンプトリライトを有効にします。モデルがポジティブプロンプトを最適化します。ネガティブプロンプトには影響しません。
  • true:デフォルト。リライトを有効にします。より多様な画像コンテンツを生成するために使用します。モデルが詳細を追加します。
  • false:リライトを無効にします。画像のディテールをより厳密に制御するために使用します。最良の結果を得るには、「Text-to-Image プロンプトガイド」に基づいてプロンプトを最適化してください。
元のプロンプト (orig_prompt):座っているジンジャーキャット、楽しそうな表情、生き生きとして愛らしく、信じられないほどリアル。実際のプロンプト (actual_prompt):フォトリアリスティックな野生動物のポートレート:豊かな太陽の光を浴びた毛並みと、活気に満ちた楽しそうな表情を持つ座っているジンジャーキャット。目は好奇心と温かさで輝いている。猫の頭はわずかに傾き、耳は前方に立ち、口は満足げで生き生きとしたポーズで優しく開いており、愛らしい魅力と信じられないほどのリアルなディテールを醸し出している。柔らかい自然光が、各ひげや毛の一本一本の質感を高め、鼻先や内耳に微妙なハイライトを与えている。背景:ゴールデンアワーの柔らかくぼやけた秋の庭園。琥珀色の葉の暖かいトーン、木々から差し込むまだらな太陽の光、そして苔むした石段のかすかなヒント。構図は猫を中央の焦点として強調し、浅い被写界深度でシャープに捉えられている。スタイル:超リアルな写真、ナショナルジオグラフィックレベルのディテール、8K 解像度、Canon EOS R5、f/1.2 絞り、映画のような照明、リアルなカラーグレーディング、最小限の後処理。テキストやオーバーレイなし。
watermark bool (任意)画像の右下に「Qwen-Image」のウォーターマークを追加します。デフォルト:false。ウォーターマークのスタイル:1seed integer (任意)乱数シード。有効範囲:[0,2147483647]。同じ seed を使用すると、同様の出力が得られます。省略した場合、アルゴリズムはランダムなシードを使用します。注:画像生成は確率的です。同じ seed を使用しても、結果が異なる場合があります。

レスポンスパラメーター

  • タスク成功
  • タスク失敗
画像の URL は 24 時間のみ有効で、その後自動的にパージされます。生成された画像は速やかに保存してください。
{
    "output": {
        "choices": [
            {
                "finish_reason": "stop",
                "message": {
                    "content": [
                        {
                            "image": "https://dashscope-result-sh.oss-cn-shanghai.aliyuncs.com/xxx.png?Expires=xxx"
                        }
                    ],
                    "role": "assistant"
                }
            }
        ]
    },
    "usage": {
        "height": 2048,
        "image_count": 1,
        "width": 2048
    },
    "request_id": "d0250a3d-b07f-49e1-bdc8-6793f4929xxx"
}
output objectタスクの出力情報。

プロパティ

choices arrayモデルの出力。この配列には要素が 1 つだけ含まれます。

プロパティ

finish_reason stringタスクが停止した理由。自然な停止の場合、値は stop です。message objectモデルの応答メッセージ。

プロパティ

rolestringメッセージのロール。固定値:assistant。contentarray

プロパティ

image string生成された画像の URL (PNG フォーマット)。24 時間後に有効期限が切れます。速やかにダウンロードして保存してください。
task_metric objectタスク結果の統計。qwen-image-2.0 シリーズモデルでは返されません。

プロパティ

TOTAL integerタスクの総数。SUCCEEDED integer成功したタスクの数。FAILED integer失敗したタスクの数。
usage object
同期 ImageSynthesis SDK 呼び出しでは、このフィールドは返されません。
出力統計。成功した結果のみをカウントします。

プロパティ

image_count integer生成された画像の数。qwen-image-2.0 シリーズモデルの場合、リクエストされた n (1~6) と等しくなります。width integer生成された画像の幅 (ピクセル単位)。height integer生成された画像の高さ (ピクセル単位)。
request_id stringトレースとトラブルシューティングのためのユニークなリクエスト識別子。
code stringエラーコード。失敗したリクエストに対してのみ返されます。「エラーコード」をご参照ください。
message string詳細なエラーメッセージ。失敗したリクエストに対してのみ返されます。「エラーコード」をご参照ください。

DashScope SDK の呼び出し

DashScope SDK は Python と Java をサポートしています。 SDK のパラメーター名は HTTP パラメーターとほぼ一致しており、パラメーター構造は言語固有の規則に従います。同期呼び出しのパラメーターについては、「HTTP」をご参照ください。
  • Python
  • Java
実行時エラーを避けるために、最新の DashScope Python SDK をインストールしてください:SDK のインストール。
リクエストの例
import json
import os
import dashscope
from dashscope import MultiModalConversation

# シンガポールリージョン。{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'

messages = [
    {
        "role": "user",
        "content": [
            {"text": "緑豊かな芝生の上で 3 匹の子犬がボールで遊んでいる、癒し系手描きポスター。鳥や星などの装飾要素が散りばめられている。メインタイトル「Come Play Ball!」が、太字の青い漫画風フォントで上部に目立つように表示されている。その下には、サブタイトル「Come [Show Off Your Skills]!」が緑色のフォントで表示されている。吹き出しには「Hehe, watch me amaze my little friends next!」というテキストが書かれており、遊び心のある魅力を加えている。下部には、「We get to play ball with our friends again!」という補足テキストが記載されている。カラーパレットは、新鮮な緑と青を中心に、明るいピンクと黄色のトーンでアクセントをつけ、陽気で子供らしい雰囲気を強調している。"}
        ]
    }
]

# API キーは北京リージョンとシンガポールリージョンで異なります。API キーの取得: https://www.alibabacloud.com/help/model-studio/get-api-key
# 環境変数を設定していない場合は、以下の行を api_key="sk-xxx" に置き換えてください。
api_key = os.getenv("DASHSCOPE_API_KEY")

response = MultiModalConversation.call(
    api_key=api_key,
    model="qwen-image-2.0-pro",
    messages=messages,
    result_format='message',
    stream=False,
    watermark=False,
    prompt_extend=True,
    negative_prompt="低解像度、低品質、歪んだ手足、奇形の指、過飽和の色、蝋人形のような外観、顔のディテールの欠如、過度の滑らかさ、AI のようなアーティファクト、混沌とした構図、ぼやけたまたは歪んだテキスト。",
    size='2048*2048'
)

if response.status_code == 200:
    print(json.dumps(response, ensure_ascii=False))
else:
    print(f"HTTP ステータスコード: {response.status_code}")
    print(f"エラーコード: {response.code}")
    print(f"エラーメッセージ: {response.message}")
    print("ドキュメントを参照してください: https://www.alibabacloud.com/help/model-studio/error-code")
レスポンスの例
画像の URL は 24 時間後に有効期限が切れます。速やかに画像をダウンロードしてください。
{
    "status_code": 200,
    "request_id": "d2d1a8c0-325f-9b9d-8b90-xxxxxx",
    "code": "",
    "message": "",
    "output": {
        "text": null,
        "finish_reason": null,
        "choices": [
            {
                "finish_reason": "stop",
                "message": {
                    "role": "assistant",
                    "content": [
                        {
                            "image": "https://dashscope-result-wlcb.oss-cn-wulanchabu.aliyuncs.com/xxx.png?Expires=xxx"
                        }
                    ]
                }
            }
        ]
    }
}

OpenAI Agents SDK との使用

Qwen-Image などの画像生成モデルは、DashScope ネイティブ API を通じて呼び出され、OpenAI 互換モード (compatible-mode) をサポートしていないため、OpenAI Agents SDK のエージェントの推論モデルとして直接使用することはできません。 OpenAI Agents SDK などのエージェントフレームワークでは、画像生成をツール (関数ツール) としてラップし、OpenAI 互換モードをサポートするテキストチャットモデル (qwen-plus など) をエージェントの推論コアとして機能させ、それをオーケストレーションさせることができます。例: 実行する前に、依存関係をインストールします:pip install openai-agents dashscope。
import os
import asyncio
import dashscope
from openai import AsyncOpenAI
from dashscope import MultiModalConversation
from agents import Agent, Runner, function_tool, OpenAIChatCompletionsModel

# 環境変数から Model Studio API キーを読み込む
# (または api_key="sk-xxx" に置き換える)
API_KEY = os.getenv("DASHSCOPE_API_KEY")

# シンガポールリージョン。{WorkspaceId} を実際のワークスペース ID に置き換えてください。URL はリージョンによって異なります。
dashscope.base_http_api_url = "https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1"
# テキストチャットモデル (エージェントの推論コア) は、OpenAI 互換モードを介してアクセスされます
client = AsyncOpenAI(api_key=API_KEY, base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1")

# 画像生成をエージェントが呼び出すための関数ツールとしてラップする
@function_tool
def generate_image(prompt: str) -> str:
    """テキスト記述から画像を生成し、その URL を返します。prompt: 画像のテキスト記述。"""
    rsp = MultiModalConversation.call(
        api_key=API_KEY,
        model="qwen-image-2.0-pro",
        messages=[{"role": "user", "content": [{"text": prompt}]}],
        result_format="message",
    )
    if rsp.status_code != 200:
        return f"生成に失敗しました: {rsp.code} {rsp.message}"
    return rsp.output.choices[0].message.content[0]["image"]

agent = Agent(
    name="画像アシスタント",
    instructions="あなたは画像生成アシスタントです。ユーザーが画像を求めたら、generate_image ツールを呼び出し、画像の URL をユーザーに返してください。",
    model=OpenAIChatCompletionsModel(model="qwen-plus", openai_client=client),
    tools=[generate_image],
)

async def main():
    result = await Runner.run(agent, "芝生の上を走るコーギーを描いて")
    print(result.final_output)

if __name__ == "__main__":
    asyncio.run(main())

課金とレート制限

  • 無料クォータと料金については、「モデル料金」をご参照ください。
  • レート制限については、「Qwen-Image」をご参照ください。
  • 課金の詳細:正常に生成された各画像に対して課金されます。失敗した呼び出しや処理エラーは、料金が発生したり、新規ユーザーの無料クォータを消費したりすることはありません。

エラーコード

モデルの呼び出しが失敗し、エラーメッセージが返された場合は、「エラーコード」で解決策をご確認ください。

よくある質問

Q: prompt_extend パラメーターは有効にすべきですか、それとも無効にすべきですか?

A: より多様な画像コンテンツを求め、モデルに詳細を追加させたい場合は、このオプションを有効にしてください (デフォルト)。画像のディテールをより厳密に制御する必要がある場合は無効にし、「Text-to-Image プロンプトガイド」を使用してプロンプトを最適化してください。

Q: qwen-image-2.0 シリーズの違いは何ですか?

A:
  • 画像生成と編集の統合モデル:Text-to-Image と画像編集の両方をサポートします。
    • qwen-image-2.0-pro と qwen-image-2.0-pro-2026-03-03:同等の機能を持ちます。プロ版シリーズは、よりプロフェッショナルなテキストレンダリング、より細かいリアルなテクスチャ、詳細なリアルなシーン、そしてより強力なセマンティックな忠実性を提供します。同期呼び出しのみをサポートします。
    • qwen-image-2.0 と qwen-image-2.0-2026-03-03:同等の機能を持ちます。高速化バージョンは、モデルのパフォーマンスと品質のバランスを取ります。同期呼び出しのみをサポートします。

Q: 画像ストレージのドメイン名ホワイトリストを取得するにはどうすればよいですか?

A: モデルによって生成された画像は OSS に保存されます。API は一時的な公開 URL を返します。このダウンロード URL のファイアウォールホワイトリストを設定するには、次の点にご注意ください:基盤となるストレージは動的に変更される可能性があります。このトピックでは、古い情報によるアクセス問題を避けるため、固定の OSS ドメイン名ホワイトリストは提供していません。セキュリティ管理要件がある場合は、アカウントマネージャーに連絡して最新の OSS ドメイン名リストを入手してください。