

このトピックでは、Fun-ASR 非リアルタイム音声認識 Java SDK のパラメーターと API の詳細について説明します。
サポートされている音声フォーマット、ファイルサイズの制限、持続時間の制限などの入力要件については、「音声仕様」をご参照ください。
コアクラス (Transcription) は、タスクを非同期で送信し、タスクが完了するまで同期的に待機し、タスク結果を非同期でクエリするためのインターフェイスを提供します。非リアルタイム音声認識は、次の 2 つの方法のいずれかで実行できます。
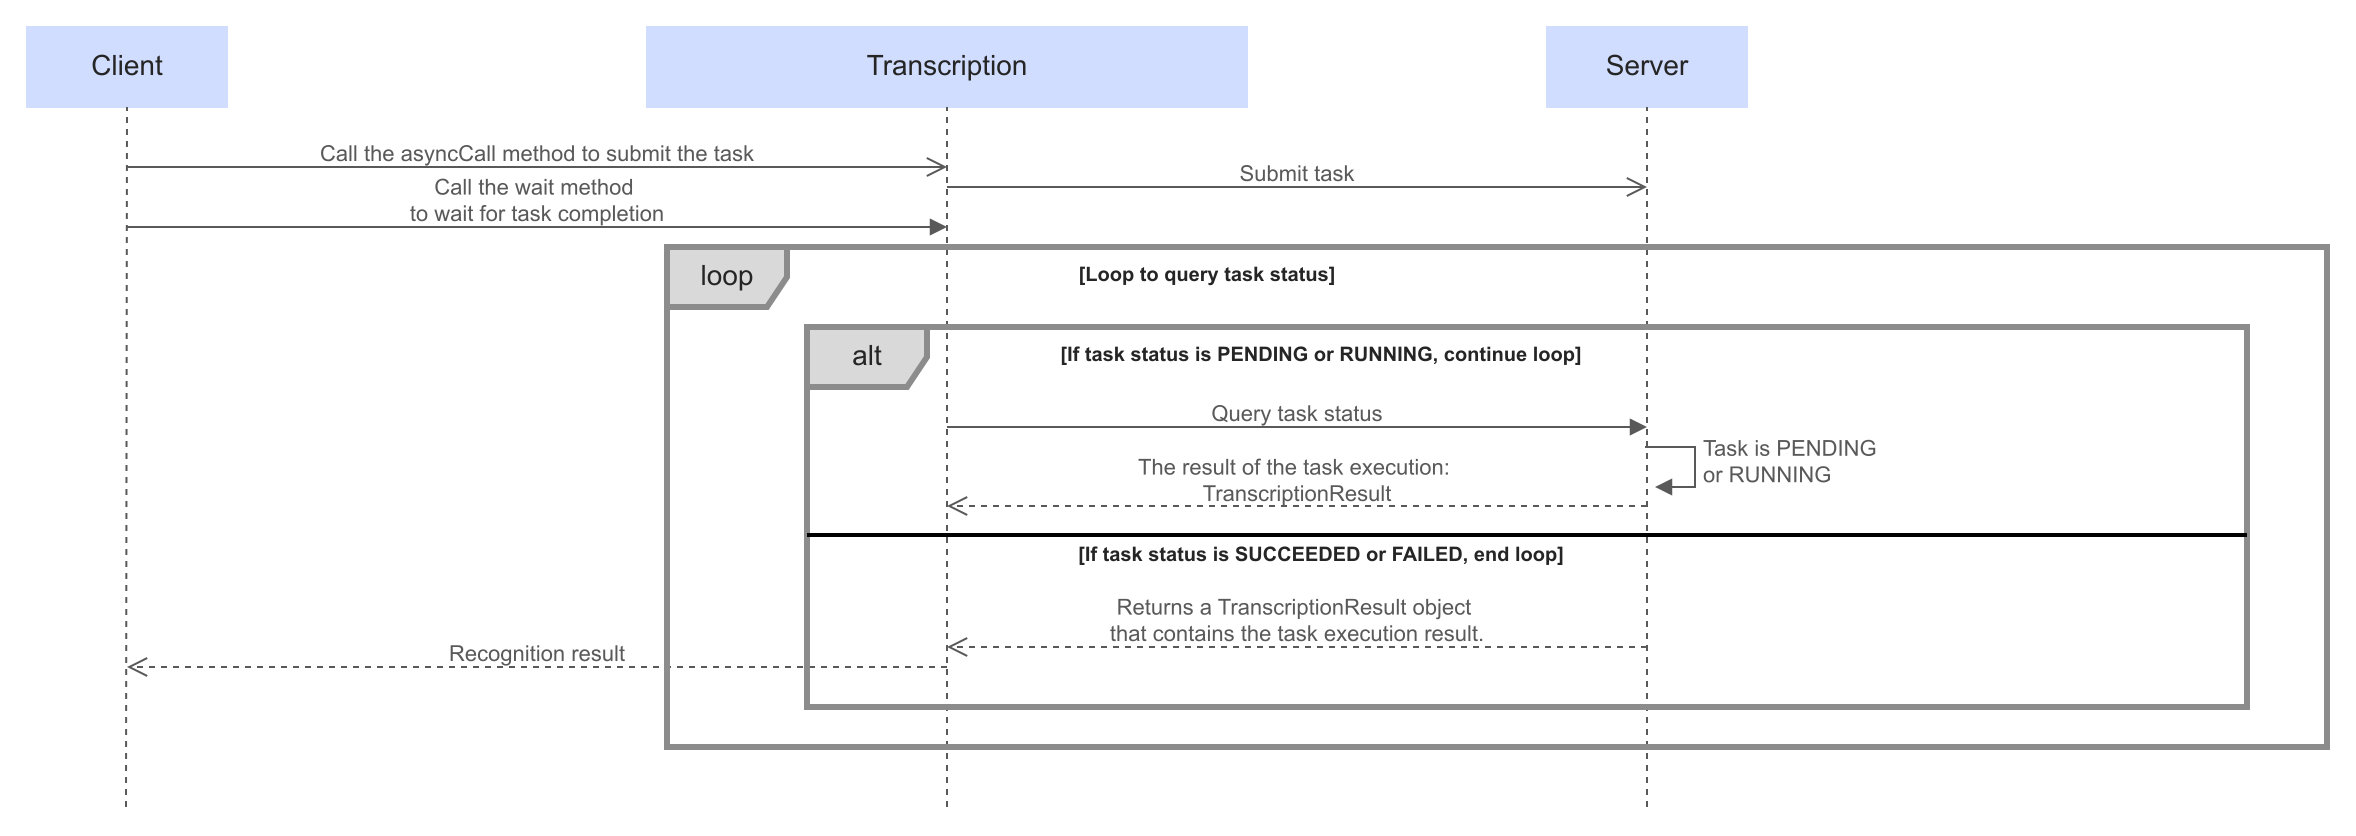
デフォルトでは、SDK は中国 (北京) リージョンのエンドポイントを使用します。他のリージョンに切り替えるには、初期化の前に
注:
認識結果は JSON ファイルとして保存されます。
以下のパラメーターは注目に値します:
エラーが発生した場合は、「エラーコード」を参照してトラブルシューティングを行ってください。
タスクに複数のサブタスクが含まれている場合、少なくとも 1 つのサブタスクが成功すれば、全体のタスクステータスは
Base64 エンコードされた音声はサポートされていません。パブリックアクセス可能な URL にある音声のみが認識可能です。バイナリストリームやローカルファイルは直接認識できません。
一般的な手順は次のとおりです。これは 1 つのアプローチであり、正確なプロセスはストレージ製品によって異なります。音声を Alibaba Cloud OSS にアップロードすることを推奨します:
SDK を使用する場合、音声ファイルが Alibaba Cloud OSS に保存されている場合、
タスクが送信されると、キュー登録済み (PENDING) 状態になります。キューイング時間はキューの長さと音声の持続時間に依存するため、正確には言えませんが、通常は数分以内です。一般的に、音声が長いほど時間がかかります。
コードがエラーを返した場合、「エラーコード」の情報に基づいてトラブルシューティングを行ってください。
これはスロットリングが原因である可能性があります。しばらく待ってから再試行してください。
音声フォーマットとサンプルレートが正しく、パラメーターの制約を満たしていることを確認してください。
ffprobe ツールを使用して、音声コンテナ、コーデック、サンプルレート、チャンネル、その他の詳細を取得します:
前提条件
- サービスを有効化し、「API キーの取得」を完了していること。コードの漏洩によるセキュリティリスクを防ぐため、コードにハードコーディングするのではなく、「API キーを環境変数として設定」してください。
- 最新の DashScope SDK をインストールする。
クイックスタート
コアクラス (Transcription) は、タスクを非同期で送信し、タスクが完了するまで同期的に待機し、タスク結果を非同期でクエリするためのインターフェイスを提供します。非リアルタイム音声認識は、次の 2 つの方法のいずれかで実行できます。
- タスクの非同期送信と同期的な完了待機:タスクを送信すると、現在のスレッドはタスクが完了して認識結果が返されるまでブロックされます。
- タスクの非同期送信とタスク結果の非同期クエリ:タスクを送信した後、必要なときにクエリインターフェイスを呼び出してタスク結果を取得します。
- タスクの非同期送信と同期的な完了待機
- タスクの非同期送信とタスク結果の非同期クエリ
- リクエストパラメーターを設定します。
- コアクラス (Transcription) をインスタンス化します。
-
コアクラス (Transcription) の
asyncCallメソッドを呼び出して、タスクを非同期で送信します。- ファイル文字起こしサービスは、API を通じて送信されたタスクをベストエフォート方式で処理します。タスクを送信すると、キュー登録済み (
PENDING) 状態になります。キューイング時間はキューの長さとファイルの持続時間に依存するため、正確には言えませんが、通常は数分以内です。処理が開始されると、音声認識はリアルタイムの数百倍の速度で完了します。 - 各タスクが完了した後、認識結果とダウンロード URL は 24 時間有効です。有効期限が切れると、以前のクエリで返された URL を通じてタスクをクエリしたり、結果をダウンロードしたりすることはできなくなります。
- ファイル文字起こしサービスは、API を通じて送信されたタスクをベストエフォート方式で処理します。タスクを送信すると、キュー登録済み (
-
コアクラス (Transcription) の
waitメソッドを呼び出して、タスクが完了するまで同期的に待機します。 タスクの状態には、PENDING、RUNNING、SUCCEEDED、またはFAILEDがあります。タスクがPENDINGまたはRUNNING状態の間、waitインターフェイスはブロックします。タスクがSUCCEEDEDまたはFAILED状態に達すると、waitインターフェイスはブロックを停止し、タスク結果を返します。waitは タスク結果 (TranscriptionResult) を返します。
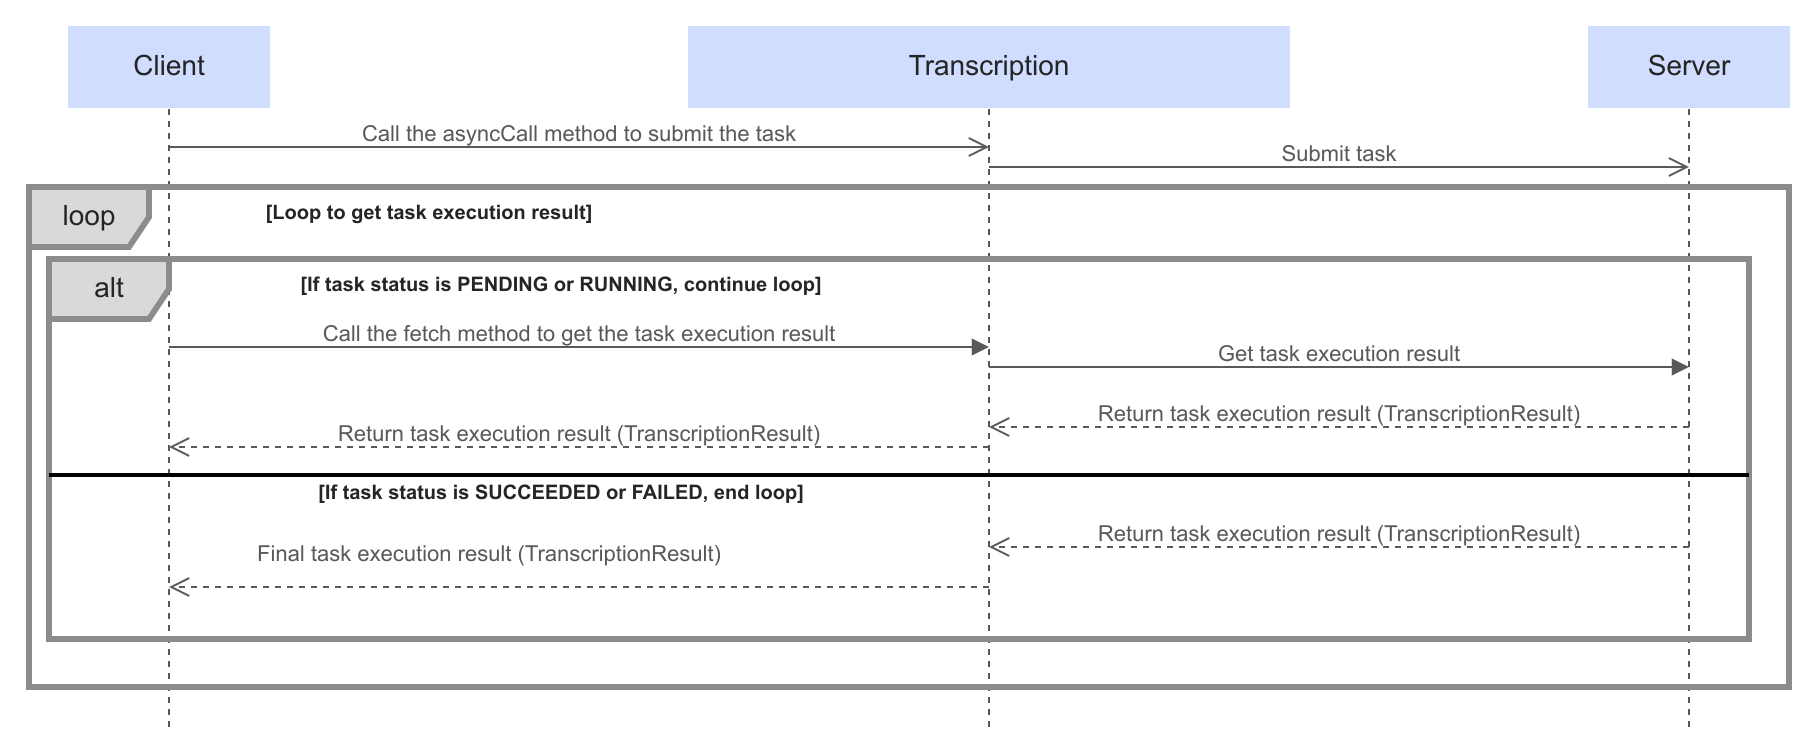
エンドポイント
デフォルトでは、SDK は中国 (北京) リージョンのエンドポイントを使用します。他のリージョンに切り替えるには、初期化の前に Constants.baseHttpApiUrl を変更します。
- シンガポール
- 中国 (北京)
https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1呼び出しを行う際に、{WorkspaceId} を実際の ワークスペース ID に置き換えてください。- API キーはリージョンごとに異なります。対象リージョンの API キーを使用していることを確認してください。
- リージョン設定はグローバルであり、すべての DashScope SDK の API 呼び出しに影響します。
リクエストパラメーター
TranscriptionParam のチェーンメソッドを使用してリクエストパラメーターを設定します。
| パラメーター | タイプ | 必須 | 説明 |
|---|---|---|---|
model | String | はい | モデル名。 |
fileUrls | List<String> | はい | 文字起こしする音声または動画ファイルの URL のリスト。HTTP と HTTPS がサポートされています。1 回のリクエストでサポートされる URL は 1 つだけです。サポートされている音声フォーマット、ファイルサイズの制限、持続時間の制限などの入力要件については、「音声仕様」をご参照ください。録音が Alibaba Cloud OSS に保存されている場合、RESTful API は oss:// で始まる一時 URL をサポートしますが、SDK は oss:// で始まる一時 URL をサポートしません。 |
vocabularyId | String | いいえ | プリコンパイルされたホットワードリストの ID。この ID は、ホットワードリスト作成 API を呼び出して事前に生成します。認識時に ID を渡して、リスト内のホットワードを使用します。語彙が既知で比較的安定しており、リクエスト間で同じ単語リストを再利用する必要があるシナリオに適しています。使用方法の詳細については、「プリコンパイルホットワード」をご参照ください。 |
vocabulary | Map<String, Integer> | いいえ | インスタントホットワード。キーをホットワードの文字列(string)、値を整数の重み(integer)とするキーバリューペアを渡します。事前にホットワードリストを作成する必要はありません。使用方法については、インスタントホットワードをご参照ください。TranscriptionParam インスタンスの parameter メソッドまたは parameters メソッドを介して vocabulary を設定します: |
channelId | List<Integer> | いいえ | マルチトラック音声ファイルで認識するオーディオトラックのインデックス。インデックスは 0 から始まります。たとえば、[0] は最初のトラックを認識し、[0, 1] は最初のトラックと 2 番目のトラックを同時に認識します。このパラメーターを省略すると、最初のトラックのみが処理されます。デフォルト値:[0]。 |
specialWordFilter | String | いいえ | 音声認識中に処理する禁止用語。禁止用語ごとに異なる処理方法を設定できます。詳細については、「禁止用語フィルター」をご参照ください。 |
diarizationEnabled | Boolean | いいえ | 話者ダイアライゼーションを有効にするかどうか。デフォルトでは無効です。モノラル音声にのみ適用されます。マルチチャンネル音声は話者ダイアライゼーションをサポートしていません。有効にすると、認識結果に異なる話者を区別する speaker_id フィールドが含まれます。話者ダイアライゼーションを有効にする場合、音声の持続時間を 2 時間以内にしてください。そうしないと、認識が失敗したり、タイムアウトしたりする可能性があります。 speaker_id の例については、「認識結果の説明」をご参照ください。 |
speakerCount | Integer | いいえ | 話者数の参照値。有効な範囲は 2 から 100 までの整数 (両端を含む) です。デフォルトでは、話者数は自動的に検出されます。この値を設定すると、アルゴリズムが可能な場合に指定された数を出力するようにガイドするだけであり、正確な数を保証するものではありません。デフォルト値なし。 |
language_hints | String[] | いいえ | 認識する言語コード。事前に言語を特定できない場合は、設定せずにそのままにしておくと、モデルが自動的に言語を検出します。最大 1 個の値を指定できます。それ以上指定した場合は、最初の 1 個だけが有効です。
サポートされている言語コードを表示
TranscriptionParam インスタンスの parameter メソッドまたは parameters メソッドを介して language_hints を設定します: |
apiKey | String | いいえ | ご利用の API キー。API キーを環境変数として設定している場合は、コードで設定する必要はありません。そうでない場合は、コードで設定する必要があります。 |
応答
タスク結果 (TranscriptionResult)
TranscriptionResult は、現在のタスクの結果をカプセル化します。
| インターフェイス/メソッド | パラメーター | 戻り値 | 説明 |
|---|---|---|---|
| なし | requestId | requestId を取得します。 | |
| なし | taskId | taskId を取得します。 | |
| なし | TaskStatus、タスクステータス | タスクステータスを取得します。TaskStatus は列挙型です。次の 4 つの状態にのみ注目する必要があります:PENDING、RUNNING、SUCCEEDED、FAILED。タスクに複数のサブタスクが含まれている場合、いずれか 1 つのサブタスクが成功すれば、全体のタスクステータスは SUCCEEDED とマークされます。個々のサブタスクの結果を確認するには、subtask_status フィールドを使用してください。 | |
| なし | サブタスク結果 (TranscriptionTaskResult) | サブタスク結果 (TranscriptionTaskResult) を取得します。各タスクは 1 つ以上の音声ファイルを認識します。異なる音声ファイルは別々のサブタスクで処理されるため、各タスクは 1 つ以上のサブタスクに対応します。 | |
| なし | タスク結果、JSON 形式 | タスク結果を取得します。結果は JSON 形式のデータです。getOutput インターフェイスを介してタスク結果を取得したい場合は、結果を取得した後に自分で解析してください。
JSON の例を表示 成功例 codeはエラーコード、messageはエラーメッセージです。これらの 2 つのフィールドはエラーが発生した場合にのみ表示されます。これらを エラーコード と共に使用して、問題をトラブルシューティングできます。 |
サブタスク結果 (TranscriptionTaskResult)
TranscriptionTaskResult はサブタスクの結果をカプセル化します。サブタスクは単一の音声ファイルを認識します。
| インターフェイス/メソッド | パラメーター | 戻り値 | 説明 |
|---|---|---|---|
| なし | 認識された音声ファイルの URL | 認識された音声ファイルの URL を取得します。 | |
| なし | 認識結果の URL | 認識結果の URL を取得します。この URL は 24 時間有効です。有効期限が切れると、以前のクエリで返された URL を通じてタスクをクエリしたり、結果をダウンロードしたりすることはできなくなります。認識結果は JSON ファイルとして保存されます。URL を通じてファイルをダウンロードするか、HTTP リクエストを介して直接その内容を読み取ることができます。JSON データ内の各フィールドの意味については、「認識結果の説明」をご参照ください。 | |
| なし | TaskStatus、サブタスクステータス | サブタスクステータスを取得します。TaskStatus は列挙型です。次の 4 つの状態にのみ注目する必要があります:PENDING、RUNNING、SUCCEEDED、FAILED。 | |
| なし | タスク実行中に生成された主要な情報。空の場合があります | タスク実行中に生成された主要な情報を取得します。タスクが失敗した場合、原因を分析するためにこの内容を確認してください。 |
認識結果の説明
認識結果は JSON ファイルとして保存されます。
| パラメーター | タイプ | 説明 |
|---|---|---|
audio_format | string | ソースファイルの音声フォーマット。 |
channels | array[integer] | ソースファイル内の音声のトラックインデックス。シングルトラック音声の場合は [0]、デュアルトラック音声の場合は [0, 1] が返されます。 |
original_sampling_rate | integer | ソースファイル内の音声のサンプルレート (Hz)。 |
original_duration_in_milliseconds | integer | ソースファイル内の元の音声の持続時間 (ms)。 |
channel_id | integer | 文字起こし結果のトラックインデックス。0 から始まります。 |
content_duration | integer | 音声として識別されたトラック内のコンテンツの持続時間 (ms)。音声認識モデルサービスは、音声として識別されたトラック内のコンテンツのみを文字起こしし、その持続時間に基づいて従量課金します。非音声コンテンツは従量課金されません。通常、音声コンテンツの持続時間は元の音声の持続時間よりも短くなります。音声コンテンツが存在するかどうかは AI モデルによって決定されるため、結果は実際の状況と若干異なる場合があります。 |
transcript | string | 段落レベルの文字起こし結果。 |
sentences | array | 文レベルの文字起こし結果。 |
words | array | 単語レベルの文字起こし結果。 |
begin_time | integer | 開始タイムスタンプ (ms)。 |
end_time | integer | 終了タイムスタンプ (ms)。 |
text | string | 文字起こし結果。 |
speaker_id | integer | 現在の話者のインデックス。0 から始まり、異なる話者を区別するために使用されます。このフィールドは、話者ダイアライゼーションが有効な場合にのみ認識結果に表示されます。 |
punctuation | string | 単語の後に予測される句読点 (もしあれば)。 |
主要なインターフェイス
タスククエリパラメータークラス (TranscriptionQueryParam)
TranscriptionQueryParam は、タスクの完了を待機する場合 (Transcription の wait メソッドを呼び出す) や、タスク結果をクエリする場合 (Transcription の fetch メソッドを呼び出す) に使用されます。
静的メソッド FromTranscriptionParam を介して TranscriptionQueryParam インスタンスを作成します。
| インターフェイス/メソッド | パラメーター | 戻り値 | 説明 |
|---|---|---|---|
| TranscriptionQueryParam インスタンス | TranscriptionQueryParam インスタンスを作成します。 |
コアクラス (Transcription)
import com.alibaba.dashscope.audio.asr.transcription.*;で Transcription をインポートします。その主要なインターフェイスは次のとおりです:
| インターフェイス/メソッド | パラメーター | 戻り値 | 説明 |
|---|---|---|---|
param:音声認識パラメーター、TranscriptionParam インスタンス | タスク結果 (TranscriptionResult) | 音声認識タスクを非同期で送信します。 | |
queryParam:TranscriptionQueryParam インスタンス | タスク結果 (TranscriptionResult) | 非同期タスクが終了するまで (タスクステータスが SUCCEEDED または FAILED になるまで) 現在のスレッドをブロックします。 | |
queryParam:TranscriptionQueryParam インスタンス | タスク結果 (TranscriptionResult) | 現在のタスク結果を非同期でクエリします。 |
エラーコード
エラーが発生した場合は、「エラーコード」を参照してトラブルシューティングを行ってください。
タスクに複数のサブタスクが含まれている場合、少なくとも 1 つのサブタスクが成功すれば、全体のタスクステータスは SUCCEEDED とマークされます。各サブタスクの結果を判断するには、subtask_status フィールドを確認してください。
エラー応答の例:
よくある質問
機能
Q:Base64 エンコードされた音声はサポートされていますか?
Base64 エンコードされた音声はサポートされていません。パブリックアクセス可能な URL にある音声のみが認識可能です。バイナリストリームやローカルファイルは直接認識できません。
Q:音声ファイルをパブリックアクセス可能な URL で利用できるようにするにはどうすればよいですか?
一般的な手順は次のとおりです。これは 1 つのアプローチであり、正確なプロセスはストレージ製品によって異なります。音声を Alibaba Cloud OSS にアップロードすることを推奨します:
1. ストレージとホスティング方法の選択
1. ストレージとホスティング方法の選択
例:
-
オブジェクトストレージサービス (推奨):
- クラウドプロバイダーのオブジェクトストレージサービス (例:Alibaba Cloud OSS) を使用して、音声ファイルをバケットにアップロードし、パブリックアクセスに設定します。
- 利点:高可用性、CDN アクセラレーションのサポート、および簡単な管理。
-
Web サーバー:
- HTTP/HTTPS アクセスをサポートする Web サーバー (Nginx や Apache など) に音声ファイルを配置します。
- 利点:小規模なプロジェクトやローカルテストに適しています。
-
コンテンツデリバリーネットワーク (CDN):
- CDN 上で音声ファイルをホストし、CDN が提供する URL を介してアクセスします。
- 利点:ファイル配信を高速化し、高同時実行シナリオに適しています。
2. 音声ファイルのアップロード
2. 音声ファイルのアップロード
選択したストレージまたはホスティング方法に従って音声をアップロードします。例:
-
オブジェクトストレージサービス:
- クラウドプロバイダーのコンソールにログインし、バケットを作成します。
- 音声ファイルをアップロードし、その権限をパブリック読み取りに設定するか、一時的なアクセスリンクを生成します。
-
Web サーバー:
- サーバー上の指定されたディレクトリ (例:
/var/www/html/audio/) に音声ファイルを配置します。 - ファイルが HTTP/HTTPS 経由でアクセス可能であることを確認します。
- サーバー上の指定されたディレクトリ (例:
3. パブリックアクセス可能な URL の生成
3. パブリックアクセス可能な URL の生成
例:
-
オブジェクトストレージサービス:
- ファイルがアップロードされると、システムは自動的にパブリックアクセス URL を生成します (通常は
https://<bucket-name>.<region>.aliyuncs.com/<file-name>の形式)。 - より分かりやすいドメイン名にするには、カスタムドメインをバインドして HTTPS を有効にします。
- ファイルがアップロードされると、システムは自動的にパブリックアクセス URL を生成します (通常は
-
Web サーバー:
- アクセス URL は通常、サーバーアドレスとファイルパスを組み合わせたものです (例:
https://your-domain.com/audio/file.mp3)。
- アクセス URL は通常、サーバーアドレスとファイルパスを組み合わせたものです (例:
-
CDN:
- CDN アクセラレーションを設定した後、CDN が提供する URL を使用します (例:
https://cdn.your-domain.com/audio/file.mp3)。
- CDN アクセラレーションを設定した後、CDN が提供する URL を使用します (例:
4. URL が機能することの確認
4. URL が機能することの確認
生成された URL がパブリックネットワーク経由でアクセス可能であることを確認します。例:
- ブラウザで URL を開き、音声ファイルが再生されるかどうかを確認します。
- ツール (例:
curlや Postman) を使用して、URL が正しい HTTP 応答 (ステータスコード 200) を返すことを確認します。
oss:// プレフィックスを持つ一時 URL はサポートされません。
RESTful API を使用する場合、音声ファイルが Alibaba Cloud OSS に保存されている場合、oss:// プレフィックスを持つ一時 URL はサポートされます:
- 一時 URL は 48 時間有効で、有効期限が切れると使用できなくなります。本番環境では使用しないでください。
- アップロード認証情報を取得するための API は 100 QPS に制限されており、スケールアウトはサポートされていません。本番環境、高同時実行シナリオ、またはストレステストシナリオでは使用しないでください。
- 本番環境では、ファイルの長期的な可用性を確保し、レート制限の問題を回避するために、OSS などの安定したストレージサービスを使用してください。